DeepSeek AI II
🌸 DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
闭源模型与开源模型之间的性能差距似乎并未收敛,反而呈现扩大趋势。作者识别出限制开源模型复杂任务能力的三个关键不足
- 在架构层面,模型普遍依赖标准注意力机制,这严重制约长序列处理的效率。这种低效性对规模化部署和有效的后训练均构成重大障碍
- 在资源分配方面,开源模型在后训练阶段的计算投入不足,限制其在高难度任务上的表现
- 在 AI 智能体场景中,开源模型的泛化能力和指令遵循能力明显落后于闭源专有模型,从而制约其在实际部署中的有效性
首先引入 DSA,这是一种旨在显著降低计算复杂度的高效注意力机制。该架构有效缓解效率瓶颈,即使在长上下文场景中也能保持模型性能;提出一套稳定且可扩展的强化学习训练方案,使后训练阶段的计算投入能够大幅扩展;培养模型在工具使用场景中可泛化的推理能力,采用 DeepSeek-V3 的方法开展冷启动,将推理与工具使用统一到同一条轨迹中。随后,开展大规模智能体任务合成,生成超过 1,800 个不同的环境以及 85,000 条复杂提示。这些大规模合成数据用于驱动强化学习过程,显著增强模型在智能体场景中的泛化能力和指令遵循能力
🍄 DeepSeek-V3.2 Architecture
DeepSeek-V3.2 采用与 DeepSeek-V3.2-Exp 完全相同的架构。相较于 DeepSeek-V3.1 的最终版本 DeepSeek-V3.1-Terminus,DeepSeek-V3.2 在架构上的唯一改动,是通过持续训练引入 DeepSeek 稀疏注意力
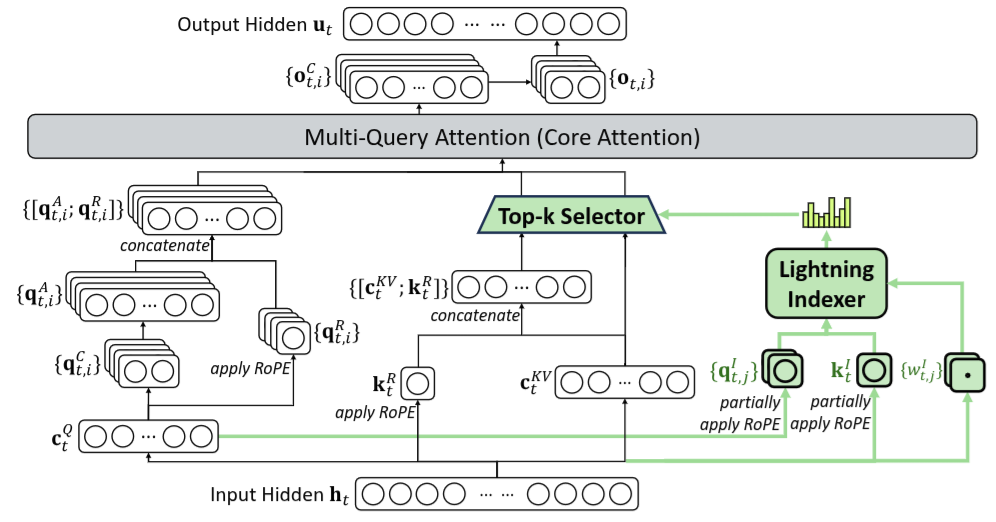
- DSA 的原型主要由两个组件构成:lightning indexer 和细粒度 token 选择机制
- lightning indexer 计算查询 token
 与其前序 token
 之间的索引分数
 ,以确定查询 token 应选择哪些 token
- 其中,
 表示索引器的头数;
 和
 均由查询 token
 生成,而
 则由前序 token
 生成。出于吞吐量方面的考虑,选择 ReLU 作为激活函数。由于索引器的头数较少,且可以采用 FP8 实现,因此具有很高的计算效率
- 给定每个查询 token 对应的索引分数
 ,细粒度 token 选择机制仅检索索引分数最高的
 个键值条目
 。随后,在查询 token 与稀疏选取的键值条目之间应用注意力机制,计算注意力输出

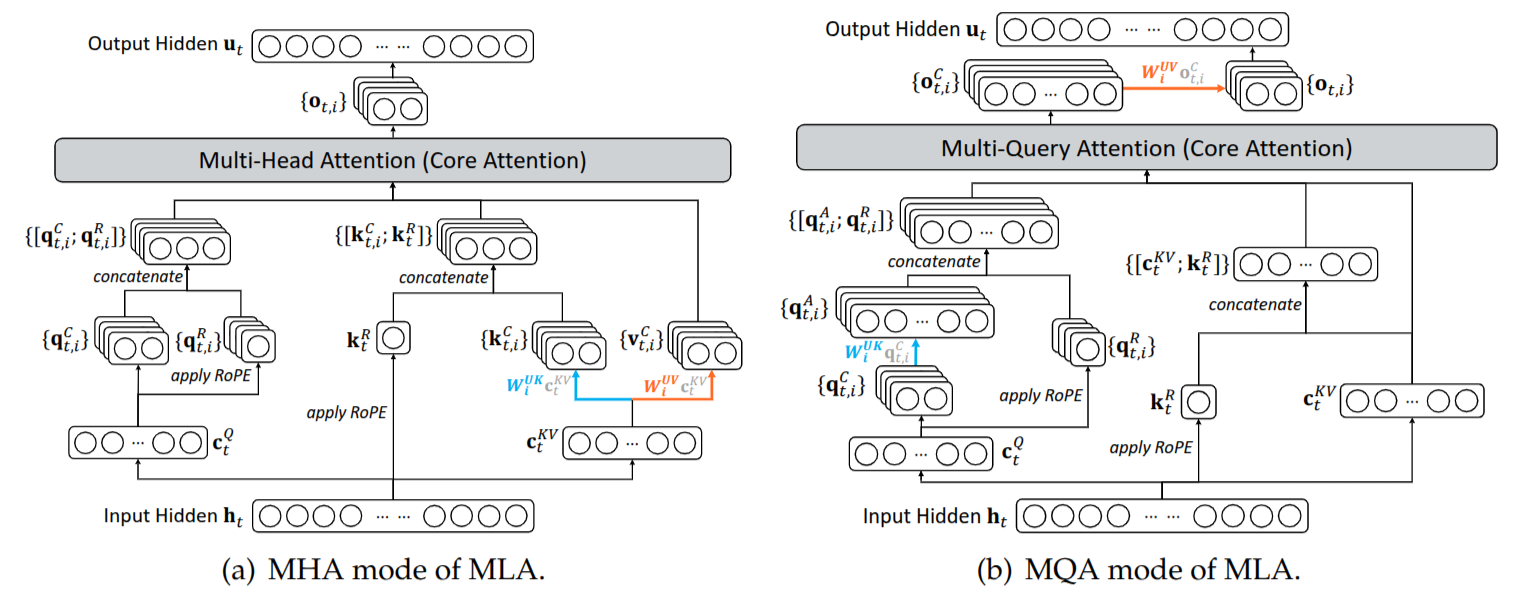
考虑到模型需要从 DeepSeek-V3.1-Terminus 继续训练,基于 MLA 为 DeepSeek-V3.2 实例化 DSA。在计算内核层面,为提高计算效率,每个键值条目必须在多个查询之间共享。因此,基于 MLA 的 MQA 模式实现 DSA,其中,每个潜在向量均由当前查询 token 的所有查询头共享
以已将上下文长度扩展至 128K 的 DeepSeek-V3.1-Terminus 基础模型检查点为起点,先进行持续预训练,再进行后训练,最终得到 DeepSeek-V3.2
- 稠密预热阶段:首先通过一个短暂的预热阶段初始化。保留稠密注意力,并冻结索引器之外的所有模型参数。为使索引器输出与主注意力分布对齐,对于第
 个查询 token,对所有注意力头的主注意力分数求和,得到聚合分数;沿序列维度进行 L1 归一化,得到目标分布
 。基于
 ,采用 KL 散度损失作为索引器的训练目标
- 稀疏训练阶段:索引器预热完成后,引入细粒度 token 选择机制,并优化所有模型参数,使模型适应 DSA 的稀疏模式。在此阶段,仍持续将索引器输出与主注意力分布对齐,但仅考虑选中的 token 集合

- 将索引器的输入从计算图中分离,以实现独立优化。索引器的训练信号仅来自
 ,而主模型仅依据语言建模损失进行优化
⚓ Post-Training
完成持续预训练后,进一步进行后训练,得到最终的 DeepSeek-V3.2。DeepSeek-V3.2 的后训练同样采用稀疏注意力,其使用方式与稀疏持续预训练阶段一致。对于 DeepSeek-V3.2,沿用 DeepSeek-V3.2-Exp 的后训练流程,包括专家模型蒸馏和混合强化学习训练
专家模型蒸馏先为各任务构建专用领域模型。针对每项任务,首先构建一个专用于相应领域的专家模型,所有专家模型均由同一个预训练 DeepSeek-V3.2 基础模型检查点微调得到
- 除写作任务和通用问答外,该框架还涵盖六个专门领域:数学、编程、通用逻辑推理、通用智能体任务、智能体编程和智能体搜索,所有领域均支持思考与非思考两种模式。为每个专家模型投入大规模计算资源进行强化学习训练
- 采用不同的模型,分别生成用于长思维链推理和直接回答生成的训练数据。专家模型训练完成后,便用于为最终模型检查点生成特定领域的数据。实验结果表明,使用蒸馏数据训练的模型,其性能仅略低于相应领域的专家模型,而这一性能差距可通过后续的强化学习训练有效消除
DeepSeek-V3.2 的混合强化学习采用组相对策略优化(GRPO)
- 与 DeepSeek-V3.2-Exp 一致,将推理、智能体和人类对齐训练整合到同一个强化学习阶段。这种方式能够有效平衡不同领域的性能,同时避免多阶段训练范式中常见的灾难性遗忘问题
- 对于推理和智能体任务,采用基于规则的结果奖励、长度惩罚和语言一致性奖励。对于通用任务,采用生成式奖励模型
DeepSeek-V3.2 与 DeepSeek-V3.2-Speciale:DeepSeek-V3.2 整合从专家模型蒸馏得到的推理、智能体和人类对齐数据,并经过数千步持续强化学习训练,得到最终的模型检查点
对于每个给定的问题 ,从旧策略
 中采样一组回答
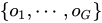 ,GRPO 通过最大化以下目标来优化策略模型

重要性采样校正使旧策略样本能够用于当前策略的无偏 KL 估计。由于 采样自旧策略
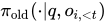 ,利用当前策略与旧策略之间的重要性采样比率,对 K3 估计器进行校正,以获得无偏的 KL 估计
- 这一调整直接使该 KL 估计器的梯度成为无偏估计,消除系统性估计误差,从而促进稳定收敛
- 这与原始 K3 估计器形成鲜明对比,尤其是在采样 token 在当前策略下的概率显著低于其在参考策略下的概率时,即
 。在这种情况下,K3 估计器的梯度会赋予这些 token 过大且无界的权重,以最大化其似然,从而产生噪声较大的梯度更新。这些更新不断累积,导致后续迭代的样本质量下降,并引发不稳定的训练动态
- 发现不同领域适用的 KL 正则化强度有所不同。对于数学等特定领域,采用相对较弱的 KL 惩罚,甚至完全不使用 KL 惩罚,可能获得更好的性能
多次复用 rollout 数据会扩大采样策略与当前策略之间的差异。为提高强化学习系统的效率,通常先生成一个大批次的 rollout 数据,再将其拆分为多个小批次,执行多步梯度更新
- 这种做法本身就会引入离策略行为。此外,用于高效数据生成的推理框架通常经过高度优化,其实现细节可能与训练框架不同。这种训练与推理的不一致会进一步加剧离策略程度
- 为稳定训练并提高对离策略更新的容忍度,屏蔽那些引入显著策略偏离的负样本序列,其中,策略偏离程度通过数据采样策略与当前策略之间的 KL 散度来衡量。具体而言,在 GRPO 损失中引入二值掩码

- 此处的表示推理框架直接返回的采样概率,因此,旧策略与当前策略之间的 KL 散度同时涵盖上述两种离策略来源。仅屏蔽优势为负的序列
保持采样与训练阶段的专家路由一致,有助于稳定策略优化。混合专家模型通过在推理时仅激活部分专家模块来提高计算效率。然而,推理与训练框架之间的差异叠加策略更新的影响,即使对于完全相同的输入,也可能导致推理与训练阶段的专家路由不一致。这种不一致会使被激活的参数子空间发生突变,从而破坏优化稳定性并加剧离策略问题
- 为缓解这一问题,保留推理框架在采样时使用的专家路由路径,并在训练阶段强制采用相同的路由路径,以确保优化的是相同的专家参数
- 保持路由对 MoE 模型强化学习训练的稳定性至关重要,并从 DeepSeek-V3-0324 开始将其纳入强化学习训练流程
训练阶段保留采样掩码,以对齐 top-p 与 top-k 采样限制。Top-p 和 top-k 是广泛使用的采样策略,用于提高大语言模型生成回答的质量。在强化学习训练中采用这些策略同样有益,因为这能避免极低概率的 token 被采样并用作优化目标
- 尽管这种截断操作能够维持样本质量,但它也会导致与的动作空间不匹配,从而违背重要性采样的基本原则并破坏训练稳定性
- 为解决这一问题,保留从采样时使用的截断掩码,并在训练过程中将其应用于,确保两种策略具有相同的动作子空间。实验表明,将 top-p 采样与保持采样掩码策略结合,能够有效维持强化学习训练过程中的语言一致性
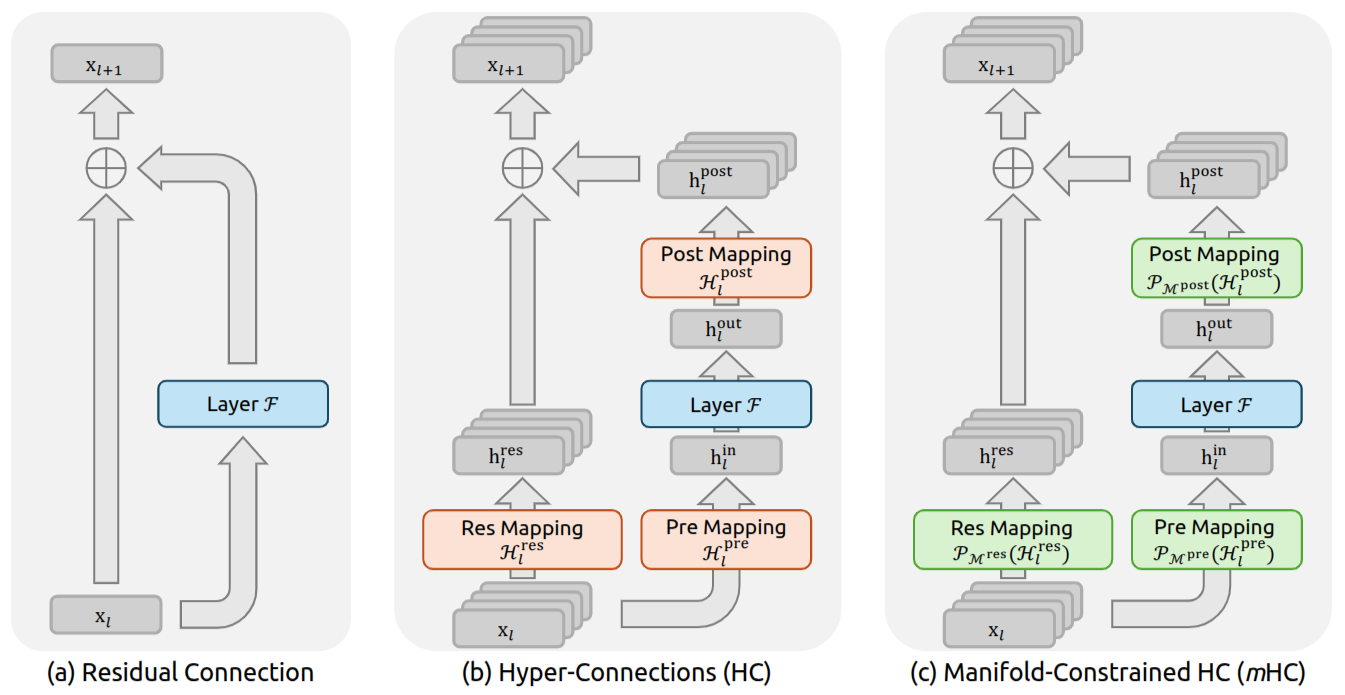
🦄 mHC: Manifold-Constrained Hyper-Connections
自残差网络提出以来,深度神经网络架构经历快速演进。单层结构可形式化表示为
- 其中,
 和
 分别表示第
 层的
 维输入与输出,
 表示残差函数。尽管残差函数在过去十年间不断演进,涵盖卷积、注意力机制和前馈网络等多种运算,但残差连接范式始终保持着最初的形式
- 早期研究揭示,残差连接的恒等映射性质能够维持大规模训练的稳定性与效率。将残差连接递归展开至多个层,可得
近期,以超连接为代表的研究为残差连接引入新的设计维度,并通过实验验证其性能潜力。通过扩宽残差流并增加连接复杂度,HC 在不改变单个计算单元浮点运算量开销的情况下,显著提升网络拓扑的复杂度。形式上,HC 的单层传播定义为
- 其中,和分别表示第层的输入与输出。和的特征维度由扩展为
 ,其中
 为扩展倍率。
 表示一个可学习映射,用于在残差流内部混合特征。同样作为可学习映射,
 将
 维残差流中的特征聚合为维的层输入,而
 则将层输出映射回残差流
- 随着训练规模扩大,HC 会引入潜在的不稳定风险。当架构扩展至多个层时,HC 的无约束性质会破坏恒等映射性质。在包含多个并行流的架构中,理想的恒等映射发挥着守恒机制的作用,确保跨流的平均信号强度在前向传播和反向传播过程中均保持不变。将 HC 递归展开至多个层,可得
- HC 中的复合映射
 无法保持特征的全局均值。这一差异会导致信号出现无界放大或衰减,从而引发大规模训练中的不稳定性
- 尽管 HC 在 FLOPs 层面维持计算效率,但其原始设计并未解决残差流扩宽后访存开销所带来的硬件效率问题。这些因素共同限制 HC 在实际应用中的可扩展性,并阻碍其在大规模训练中的应用
作者提出流形约束超连接:通过将 HC 的残差连接空间投影到特定流形上来恢复恒等映射性质,同时结合系统性的基础设施优化以保证效率
- mHC 利用 Sinkhorn–Knopp 算法,以熵投影的方式将
 投影到 Birkhoff 多面体上。这一操作将残差连接矩阵有效地约束在由双随机矩阵构成的流形内。由于这些矩阵的行和与列和均为
 ,运算
 相当于对输入特征进行凸组合
- 这一特性使信号传播具有良好的数值条件:特征均值保持不变,信号范数受到严格约束,从而有效缓解信号消失或爆炸的风险
- 由于双随机矩阵集合在矩阵乘法下具有封闭性,复合映射仍然保留这一守恒性质。mHC 能够有效维持任意深度之间恒等映射的稳定性
- 为保证效率,采用内核融合,并基于 TileLang 开发混合精度内核。通过选择性重计算降低显存占用,并在 DualPipe 调度中精心安排通信的重叠执行
🌿 Related Works
微观设计关注计算模块的内部架构,规定特征在空间、时间和通道维度上的处理方式。相比之下,宏观设计确定计算模块之间的拓扑结构,从而决定特征表示如何在不同层之间传播、路由和合并
凭借参数共享和平移不变性,卷积最初在结构化信号处理中占据主导地位。随后,深度可分离卷积和分组卷积等变体提升计算效率,而 Transformer 的出现则确立注意力机制与前馈网络作为现代架构基本组成模块的地位。注意力机制促进全局信息传播,FFNs 则增强单个特征的表示能力
- 为在模型性能与大语言模型的计算需求之间取得平衡,注意力机制逐渐发展出多查询注意力、分组查询注意力和多头潜在注意力等高效变体
- 与此同时,FFNs 通过混合专家被推广为稀疏计算范式,使参数规模能够大幅扩展,而无需按比例增加计算成本
宏观设计决定网络的全局拓扑结构。继 ResNet 之后,DenseNet 和 FractalNet 等架构分别通过稠密连接和多路径结构增加拓扑复杂度,以提升模型性能。深层聚合通过递归聚合不同深度与分辨率的特征,进一步扩展这一范式
- 近期,宏观设计的研究重点逐渐转向扩宽残差流。超连接引入可学习矩阵,以调节不同深度特征之间的连接强度
- 残差矩阵 Transformer 则使用外积记忆矩阵替代标准残差流,以支持特征存储。类似地,MUDDFormer 采用多路动态稠密连接来优化跨层信息流
- 尽管这些方法展现出一定潜力,但它们会破坏残差连接固有的恒等映射性质,从而引入不稳定性并限制可扩展性。此外,特征宽度的扩展还会带来显著的访存开销
- 在 HC 的基础上,本文提出的 mHC 将残差连接空间约束在特定流形上,以恢复恒等映射性质,同时结合系统性的基础设施优化来保证效率。该方法在保留连接扩展所带来的拓扑优势的同时,提升稳定性与可扩展性
🐧 Preliminary
在 HC 的形式化定义中,将第层的输入 扩展倍,以构建隐状态矩阵
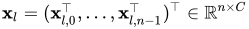 ,该矩阵可视为路残差流。为控制残差流的读取、写入和更新过程,HC 引入三个可学习的线性映射:
 ,以及
- 在 HC 中,可学习映射由两部分系数组成:依赖于输入的部分与全局部分,分别称为动态映射和静态映射
- 其中,
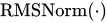 作用于最后一个维度;标量
 、
 和
 是可学习的门控因子,初始化为较小的值。动态映射由线性投影得到,其参数为
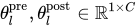 和
 ;静态映射则由可学习偏置
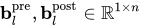 和
 表示
- 引入
 、
 和这些映射所带来的计算开销可以忽略,因为典型扩展倍率远小于输入维度。通过这一设计,HC 有效地将残差流的信息容量与层输入维度解耦,而后者与模型的计算复杂度密切相关
- 尽管 HC 需要通过三个映射来处理残差流与层输入之间的维度不匹配,但初步实验表明,残差映射带来的性能提升最为显著
尽管残差映射对性能至关重要,但其逐层连续应用会对数值稳定性构成显著风险。当 HC 扩展至多个层时,从第层到第 层的有效信号传播由复合映射决定。由于可学习映射不受约束,这一复合映射不可避免地会偏离恒等映射
- 因此,在前向传播和反向传播过程中,信号幅值都容易出现爆炸或消失。这一现象破坏残差学习依赖于信号畅通传播的基本前提,从而使更深或更大规模模型的训练过程变得不稳定
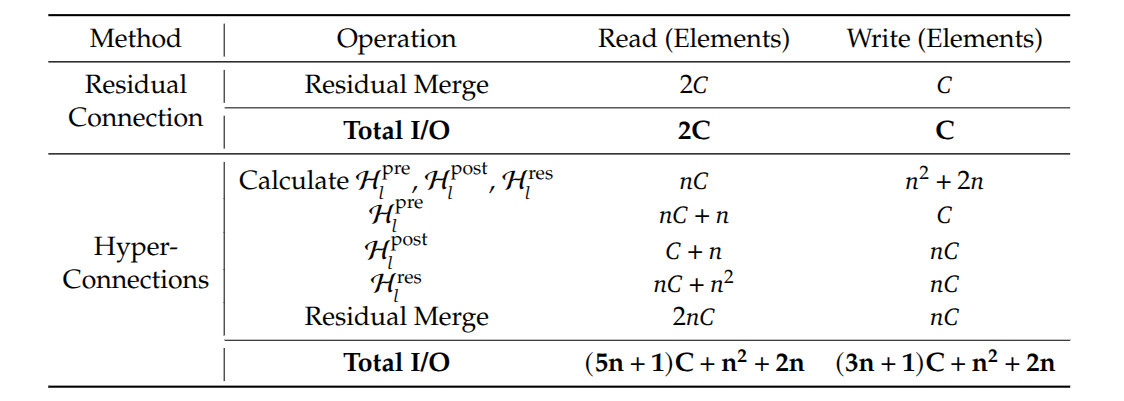
尽管额外映射的线性性质使 HC 的计算复杂度保持在可控范围内,但系统层面的开销仍构成不可忽视的挑战。具体而言,访存开销往往是现代模型架构的主要瓶颈之一,通常被称为内存墙。这一瓶颈在架构设计中经常被忽视,却对运行效率具有决定性影响
- 针对广泛采用的预归一化 Transformer 架构,分析 HC 固有的 I/O 访问模式。分析表明,HC 的访存开销增长倍数近似与成正比。若不借助融合内核缓解,这种过大的 I/O 需求会显著降低训练吞吐量
- 由于、和涉及可学习参数,反向传播需要保留相应的中间激活。这会显著增加 GPU 显存占用,通常需要采用梯度检查点来将显存用量控制在可承受范围内。进一步而言,HC 在流水线并行中需要倍的通信开销,导致更大的流水线气泡,并降低训练吞吐量
🕊️ Manifold-Constrained Hyper-Connections
受恒等映射原理的启发,mHC 的核心思想是将残差映射约束到特定流形上。原始恒等映射通过强制 来保证稳定性,但这也从根本上排除残差流内部的信息交换,而信息交换对于充分发挥多流架构的潜力至关重要
- 因此,提出将残差映射投影到一个流形上,使其既能维持跨层信号传播的稳定性,又能促进残差流之间的交互,从而保留模型的表达能力。将限制为双随机矩阵,即矩阵元素非负,且各行与各列的元素和均为 1。形式上,令
 表示双随机矩阵构成的流形,也称为 Birkhoff 多面体
- 需要指出的是,当
 时,双随机条件退化为标量 1,从而恢复原始恒等映射
- 此外,对输入映射和输出映射施加非负约束。这一约束能够防止正、负系数组合引起的信号抵消,也可视为一种特殊的流形投影
采用双随机约束能够赋予模型若干有利于大规模训练的严格理论性质
- 双随机残差映射具有非扩张性,可缓解梯度放大。双随机矩阵的谱范数以 1 为上界,即
 。这意味着该可学习映射具有非扩张性,能够有效缓解梯度爆炸问题
- 双随机矩阵的乘积仍为双随机矩阵,使多层复合保持约束。这保证跨越多个层的复合残差映射仍然是双随机矩阵,从而在模型的整个深度范围内保持稳定性
- 基于 Birkhoff 多面体的几何解释:集合构成 Birkhoff 多面体,即置换矩阵集合的凸包。残差映射相当于置换的凸组合。从数学上看,反复应用这类矩阵往往会单调增强跨流信息的混合程度,从而有效发挥鲁棒特征融合机制的作用
给定第层的输入隐状态矩阵 ,首先将其展平为向量
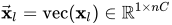 ,以保留完整的上下文信息。随后,沿用原始 HC 的形式,计算动态映射和静态映射
- 其中,
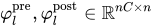 和
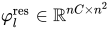 是用于动态映射的线性投影,
 是将
 重塑为
 的函数。随后,通过以下方式获得最终满足约束的映射
- 其中,
 表示 Sigmoid 函数。
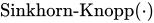 算子首先通过指数运算使所有元素均为正,然后进行迭代归一化,交替缩放各行与各列,使其元素和为 1。具体而言,以元素均为正的矩阵
 作为初始值,归一化迭代过程为
- 其中,
 和
 分别表示行归一化与列归一化。当
 时,该过程收敛为双随机矩阵
 。实验中,选择
 作为实际迭代次数
🍄 Efficient Infrastructure Design
mHC 中的 RMSNorm 在处理高维隐状态 时会带来显著延迟,因此将除以范数的操作调整到矩阵乘法之后执行。这一优化在保持数学等价性的同时提高效率
- 采用混合精度策略,在不牺牲速度的前提下尽可能提高数值精度,并将具有共同访存需求的多个操作融合为统一的计算内核,以缓解内存带宽瓶颈
- 基于式(10)至式(13)中给出的输入与参数,实现三个专用的 mHC 内核,用于计算、和。在这些内核中,偏置与线性投影分别合并到
 和
 中,RMSNorm 的权重也被吸收到中
- 式(14)至式(15):开发一个统一内核,融合对
 的两次扫描,并利用矩阵乘法单元最大限度地提高内存带宽利用率。包含两次矩阵乘法的反向传播也被合并到单个内核中,从而消除对的冗余加载。这两个内核均采用经过精细调优的流水线,包括加载、类型转换、计算和存储,以高效处理混合精度计算
- 式(16)至式(18):这些针对小规模系数的轻量操作被融合到单个内核中,显著降低内核启动开销
- 式(19):在单个内核中实现 Sinkhorn–Knopp 迭代。对于反向传播,推导一个自定义反向内核,在片上重计算中间结果,并遍历整个迭代过程
利用上述内核计算的系数,再用两个内核应用映射:一个用于 ,另一个用于
 。通过将和的映射操作与残差合并操作融合,将该内核读取的元素数量从
 降至
 ,写入的元素数量从
 降至
由于 mHC 内核的重计算以 个连续层为一组进行,对于总共包含层的模型,需要为全部
 个块持久保存各自的首层输入
 ,以供反向传播使用。除这部分常驻显存外,重计算过程还会为当前处理的块引入
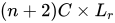 个元素的临时显存开销,这决定反向传播期间的峰值显存占用。通过最小化关于的总显存占用,确定最优块大小

- 重计算块不能跨越流水线阶段边界。理论最优值通常与每个流水线阶段包含的层数相匹配,因此选择将重计算边界与流水线阶段边界对齐
在大规模训练中,流水线并行是降低参数与梯度显存占用的标准做法
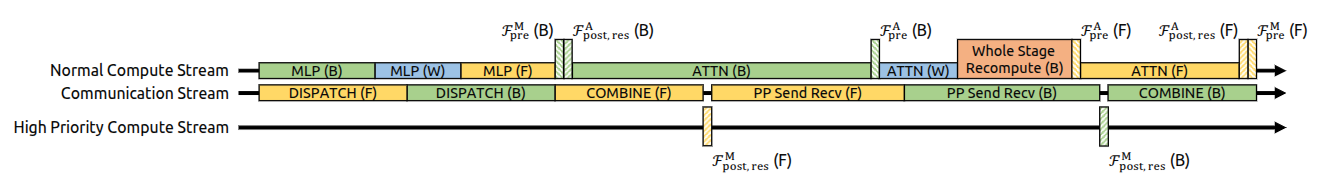
- 采用 DualPipe 调度,以有效重叠执行横向扩展互连通信,例如专家并行和流水线并行中的通信。然而,与单流设计相比,mHC 的路残差流在流水线阶段之间引入显著的通信延迟
- 在阶段边界处,对全部个层的 mHC 内核进行重计算,会带来不可忽视的计算开销。为解决这些瓶颈,扩展 DualPipe 调度,以更好地在流水线阶段边界处实现通信与计算的重叠。为避免阻塞通信流,将 MLP 层的
 内核放在专用的高优先级计算流上执行
- 对于注意力层中执行时间较长的操作,避免采用常驻内核(persistent kernels),防止长时间停顿。这一设计使重叠执行的注意力计算能够被抢占,从而支持灵活调度,同时维持计算设备处理单元的高利用率。此外,由于每个阶段的初始激活已缓存在本地,重计算过程得以与流水线通信依赖解耦
📡 Conditional Memory via Scalable Lookup: DeepSeek Engram
稀疏性是智能系统中反复出现的一项设计原则,从生物神经回路到现代大语言模型,均体现这一思想。目前,这一原则主要通过混合专家架构实现,即利用条件计算扩展模型容量。由于能够在计算量不成比例增长的情况下大幅增加模型规模,MoE 已成为前沿模型事实上的标准架构
- 尽管条件计算范式取得成功,语言信号的内在异质性仍表明,模型结构存在显著的优化空间。语言建模涉及两类性质不同的子任务:组合式推理与知识检索。前者需要深层、动态的计算,而文本中的相当一部分内容,例如命名实体和固定表达模式,则具有局部性、静态性和高度定型化的特征
- 经典 N-gram 模型在捕捉此类局部依赖方面的有效性表明,这些规律天然适合通过计算开销较低的查表操作来表示
- 由于标准 Transformer 缺乏原生的知识查找原语,当前大语言模型不得不通过计算来模拟检索。这一过程本质上是在运行时以高昂的代价重建一张静态查找表,将宝贵的串行计算深度耗费在简单操作上,而这些深度资源本可用于更高层次的推理
为使模型架构与语言的这种二重性相契合,主张引入一个互补的稀疏性维度:条件记忆
- 条件计算通过稀疏激活参数来处理动态逻辑,而条件记忆则依赖稀疏查表操作,检索表征固定知识的静态嵌入
- 作为对这一范式的初步探索,重新考察 N-gram 嵌入这一典型实现方式:以局部上下文为键,通过常数时间复杂度 O(1) 的查表操作索引大规模嵌入表
本文提出 Engram,一种以经典 N-gram 结构为基础的条件记忆模块,并融入分词器压缩、多头哈希、上下文感知门控和多分支集成等现代化改进
- 为量化这两类原语之间的协同作用,提出稀疏性分配问题:在总参数预算固定的情况下,应如何在 MoE 专家与 Engram 记忆之间分配容量
- 实验揭示一条明显的 U 形缩放定律,表明即便是简单的查表机制,只要将其作为一等建模原语,也能成为神经计算不可或缺的补充。在这一分配规律的指导下,将 Engram 模型扩展至 27B 参数规模。与参数量及 FLOPs 严格相同的 MoE-27B 基线相比,Engram-27B 在多个领域展现出更高的效率
基于 LogitLens 和 CKA 的机制分析揭示这些收益的来源:Engram 减轻主干网络在浅层重建静态知识的负担,从而增加可用于复杂推理的有效深度
- 通过将局部依赖的处理交由查表机制承担,Engram 释放注意力容量,使其能够专注于全局上下文,从而在长上下文场景中展现出优异性能
- 与 MoE 的动态路由不同,Engram 采用确定性 ID 来支持运行时预取,实现通信与计算的重叠。实验结果表明,将一张包含 100B 参数的表卸载至主机内存,仅会引入可忽略的额外开销。这表明,Engram 能够有效绕开 GPU 显存约束,从而支持大幅扩展参数规模
⛵ DeepSeek Engram
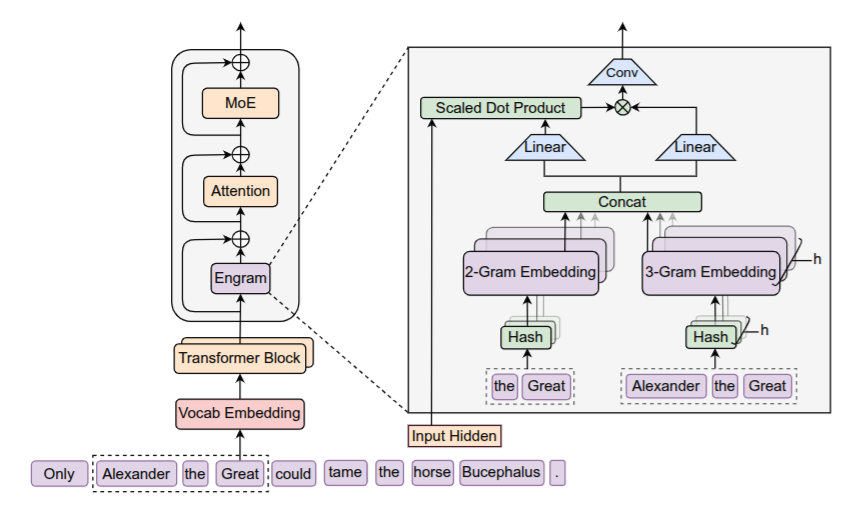
Engram 是一种条件记忆模块,旨在通过从结构上分离静态模式存储与动态计算,增强 Transformer 主干网络。形式上,给定输入序列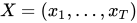 以及第
 层的隐藏状态
 ,该模块通过两个功能阶段处理每个位置:检索与融合。其中,第一阶段将局部上下文映射到静态记忆条目,具体包括分词器压缩,以及通过确定性哈希检索嵌入
分词器压缩将规范化后等价的 token 归并为统一标识。尽管 N-gram 模型通常直接作用于分词器的输出,但标准子词分词器优先考虑无损重建,因此往往会为语义等价的词项分配不同的 ID,例如 Apple 与 apple。为最大化语义密度,引入一个词表投影层。预先计算一个满射函数 ,依据文本规范化后的等价关系,将原始 token ID 归并为规范标识符;所采用的规范化操作包括 NFKC、小写转换等
- 对于位置 处的 token,将其原始 ID
 映射为规范 ID
 ,从而构成后缀 N-gram
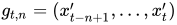
多头哈希将局部 N-gram 映射到稀疏嵌入表并缓解冲突。对所有可能的 N-gram 所构成的组合空间直接进行参数化是不可行的。采用基于哈希的方案。为缓解哈希冲突,针对每个 N-gram 阶数 设置 个不同的哈希头。每个头通过确定性函数
 ,将压缩后的上下文映射为嵌入表
 中的索引,其中表的大小
 为质数
- 在实际实现中,采用轻量级的乘法异或哈希。将所有检索得到的嵌入拼接起来,构成最终的记忆向量

检索得到的嵌入 充当与上下文无关的先验。然而,由于这些嵌入是静态的,因此本身缺乏对上下文的适应能力,并可能因哈希冲突或多义性而引入噪声
- 为增强表达能力并消除这种歧义,采用一种受注意力机制启发的上下文感知门控机制。将当前隐藏状态作为动态 Query,该隐藏状态已通过前面的注意力层聚合全局上下文;检索得到的记忆则作为 Key 和 Value 投影的共同输入
- 其中,
 为可学习的投影矩阵。为保证梯度稳定性,先对 Query 和 Key 应用 RMSNorm,再计算标量门控值

- 门控后的输出定义为
 。这一设计能够实现语义对齐:如果检索得到的记忆 与当前上下文 相矛盾,门控值
 将趋近于零,从而有效抑制噪声
- 最后,为扩大感受野并增强模型的非线性表达能力,引入短核逐通道因果卷积
Engram 模块通过残差连接集成到主干网络中: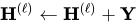 ,随后执行标准的注意力和 MoE 计算。关键在于,Engram 并非应用于每一层;其具体插入位置经过优化,以在建模效果与系统级延迟约束之间取得平衡
在本研究中,采用先进的多分支架构作为默认主干网络,以替代标准的单流连接,其原因在于前者具有更强的建模能力。这一架构的显著特征是将残差流扩展为条并行分支,并通过可学习的连接权重调节信息流
- 尽管 Engram 模块本身与拓扑无关,但将其适配到这一多分支框架仍需进行结构优化,以平衡效率与表达能力
- 采用参数共享策略:所有条分支共享一张稀疏嵌入表和一个 Value 投影矩阵
 ,同时使用个不同的 Key 投影矩阵
 ,以实现各分支特有的门控行为。对于隐藏状态为
 的第
 条分支,其专属门控信号计算如下
- 将这些独立的门控信号应用于共享的 Value 向量,以调制检索得到的记忆
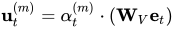
- 这一设计使得各线性投影,即一个和个不同的
 ,能够融合为一次稠密 FP8 矩阵乘法,从而最大限度地提高现代 GPU 的计算利用率
模型参数规模的扩展通常受到 GPU 高带宽内存(HBM)有限容量的制约。然而,与依赖运行时隐藏状态进行动态路由的 MoE 不同,Engram 采用仅依赖输入 token ID 的确定性检索机制,自然地将参数存储与计算解耦。这种可预测性使训练与推理阶段均能够采用专门的优化策略
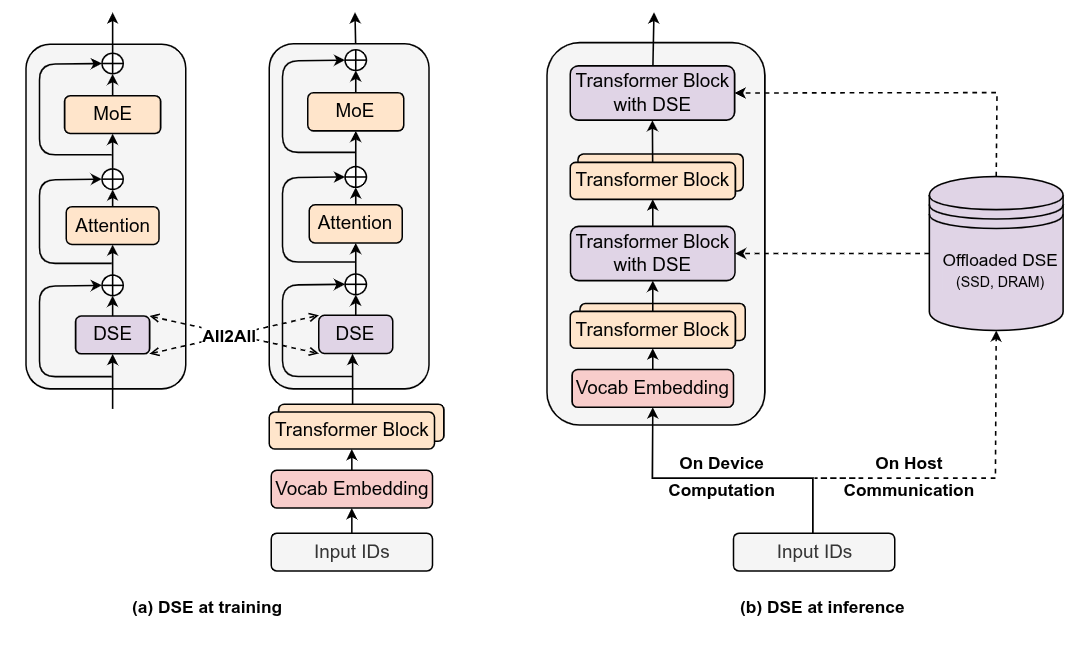
- 在训练阶段,为容纳大规模嵌入表,采用标准模型并行,将嵌入表分片存储在可用的 GPU 上。通过 All-to-All 通信原语,在前向传播中收集被访问的嵌入行,并在反向传播中分发梯度,使总存储容量能够随加速器数量线性扩展
- 在推理阶段,这种确定性支持预取与计算重叠策略。由于记忆索引在前向传播之前便已确定,系统可以通过 PCIe 从容量充足的主机内存中异步检索嵌入。为有效隐藏通信延迟,将 Engram 模块放置在主干网络的特定层,利用前面各层的计算过程提供缓冲时间,避免 GPU 停顿。这要求采用硬件与算法协同设计策略:虽然将 Engram 放置在更深的层能够延长用于隐藏延迟的计算窗口,但从建模性能来看,更早引入 Engram 以分担局部模式重建任务更为有利。因此,最优插入位置必须同时兼顾建模需求与系统延迟约束
- 自然语言中的 N-gram 天然遵循 Zipf 分布,即少量模式贡献绝大多数记忆访问。这一统计特性促使采用多级缓存层次结构:将频繁访问的嵌入缓存在速度更快的存储层中,例如 GPU HBM 或主机 DRAM,而将长尾的低频模式存储在速度较慢但容量较大的介质中,例如 NVMe SSD。这种分层设计使 Engram 能够在对实际延迟影响极小的情况下,实现记忆容量的大规模扩展