Infra Quant II
📡 QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs
大语言模型因其广泛的应用而变得日益重要。然而,在实际应用中使用这些模型,即进行推理,需要消耗大量的计算、内存和能源资源,尤其是在预填充阶段,模型需要处理较长的提示,并在各层缓存相应信息
- 量化通过在前向传播过程中使用较低精度的数据类型,成为缓解内存与计算开销问题的最重要技术之一
- 由于预填充阶段受计算能力限制(compute-bound),联合量化旨在降低参数和 KV 缓存的精度,以减少内存占用,同时降低输入(即激活)的精度,从而以低精度执行前向传播。然而,激活中存在数值远大于其他元素的离群值,使得激活量化比权重量化更加困难,尤其是在 4 位量化的情况下
本文通过随机化 Hadamard(哈达玛)变换对模型输入进行旋转,以解决离群特征问题。利用计算不变性这一思想,将 Hadamard 变换融合到权重矩阵中,从而得到一个不含离群特征的等价网络。这使得权重、激活和 KV 缓存均能够被量化为 4 位,而仅产生极小的精度下降。主要贡献如下
- 无需对模型进行额外修改,即可将随机化 Hadamard 变换应用于权重矩阵。可以在不改变模型输出的前提下,消除离群特征,使激活更易于量化
- 将这一方法进一步扩展到注意力模块,通过在线 Hadamard 变换消除键和值中的离群特征,从而实现 KV 缓存的量化
- 基于上述修改,QuaRot 采用整数量化,将全部权重、激活和 KV 缓存量化为 4 位,从而实现大语言模型的 4 位推理
🌊 Background
正交矩阵、旋转矩阵与 Hadamard 矩阵:正交矩阵 是满足
 的方阵。旋转矩阵是一种正交矩阵。本文采用归一化 Hadamard 矩阵,其元素取自
 ,其中 d 为矩阵阶数。Walsh–Hadamard 矩阵是阶数为
 的方阵,满足
- Walsh–Hadamard 变换能够以
 的运算复杂度计算矩阵与向量的乘积

- 当矩阵阶数不是
 时,不能保证存在相应的 Hadamard 矩阵。当需要阶数为
 的 Hadamard 矩阵时,将
 分解为
 ,其中
 是某个已知 Hadamard 矩阵的阶数。随后,采用 Kronecker 积构造
 。即可用
 次运算计算

- 遵循 Tseng et al. 的方法,使用随机化 Hadamard 矩阵。设
 是一个由从
 中随机采样的元素构成的向量,并令
 。容易看出,
 同样是正交矩阵
非相干性处理(incoherence processing)的思想由 Chee et al. 在面向大语言模型的仅权重量化研究中提出,用于权重归一化。如果权重矩阵 满足以下条件,则称其具有
 -非相干性
- 其中,
 表示矩阵所有元素绝对值中的最大值,
 表示矩阵的元素总数。当最大元素的绝对值相对整体幅值较大时,需要更大的非相干性参数 μ,量化也更困难。在权重矩阵的左侧和右侧乘以适当的正交矩阵,可以分散离群值、减小所需的 μ,使矩阵更易于量化
计算不变性定理指出,可以使用正交矩阵对 Transformer 中的权重和模块间激活进行变换,而不改变模型输出
- 如果
 是位于 Transformer 模块左侧的权重矩阵,即
 、
 ,或
 、
 、
 ,那么可以在其左侧乘以正交矩阵,并通过将输出矩阵
 、
 右乘
 来抵消这一变换的影响
- 即使两个模块之间存在 RMSNorm 操作,上述性质仍然成立,前提是 RMSNorm 模块中不执行重新缩放。在实际实现中,首先将所有重新缩放操作吸收到相邻的权重矩阵中。从概念上看,这是因为 RMSNorm 将激活除以其范数,而对激活施加旋转并不会改变其范数。因此,存在以下交换关系
- 将输出矩阵右乘后,该线性层的输出变为
 。这一输出经过归一化后,被传入下一个模块;由于该模块的输入权重矩阵已变为
 ,因此,该线性层仍然输出原始的激活结果,不发生改变
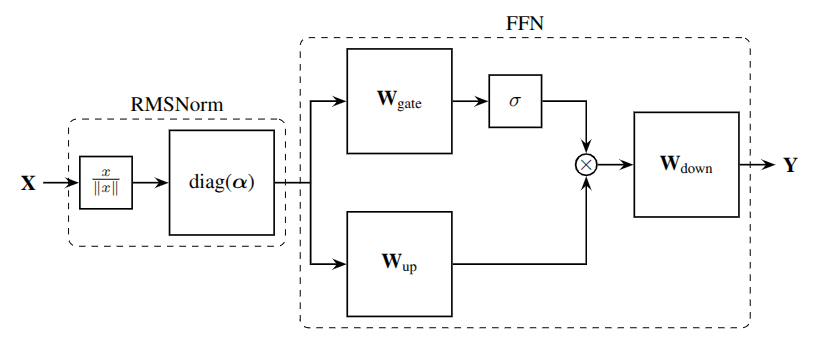
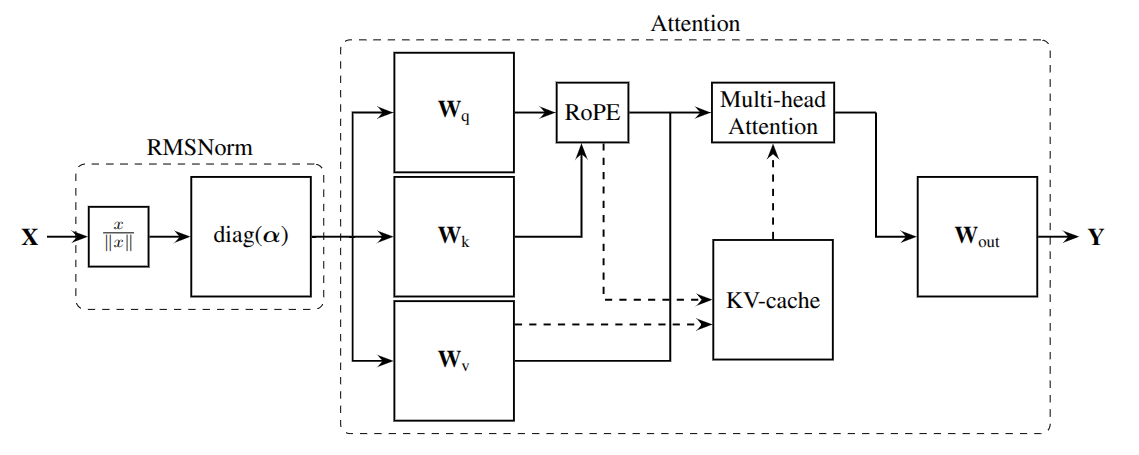
RMSNorm:先融合逐通道缩放,再旋转权重
- 未融合缩放时,缩放矩阵隔开两次旋转,一般不能抵消
- 先将缩放融合进
,再旋转权重,两次旋转相邻即可抵消
⛵ Method
QuaRot 包含两个阶段。在第一阶段,以全精度对模型权重进行变换,并在模型的前向传播过程中插入两个额外的 Hadamard 操作。在第二阶段,使用现有方法量化权重,并在前向传播过程中加入量化操作,以实现激活及缓存的在线量化。默认情况下,使用 GPTQ 进行权重量化,而激活则采用简单的就近舍入方案进行即时量化
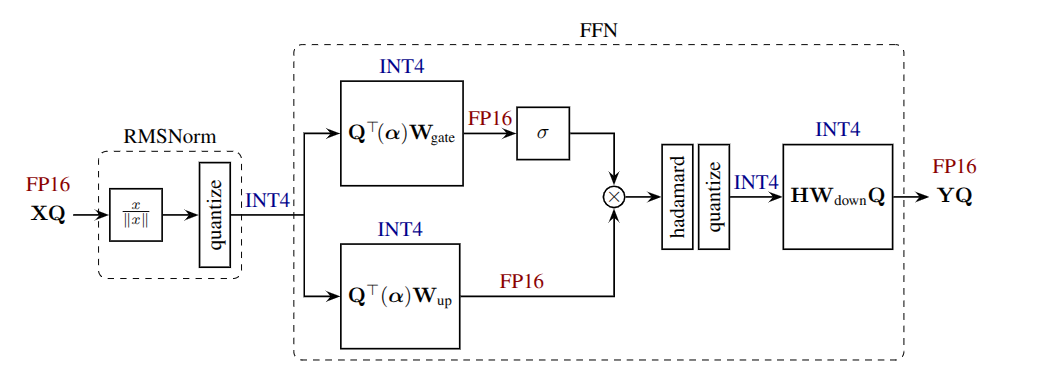
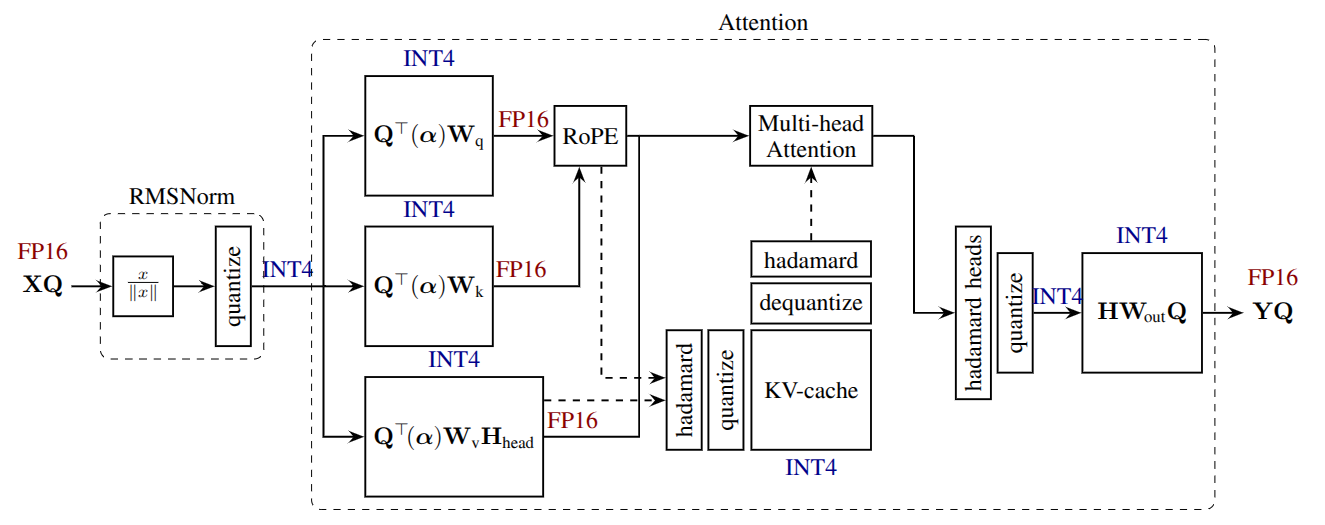
权重修改:首先利用计算不变性,将各个权重矩阵与正交矩阵相乘。先将 LayerNorm 或 RMSNorm 中的线性部分融合到相邻的权重矩阵中
- 移除 RMSNorm 中的缩放操作
 ,并将其吸收到后续的权重矩阵中
- 选择一个阶数与模型隐藏维度相匹配的随机化 Hadamard 矩阵,并将其左乘或右乘到各个权重矩阵上。例如,键投影的权重矩阵修改为
- 其他权重矩阵采用类似的处理方式。位于模块输出侧的矩阵则右乘 。根据计算不变性定理,在数值精度足够的前提下,上述权重修改不会影响模型输出。此外,Transformer 模块之间传递的激活矩阵也经过非相干性处理,变为

旋转前馈网络中的激活:完成上述权重修改后,许多权重矩阵的一侧已经乘上 Hadamard 矩阵,相应的激活也发生变化。还需要改善各模块内部激活的量化效果,通过插入在线 Hadamard 操作来实现这一目标
- 在前馈网络的下投影矩阵之前插入一个 Hadamard 操作。该操作以全精度执行,并采用遵循 Tseng et al. 的高效计算内核实现。通过将 Hadamard 矩阵融合到网络的下投影矩阵中,即
 ,可以隐式抵消这一操作的影响。结合全局矩阵,下投影矩阵最终变为

注意力中的值投影:为每个注意力模块应用一个额外的 Hadamard 操作。这一修改的一部分在线执行,另一部分则融合到权重矩阵中
- 首先注意,在注意力计算中,和在每个注意力头内部隐式相乘。将注意力计算写为
- 其中,
 是一个阶数等于序列长度的方阵,由查询与键的缩放点积经过掩码处理和 softmax 得到;
 是单个注意力头的值矩阵。这使能够使用阶数与每个注意力头维度相匹配的 Hadamard 矩阵
 ,对和进行额外处理
- 将这些修改代入式(6),注意力的计算结果保持不变。由于各注意力头的权重在权重表示中以拼接方式组织,因此,可以等价地执行一次具有 Kronecker 结构的乘法
- 至此,这一变换已经逐头应用于权重矩阵,使得多头注意力模块输出的激活也分别在各头内部发生旋转。为对注意力激活完成一次完整的 Hadamard 操作,使变换进一步跨越不同注意力头,利用以下恒等式:
- 当注意力头数量
 和每个头的维度
 均为 2 的幂时,该恒等式成立。由于已经将
 应用于 和 ,因此,只需进一步将
 应用于 ,即可完成整体变换
 。同时,在前向传播中插入一个模块,计算
 ,其中
 为注意力激活。通过重塑张量以处理 Kronecker 结构,再对重塑后的数据执行 Walsh–Hadamard 变换,即可高效完成这一计算
键旋转:利用上述方法,可以有效量化值向量。然而,注意力模块中的键向量同样存在离群值问题。与前面的处理类似,可以使用 Hadamard 旋转缓解这一问题,从而实现 KV 缓存的完整量化
- 首先注意,注意力分数
 的计算方式如下
 为缩放因子,
 为加性注意力掩码:允许访问的位置为 0,屏蔽位置为负无穷;
 表示 RoPE 等位置变换。现在可以观察到, 与
 之间存在与 和 之间类似的相互作用。然而,
 的存在,使无法直接将 Hadamard 矩阵融合到 和 中。因此,采用在线逐头 Hadamard 旋转,同时旋转查询和键。相应地,查询矩阵和键矩阵的计算修改为:
- 由于查询和键均进行旋转,最终的注意力分数 保持不变。考虑到解码时只有一个查询向量,却存在大量已缓存的键向量,采用 Post-RoPE 缓存。这样,每个解码步骤只需对单个 token 执行 Hadamard 变换。上述对前向传播的修改,包括插入专门的 Hadamard 模块以及调整权重,都不会改变模型前向计算的结果。其作用在于:模块之间的激活乘上 Hadamard 矩阵,而模块内部的激活则通过在线 Hadamard 变换进行处理,并由相应的权重矩阵修改抵消这些变换的影响。至此,即可对权重和激活进行量化
权重、激活与 KV Cache 的量化: 完成旋转变换后,QuaRot 使用 GPTQ 将权重量化为 INT4,也可采用更简单的就近舍入(Round-to-Nearest,RTN)方案,但会付出一定的精度代价。激活在推理时进行逐 token 对称量化:以每行最大绝对值除以 7 得到缩放因子,再将该行除以缩放因子并舍入为整数;移除缩放参数后的 RMSNorm 仍以 FP32 计算。INT4 GEMM 的 INT32 输出转换为 FP16,再乘以激活的逐行缩放因子和权重的逐列缩放因子完成反量化。对于注意力计算,将旋转后的 KV Cache 量化为低比特表示,以减少长序列、大批量场景下的内存访问,Query 保持 FP16;计算时分块读取并反量化 KV,结合类似 FlashAttention 的在线 softmax,以 FP16 完成点积
🌀 SpinQuant
针对权重、激活值以及键值缓存的训练后量化(Post-Training Quantization,PTQ)技术,能够显著降低大语言模型的内存占用、推理延迟与功耗。然而,当模型中存在异常值时,低比特量化通常会引入较大的量化误差
- 已有研究主要通过两类方式缓解这一问题。一类方法在权重和激活值之间重新分配量化难度;另一类方法则采用混合精度表示,对异常值进行单独处理
- 从新的角度研究异常值问题:通过为权重矩阵和激活矩阵引入旋转变换,削弱异常值并改善张量的量化友好性
- 受 Elhage et al. 和 SliceGPT 的启发,本文利用神经网络中的旋转不变性,从恒等映射中构造成对出现的旋转矩阵。由于这些旋转矩阵可以被吸收到相邻的权重矩阵中,因此不会改变模型整体的函数映射和全精度输出。应用随机旋转后,权重或激活值中的元素通常能够形成更加均匀、异常值更少的数值分布,从而降低低比特量化的难度
尽管随机旋转在统计意义上通常能够改善模型的量化性能,但实验表明,不同旋转矩阵对应的量化效果可能存在较大差异。例如,在零样本推理任务上,不同随机旋转矩阵所得到的平均准确率差距最高可达 13 个百分点
- 随机选择旋转矩阵并不能充分发挥旋转变换的潜力。基于这一观察,本文提出 SpinQuant,一种通过学习旋转矩阵来优化量化网络精度的新型方法。SpinQuant 在冻结预训练模型权重的情况下,直接优化旋转矩阵,使旋转后的权重与中间激活值更加适合低比特表示
在优化过程中,预训练模型的原始权重保持固定,仅更新旋转矩阵。为保证旋转矩阵始终满足正交约束,SpinQuant 采用 Cayley-SGD,在 Stiefel 流形上优化旋转参数。该优化过程不会改变全精度模型的输出,而是通过重新组织模型内部权重和激活值的数值分布,使中间表示更加适合低比特量化
针对不同的计算复杂度与量化精度需求,SpinQuant 提出两种旋转策略:SpinQuant-no-had 和 SpinQuant-had
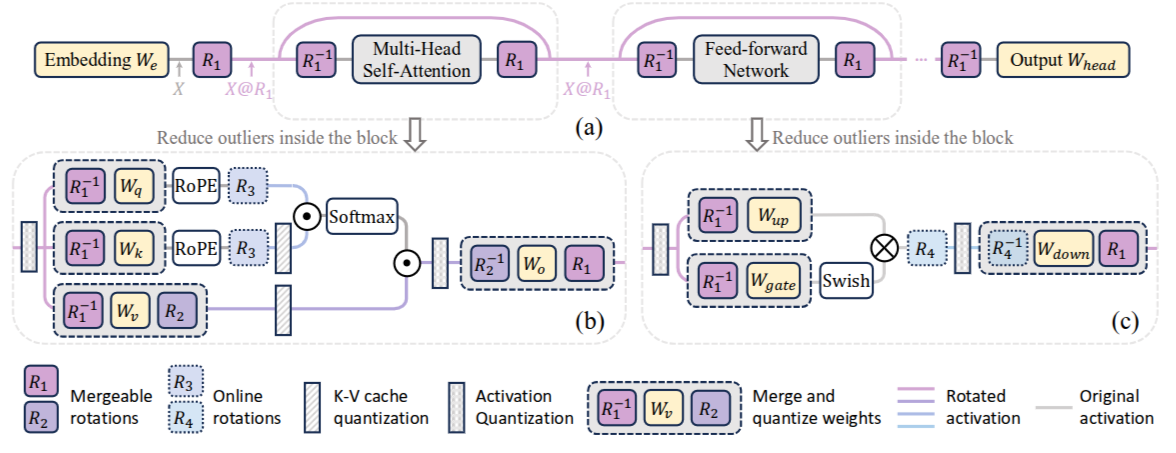
SpinQuant-no-had 主要包含 和
 两类旋转
- 这两类旋转矩阵均可直接吸收到对应的预训练权重矩阵中。在模型推理阶段,只需使用经过旋转和量化后的权重替换原始权重,无须修改模型的前向传播过程,也不会引入额外的在线旋转计算
- SpinQuant-no-had 在保持原始网络结构和推理流程不变的同时,能够有效改善模型权重及层间激活值的量化特性
SpinQuant-had 主要面向激活值或 KV Cache 采用极低比特量化的场景,例如 4 比特量化
- 除和
 之外,SpinQuant-had 进一步引入在线 Hadamard 旋转矩阵
 和
 ,分别用于处理 Q/K(含 K Cache)中的异常值,以及多层感知机 Down Projection 输入激活中的异常值
- 与完全吸收到权重中的离线旋转不同,
 和需要在推理过程中在线执行。然而,Hadamard 变换具有结构化和计算复杂度较低等特点,因此能够以较小的计算开销显著改善激活值与 KV Cache 的数值分布
通过联合使用可学习的离线旋转和结构化在线 Hadamard 旋转,SpinQuant 能够有效控制权重、激活值以及 KV Cache 在极低比特量化条件下产生的误差,并显著提高量化大语言模型的推理精度
🚀 MOTIVATION
量化通过降低神经网络中权重或激活值的数值精度,以减少模型的内存占用并降低推理延迟。量化过程可以表示为
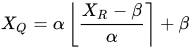
- 在对称量化中
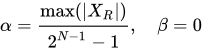
- 在非对称量化中
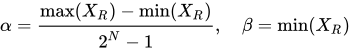
 表示量化后的张量,
 表示采用 FP16 格式存储的实值张量,N 表示量化位宽
对于大语言模型,异常值的存在会显著扩大权重或激活值的数值范围,从而增加普通数值的重构误差。本文提出采用经过优化的旋转变换来削弱异常值。直观而言,随机旋转矩阵能够在统计意义上将幅值较大与较小的权重分量进行混合,使其形成异常值更少、数值分布更加规则的表示,从而降低量化难度
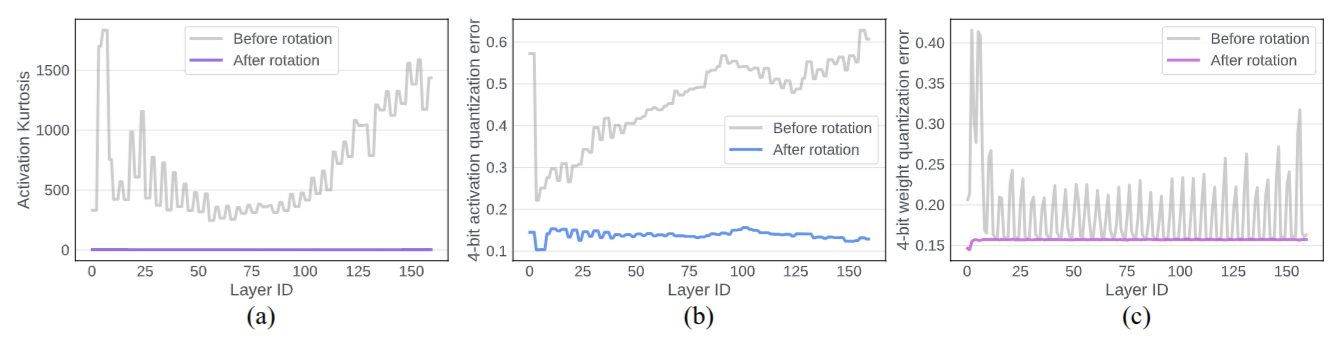
- 峰度用于衡量实值随机变量概率分布的尾部特性。较大的
 通常意味着分布中存在更多异常值,而当
 时,通常表明该分布接近高斯分布
- Transformer 中原始激活值分布包含大量异常值,许多层的峰度甚至超过 200。将激活值与随机旋转矩阵相乘后,所有层的峰度均下降至约 3。这说明旋转后的激活值呈现出更加接近高斯分布的形态,因此更适合进行低比特量化
尽管随机旋转在统计意义上通常能够改善量化性能,但并非所有随机旋转矩阵都会产生相同的量化结果
- 研究人员对 LLaMA-2 7B 模型进行 100 次随机实验。每次实验均采用不同的随机旋转矩阵,并将模型的权重和激活值同时量化至 4 比特,即 W4A4 配置,随后评估模型在零样本任务上的平均准确率。不同随机旋转矩阵所对应的模型性能存在显著差异。其中,最佳随机旋转矩阵所得到的平均准确率比最差随机旋转矩阵高出 13 个百分点
- 随机 Hadamard 矩阵的整体表现优于一般的随机旋转矩阵。Hadamard 矩阵能够对旋转后权重的最大幅值给出更加紧致的上界。然而,即使采用随机 Hadamard 旋转矩阵,模型最终性能仍然存在不可忽略的波动,其准确率差异最高可达 6 个百分点
鉴于不同旋转矩阵在多次实验中表现出巨大的性能方差,一个自然的问题是:能否直接优化旋转矩阵,从而最大化旋转变换对量化性能的提升作用?
🐢 ROTATION PARAMETERIZATION
本节介绍 SpinQuant,一种面向量化损失、在大语言模型中引入并优化旋转变换的量化框架
- 针对主流大语言模型架构定义一组旋转参数化形式,包括两个可被合并至权重矩阵中的旋转矩阵
 和。这两种旋转能够保证全精度网络的函数映射保持不变
- 引入两个需要在线计算的 Hadamard 旋转和,以进一步抑制激活值与 KV Cache 在极低比特量化条件下的异常值
- 介绍如何以量化网络的目标损失为优化目标,在 Stiefel 流形上对这些旋转矩阵进行联合优化
残差路径中的激活旋转:将嵌入层输出 与一个随机旋转矩阵相乘,从而对残差路径中的激活值进行旋转。该旋转能够减少异常值,并降低从残差路径读取输入的全连接层对输入激活值进行量化的难度
- 在旋转后的激活值进入包含非线性运算的注意力模块和前馈网络之前,乘以
 ,以执行逆旋转。在不存在量化的情况下,无论采用何种旋转,全精度网络均保持不变
- 这些旋转矩阵可以合并到相应的权重矩阵中。完成吸收后,网络中不会引入新的参数
注意力模块中的激活旋转:在注意力模块中,通过乘以对 Value 矩阵进行旋转,并以注意力头为单位,将输出投影层的输入激活值乘以
- 的形状为
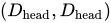 ,并且不同网络层可以独立选择各自的。由于与
 之间不存在其他算子,因此这两个旋转可以在全精度网络中相互抵消
- 该旋转能够改善 Value Cache 和输出投影层输入激活值的量化效果,并且不会向网络中引入任何新的参数
额外的未吸收旋转:为在更低比特的激活值量化场景中,例如 4 比特量化,进一步增强对异常值的抑制能力,在前馈网络模块内部引入 Hadamard 矩阵乘法,即,以减少下投影层输入激活值中的异常值
- Hadamard 旋转可以使用快速 Hadamard 变换进行计算,因此仅会给推理延迟带来很小的额外开销。类似地,当需要进行低比特 KV Cache 量化时,也可以插入 Hadamard 矩阵
将同时使用全部旋转矩阵、、和 的完整方法记为 SpinQuant-had
- :作用于残差流的全局可学习旋转,可合并至权重
- :作用于每个注意力头 Value 通道的可学习旋转,可合并至权重
- :面向低比特 KV Cache 量化的在线 Hadamard 旋转
- :面向前馈网络内部低比特激活量化的在线 Hadamard 旋转
引入四个旋转矩阵可以在保持全精度网络数值一致性的同时提升量化性能。由于和属于在线旋转操作,即无法被吸收到权重矩阵中,因此将其保留为 Hadamard 矩阵。因为在线 Hadamard 变换可以被高效实现,而不会引入显著的额外开销。优化目标定义为:寻找最优的旋转矩阵和 ,使量化网络的最终损失最小

- 其中
 表示 Stiefel 流形,即所有正交矩阵构成的集合。
 表示在校准集上计算的任务损失,例如交叉熵损失。在预训练权重
 和输入张量固定,并且网络中包含量化函数
 的情况下,损失是关于
 的函数
🦞 Cayley-OPTIMIZED ROTATION
为在 Stiefel 流形上优化旋转矩阵,采用 Cayley SGD 方法。该方法是一种用于 Stiefel 流形优化的高效算法。以下采用正学习率和损失函数的正梯度,并将旋转矩阵 R 的下降更新写为

 表示反对称矩阵
 的 Cayley 变换,并且

- 矩阵
 由损失函数梯度
 的投影
 计算得到
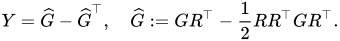
 始终是正交矩阵。因此,只要 R 是正交矩阵,更新后的
 也能够保证满足正交性,即

- 尽管涉及矩阵求逆,但新的旋转矩阵可以通过高效的定点迭代方法进行计算。与朴素 SGD 算法相比,该方法仅需约 2 倍的单次迭代计算时间,即可始终保持旋转矩阵的正交性质
采用 Cayley SGD 方法求解,同时冻结网络底层的权重参数。的参数规模仅约占模型权重规模的 ,并且受到正交性约束。因此,底层浮点网络保持不变,旋转操作只会影响模型的量化性能
- 当采用不同随机种子进行初始化时,经 Cayley 优化得到的旋转矩阵表现出极小的性能方差。在优化开始时,使用随机 Hadamard 矩阵对旋转矩阵进行初始化。消融实验进一步表明,即使采用随机旋转矩阵进行初始化,优化后的旋转矩阵同样具有较强的稳健性
🐧 FLATQUANT: Flatness Matters for LLM Quantization
量化通过降低模型参数和激活值的数值精度,从而减少模型的内存占用并加速推理过程。量化误差通常被用作衡量量化方法性能的重要指标。影响量化误差的一个关键因素是权重和激活分布的平坦性
- 直观而言,当权重或激活的分布较为尖锐,并且存在多个远离主体分布的数值时,将这些数值映射至相同的量化值通常会产生较大的量化误差
- 由于 LLM 的计算结果需要逐层经过 Transformer 网络传播,因此,降低量化误差也有助于减缓误差在 Transformer 层间的传播与累积
- LLM 的激活中往往存在极端离群值,同时还存在所谓的枢轴 Token(Pivot Tokens)。为缓解这一问题,已有大量工作提出在量化之前引入不同的变换,以削弱离群值所带来的影响
作者重新审视这些变换方法后发现,它们在提升分布平坦性方面仍然存在不足
- 逐通道缩放(Per-channel Scaling)旨在平衡权重与激活之间的离群值,但难以进一步将离群值分散至其他非离群通道
- 近期提出的 Hadamard 变换试图解决这一问题,但该方法并未充分考虑不同线性层自身的特性
- 此外,这些方法所引入的线性变换不可避免地会产生额外的推理开销,从而影响量化所能够带来的整体推理加速效果
FLATQUANT 的目标是为每一个线性层寻找最优的仿射变换,并利用校准数据(Calibration Data),通过一种轻量级的逐块训练策略对这些变换进行优化。为降低仿射变换所带来的推理开销,FLATQUANT 利用两个轻量级矩阵构造高效的 Kronecker 积变换,从而同时降低额外的内存需求和计算开销
- 该方法能够与多种量化技术兼容,例如可学习截断(Learnable Clipping),同时也可以应用于多种量化场景,包括仅权重量化和 KV Cache 量化
- 由于 FLATQUANT 所引入的仿射变换本质上属于内存受限操作,作者进一步将仿射变换与量化操作融合至单个计算 Kernel 中,从而减少全局内存访问以及 Kernel 启动开销
主要贡献总结如下
- 强调分布平坦性对于 LLM 量化的重要性,表明更加平坦的权重和激活分布有助于降低量化难度,减轻量化误差在 Transformer 各层之间的传播与累积
- 提出一种新的训练后量化方法 FLATQUANT。该方法针对每一个线性层优化快速且可学习的仿射变换,并能够有效提升 LLM 权重和激活分布的平坦性
- 该方法首次在 LLaMA-3-70B 模型上,仅采用简单的最近邻舍入(Round-to-Nearest, RTN)W4A4 量化,便实现不超过 1% 的精度下降
- 设计一种高效 Kernel,将仿射变换与量化操作进行融合。在 W4A4 量化设置下,与 FP16 基线相比,该 Kernel 可实现 2.3× 的 Prefill 阶段加速以及 1.7× 的 Decode 阶段加速
🐻 Preliminaries on LLM Quantization
量化是一种常用的模型压缩与推理加速技术,可以有效降低模型大小和推理延迟
- 对于线性层
 ,量化可以将全精度权重
 或激活
 转换为低比特表示,同时也可以选择对 KV Cache 进行量化。例如,b-bit 权重量化可以表示为
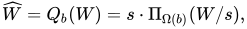
- 其中
 表示量化步长,
 表示投影函数,而
 表示有符号 b-bit 整数点构成的集合;这里采用有符号量化约定
LLM 的输入激活 中通常包含大量离群值。为降低这些离群值对量化的影响,一种常见方法是在权重和激活上进行逐通道缩放
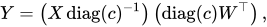
- 其中,
 表示逐通道缩放因子。该缩放向量通过同时考虑输入激活与权重的数值幅度,对激活分布进行平滑。对于第
 个通道,其缩放因子可以表示为
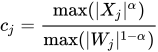 。经过缩放后的权重
 可以预先与原始权重进行融合,从而避免在运行时额外执行相应的缩放计算
- 一些方法进一步引入逐通道平移,将激活转换为
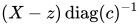 ,以进一步减弱离群值带来的影响。还有方法进一步将
 和
 均设置为可学习参数,通过校准数据对其进行优化
近期研究发现,归一化 Hadamard 矩阵 对于平滑激活中的离群值尤其有效
- 与逐通道缩放不同,从矩阵乘法的角度来看,Per-channel Scaling 本质上仅对变换矩阵的对角元素进行调整,因此每个通道仍然主要独立地进行缩放。相比之下,Hadamard 变换会对激活和权重的通道进行旋转与混合,从而将原本集中在少数通道中的离群值重新分布至所有通道,有效降低离群值的影响
- 由于 Hadamard 矩阵具有正交性,即
 ,因此原始线性层可以等价地改写为
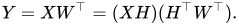
- 首先对激活执行
 变换,同时对权重执行对应的
 变换,而不会改变线性层最终的计算结果。与逐通道缩放类似,变换后的权重可以在模型部署之前进行离线预处理,从而减少 Hadamard 变换在实际推理过程中带来的额外运行时开销
权重与激活的平坦性:在去除离群值之后,分布更加平坦的张量通常更容易进行量化,这类张量通常也具有较低的峰度(Kurtosis)
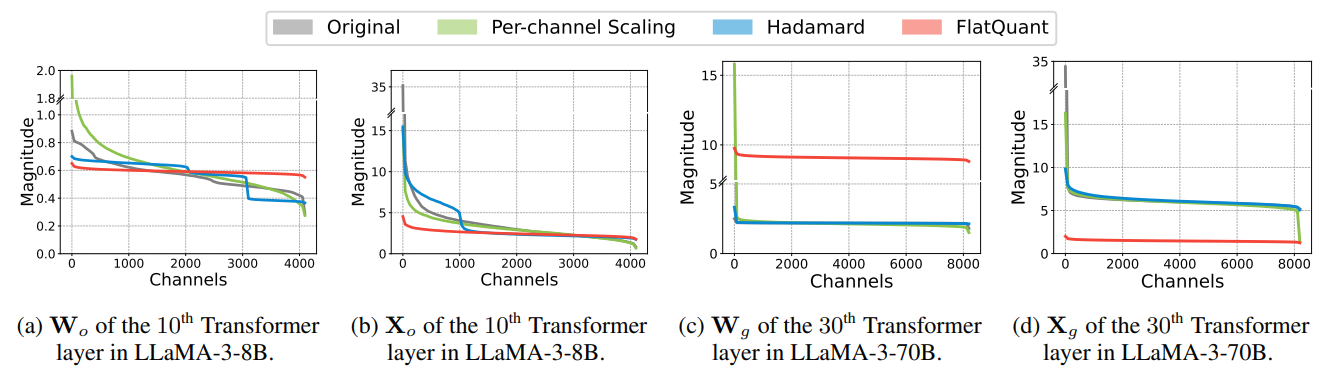
- 与原始分布相比,现有预量化变换虽然能够在一定程度上使激活分布更加平坦,但仍存在明显局限。例如,逐通道缩放可以有效平坦化激活分布,但其代价是使权重分布的包络更加陡峭。该方法实际上是在权重与激活之间重新分配离群值,而无法同时获得平坦的权重和激活分布
- 相比逐通道缩放,Hadamard 变换能够同时改善权重和激活的平坦性,但在部分情况下仍会产生不理想的数值分布
- FLATQUANT 能够更加稳定地同时平坦化权重和激活分布,从而为后续低比特量化提供更加有利的数值条件
量化误差景观的平坦性:量化误差在 Transformer 网络中会不可避免地逐层传播,因此,分析不同预量化变换对量化误差传播的影响具有重要意义
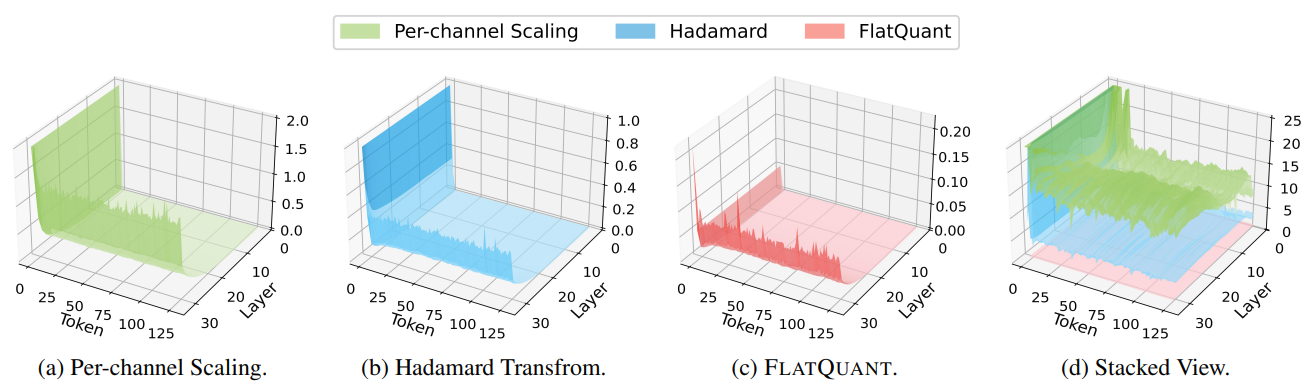
- 输入序列前部的 Token 往往会产生非常显著的量化误差。这类 Token 通常被称为枢轴 Token,其内部往往包含幅度极大的激活离群值。对于这类误差,逐通道缩放和 Hadamard 变换均难以实现有效抑制。相比之下,FLATQUANT 在这些 Pivot Tokens 上表现出显著更低的量化误差
- 其次,量化误差表现出明显的逐层累积现象,即随着 Transformer 层数不断加深,量化误差会持续增大;误差沿输入序列维度的增长趋势并不明显
- FLATQUANT 对量化误差逐层传播的抑制能力最强,其次是 Hadamard 变换,而逐通道缩放的效果相对最弱。这表明,更加平坦的权重与激活分布不仅有利于降低当前层的量化误差,同时还能够有效减缓量化误差在深层 Transformer 网络中的累积与传播
🦢 Fast and Learnable Affine Transformation
FLATQUANT 的核心目标之一,是为每个待量化的线性层寻找最优的仿射变换。对于线性层,可以寻找一个最优的可逆矩阵 ,使量化后的输出与全精度输出之间的误差最小
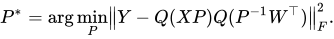
- 其中
 可以在推理之前离线预计算,从而避免在运行时对权重执行额外变换
- 然而,与所有层均可共享同一 Hadamard 矩阵不同,为每个线性层分别维护一个完整的
 具有较高的计算和存储成本。在前向传播过程中,直接使用完整仿射矩阵会使矩阵变换所需的计算量和内存访问量近似翻倍,同时还会使模型额外存储开销接近原模型规模
FLATQUANT 的关键思想是利用两个轻量级矩阵的 Kronecker 积(Kronecker Product),替代规模较大的完整仿射变换矩阵
- 具体而言,将变换矩阵构造为
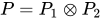 ,其中
 和
 均为规模较小的可逆矩阵,并满足

- 根据 Kronecker 积的向量化性质,对于
 ,有
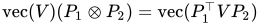 。因此上式中的矩阵乘法可以进一步改写
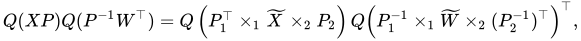
- 其中
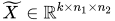 和
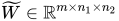 分别由原始的和reshape 得到,
 表示沿第
 个轴执行相应的张量-矩阵乘法。完成变换后,权重和激活均会重新转换为二维矩阵,再执行后续矩阵乘法
- 这种设计能够显著降低仿射变换矩阵的存储开销。完整矩阵
 需要存储
 个元素,而 Kronecker 分解后仅需要存储
 个元素,其压缩比例满足
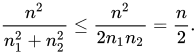 当
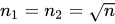 时取等号,因此理论上最多可以将额外存储需求降低约
 倍。在相同的最优条件下,计算开销最高可以降低约
 倍
- 在实际实现中,作者通过以下方式选择
 和

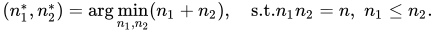
Per-channel Scaling:FLATQUANT 在预量化变换之前显式引入一个可学习的逐通道缩放向量
- 该缩放向量可以成对融合至前一层的 LayerNorm 或线性层参数中,因此不会引入额外的在线推理计算开销。通过这一机制,FLATQUANT 可以首先调整不同通道之间的数值尺度,再利用后续可学习仿射变换进一步重新分布离群值
Learnable Clipping Thresholds:为进一步抑制经过上述变换后仍可能残留的离群值,FLATQUANT 针对每个线性层的权重和激活,以及 KV Cache,引入可学习的裁剪阈值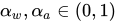 ,并通过 Sigmoid 函数约束其取值范围
- 虽然传统量化方法通常可以通过网格搜索获得较为合理的裁剪阈值,但作者发现,直接通过优化过程学习裁剪阈值能够获得更好的量化效果
- 这些裁剪参数针对不同层分别设置,并可以与线性变换矩阵以及逐通道缩放参数进行联合优化
Training Objective:FLATQUANT 遵循 PTQ 的基本范式,仅使用少量校准数据,例如随机采样的 128 个句子,依次对每个 Transformer Block 进行优化
- 对于第
 个 Transformer Block,作者通过最小化量化模型输出与全精度模型输出之间的均方误差来优化该 Block 中的变换参数
- FLATQUANT 并不重新训练整个模型,而是采用 Block-wise Calibration 的方式,逐个 Transformer Block 优化其中的仿射变换矩阵、逐通道缩放系数以及可学习裁剪阈值,从而在较低训练成本下减小量化引入的局部误差及其后续的逐层传播
🐟 Integration with the Transformer Architecture
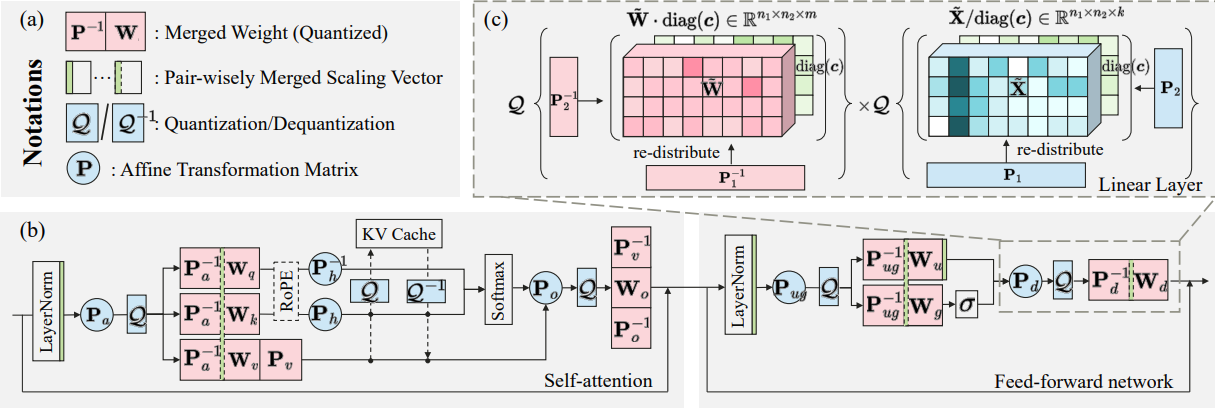
在 Self-Attention 模块中,FLATQUANT 引入四个变换矩阵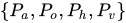 。其中
 用于平坦化 Query、Key 和 Value 投影之前的输入激活,而
 用于平坦化 Output Projection 的输入激活。
 和
 则分别以 Head 为单位,对 Key Cache 和 Value Cache 进行变换
- FLATQUANT 仅对和采用前文介绍的 Kronecker 分解,而和保持完整矩阵形式
- KV Cache 通常采用 Per-head Quantization,而单个 Attention Head 的维度远小于完整 Hidden Size,因此直接进行矩阵变换所产生的计算和存储开销已经较低,无需进一步进行 Kronecker 分解。为进一步降低运行时开销,作者将与进行融合
对于前馈网络,FLATQUANT 使用两个变换矩阵 和

- 其中用于平坦化 LayerNorm 之后、进入 FFN 的输入激活;则用于平坦化 Down Projection 层的输入激活。为尽可能降低推理开销,这两个变换矩阵均采用 Kronecker 分解。此外对应的逐通道缩放参数可以进一步融合至 Up Projection 层的权重中,因此不会引入额外的在线计算开销
已有旋转量化方法通常利用 RMSNorm 的结构特性,将正交变换融合至前序网络层,从而减少额外的推理计算
- 在采用 Pre-Norm 结构的 Transformer 中,由于存在 Residual Connection,如果直接将这类变换融合至 RMSNorm 前后的计算路径中,会使不同 Transformer Block 受到残差连接的约束,从而不得不共享相同的变换矩阵,限制不同层分别学习最优变换的能力
- FLATQUANT 保留原有的 LayerNorm,并允许不同线性层在 LayerNorm 之后分别使用快速且可学习的仿射变换
作者进一步为 FLATQUANT 设计高效 Kernel,将仿射变换与量化操作融合至单个 Kernel 中
- 首先,由于 FLATQUANT 使用两个轻量级矩阵的 Kronecker Product,因此变换
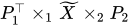 的计算强度较低,使得该操作无论在 Prefill 阶段还是 Decode 阶段都主要表现为 Memory-bound
- 其次,量化操作本身同样属于典型的 Memory-bound 操作。如果分别执行仿射变换和量化,就需要反复将中间结果写入和读取 Global Memory,从而产生额外的内存访问与 Kernel Launch 开销
为解决这一问题,作者基于 OpenAI Triton,将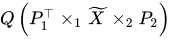 整体融合为一个 Kernel
- Kernel 首先将完整的和加载至片上 SRAM。随后,每个 Thread Block 从
 中切分出一个大小为
 的 Tile,并直接计算矩阵变换
 ,随后立即对计算结果执行量化
- 在整个计算过程中,中间结果始终保存在 SRAM 中,只有最终量化后的结果才会写回 Global Memory。因此,该融合设计避免仿射变换中间结果反复写入和读取 Global Memory 所产生的冗余内存访问,同时减少额外的 Kernel Launch 开销,从而显著降低 FLATQUANT 在线变换的实际推理成本
- 在获得量化后的输出之后,FLATQUANT 进一步采用 CUTLASS Kernel 执行 INT4 矩阵乘法,并使用 FlashInfer 完成 KV Cache 量化
两层权重之间有非线性激活函数: 一般有
FlatQuant:一般可逆矩阵