Policy Optimization I
🕊️ Trust Region Policy Optimization
论文提出一种用于优化控制策略的方法,并能够保证策略性能的单调改进。通过对这一具有理论保证的方案进行若干近似,进一步构造出一种实用算法,称为信赖域策略优化(Trust Region Policy Optimization, TRPO)
大多数策略优化算法可以大致分为三类
- 策略迭代交替执行价值评估与策略改进。在估计当前策略下的价值函数与改进策略之间交替进行
- 策略梯度方法:利用从采样轨迹中得到的期望代价梯度估计来更新策略
- 无导数方法将策略参数优化视为黑盒搜索问题。如交叉熵方法 CEM 和协方差矩阵自适应方法 CMA。将代价函数视为关于策略参数的黑盒函数,并直接对其进行优化
在许多问题中,CEM 和 CMA 等通用无导数随机优化方法往往更受青睐,因为它们不仅能够取得较好的结果,而且易于理解和实现
- 俄罗斯方块是近似动态规划方法中的经典基准问题,但随机优化方法在该任务上仍然很难被超越
- 在连续控制问题中,当给定低维参数化、人工设计的策略类别时,CMA 等方法已经成功地学习到用于复杂任务的控制策略
近似动态规划方法和基于梯度的方法无法稳定地优于无梯度随机搜索,这一点并不令人满意
- 从理论上看,基于梯度的优化算法相较于无梯度方法通常具有更好的样本复杂度保证
- 连续的梯度优化方法已经在监督学习中成功用于训练包含大量参数的函数逼近器。因此,如果能够将这种成功扩展到强化学习领域,就有望更高效地训练复杂而强大的策略模型
作者首先证明:最小化某个特定的代理损失函数,可以在使用非平凡步长的情况下保证策略改进。随后对这一具有理论依据的算法进行一系列近似,从而得到一种实用算法,即信赖域策略优化(TRPO)
🦥 Preliminaries
无限时域折扣马尔可夫决策过程由六元组 定义
 是有限状态集合,
 是有限动作集合,
 表示状态转移概率分布
 是代价函数;
 是初始状态
 的分布;
 是折扣因子
令 表示一个随机策略:
 并令
 表示策略的期望折扣代价
 (1)
标准定义:状态-动作价值函数 、状态价值函数
 ,以及优势函数

 (2)
Performance Difference Lemma:将另一个策略 的期望代价表示为相对于当前策略的优势函数在整个时间步上的累积期望。策略的期望折扣代价,可以写成当前策略的代价
 ,再加上在执行新策略
 所产生的轨迹上,对旧策略优势函数
 的折扣累积期望。其中期望轨迹由新策略采样得到的
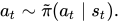
 (3)
令 表示策略下的未归一化折扣状态访问频率
 (4)
其中 ,动作按照策略进行选择。
 衡量的是:在策略下,状态
 在整个无限时域轨迹中被访问的折扣累计频率。将上式从按时间步求和的形式重新整理为按状态求和的形式
 (5)
- 任意一次策略更新
 ,只要在每个状态上都具有非正的期望优势
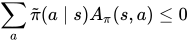 ,就可以保证降低
 ;若期望优势在所有状态上均为零,则
 保持不变
- 精确策略迭代采用确定性策略
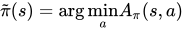 进行更新。若至少存在一个状态-动作对具有负优势值,并且该状态具有非零的状态访问概率,则该更新会改进策略;否则,算法已经收敛
在近似设定下,由于估计误差和近似误差,通常不可避免地会存在某些状态 ,使得期望优势为正
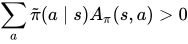 。此外
 对的复杂依赖关系,使得上式难以直接优化。因此引入如下对的局部近似
 (6)
注意 使用的是访问频率
 ,而不是,因此忽略由策略变化所导致的状态访问密度变化。然而,若采用参数化策略
 ,其中
 是关于参数向量
 的可微函数,则与在一阶意义上相匹配。也就是说,对于任意参数值

 (7)
一个足够小的策略更新 ,如果能够改进
 ,也会改进;但并未说明步长应当取多大。Kakade 与 Langford 提出一种称为保守策略迭代的策略更新方案,并能够给出关于改进量的显式下界。为定义保守策略迭代更新,令
 表示当前策略,并假设能够求解
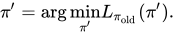 新策略
 被定义为如下混合策略
 (8)
Kakade 和 Langford 对该更新证明如下结果,且 表示
 相对于的最大优势幅度
 (9)
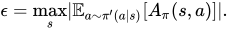 (10)
由于 ,上式蕴含如下更简单的界
 (11)
当 时,这一界只会略微变弱,而这通常正是 Kakade 与 Langford 的保守策略迭代方法所采用的情形。到目前为止,该界仅适用于混合策略。此类策略在实践中较为笨重且受限;因此,一个实用的策略更新方案最好能够适用于一般的随机策略类别
🦨 Monotonic Improvement Guarantee for General Stochastic Policies
上式适用于保守策略迭代,它表明:若某次策略更新能够改进该不等式的右端项,则可保证改进真实的期望代价目标。本文的主要理论结果是:上式中的策略改进界不仅适用于混合策略,也可以推广到一般随机策略;具体做法是用策略与之间的距离度量来替代 。由于混合策略在实践中很少使用,因此这一结果对于将策略改进保证扩展到实际问题至关重要。本文采用的距离度量是总变差散度。对于离散概率分布
 ,其定义为
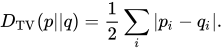 (12)
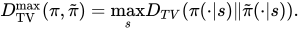 (13)
定理 1: 令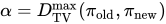 ,并令
 则下式成立
 (14)
总变差散度与 KL 散度之间具有如下关系 。令
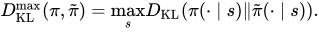
 (15)
算法 1 描述一种基于上式中策略改进界的近似策略迭代方案。目前假设优势值 可以被精确估计。算法 1 能够保证生成一列单调改进的策略,即
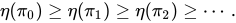
令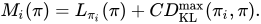 则有
 (16)
因此只要在每次迭代中最小化 ,就可以保证真实目标单调不增。该算法属于上界最小化算法的一种.
 是一个代理函数,它在
 处与相等,并且对构成上界
🐇 Optimization of Parameterized Policies
如何在有限样本数量和任意参数化形式下,从这些理论基础推导出一个实用算法。由于考虑的是带参数的策略,其中 为参数向量,定义
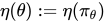 ,
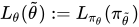 ,以及
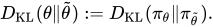 用
 表示待改进的旧策略参数
上一节表明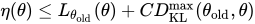 ,并且当
 时等号成立。因此通过求解如下最小化问题,可以保证改进真实目标
 (17)
在实践中,如果直接采用上述理论推荐的惩罚系数 ,则得到的更新步长会非常小。一种能够更稳健地采取较大步长的方法,是对新旧策略之间的 KL 散度施加约束,也就是引入信赖域约束
 (18)
这个问题要求在状态空间中的每一点上,KL 散度都受到约束。尽管该约束具有理论动机,但由于约束数量过多,实际求解并不现实。因此采用一种启发式近似,即考虑平均 KL 散度
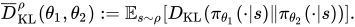 (19)
因此,作者提出通过求解如下优化问题来生成策略更新
 (20)
🦚 Sample-Based Estimation of the Objective and Constraint
上一节提出一个关于策略参数的约束优化问题。该问题在每次更新时,在约束策略变化幅度的条件下,优化期望代价的估计。本节说明如何使用蒙特 Carlo 仿真来近似目标函数和约束函数。展开 后,希望求解如下优化问题
 (21)
首先将目标函数中的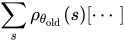 替换为期望形式(下文期望中的状态访问分布均指其归一化形式)
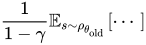 。接着,将优势值
 替换为 Q 值
 ,这只会使目标函数改变一个常数。最后用重要性采样估计器替代对动作的求和。令
 表示采样分布,则单个状态
 对损失函数的贡献为
 (22)
式中的优化问题与下面这个以期望形式表示的问题完全等价
 (23)
剩下的问题就是用样本均值替代这些期望,并用经验估计替代 Q 值
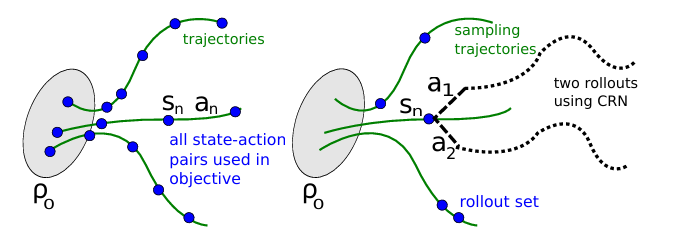
第一种采样方案称为 single path,它通常用于策略梯度估计,基于对单条轨迹的采样。在该估计过程中,首先通过采样 获得初始状态,然后使用策略
 进行若干时间步的仿真,从而生成一条轨迹
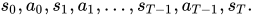 (24)
因此,采样分布为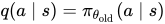 。对于轨迹中的每一个状态-动作对
 ,
 通过沿该轨迹计算未来代价的折扣和来估计,即
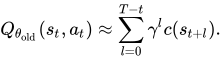
第二种方案称为 vine,它需要先构造一个 rollout 状态集合,然后从该集合中的每个状态出发执行多个动作
- 首先采样
 ,并模拟策略
 生成若干条轨迹。随后从这些轨迹中选取
 个状态
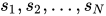 ,并将其称为 rollout 集合。对于 rollout 集合中每个状态,按照
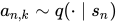 采样 K 个动作。只要
 的支撑集包含
 的支撑集,任意这样的都可以产生一致估计器
- 对于每个状态上采样得到的动作
 ,通过从状态和动作开始执行一次 rollout,即一条短轨迹,估计
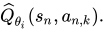 通过在每个状态对应的 K 次 rollout 中使用相同的随机噪声序列,可以显著降低不同 rollout 之间 Q 值差异的方差
- 在较小的有限动作空间中,可以从给定状态出发,对每一个可能动作都生成一次 rollout。单个状态
 对的贡献为
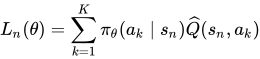 (25)
- 在较大或连续动作空间中,可以使用重要性采样构造代理损失的估计器。该自归一化估计器消除为 Q 值引入 baseline 的需要
 (26)
与 single-path 方法相比,vine 方法的优势在于:在代理损失中使用相同数量的 Q 值样本时,其局部目标估计具有更低的方差。vine 方法能够得到更好的优势值估计。其缺点是,对于每个优势估计,都需要更多次调用仿真器。此外,vine 方法要求从 rollout 集合中的每个状态生成多条轨迹,因此该算法仅适用于系统能够被重置到任意状态的场景
🕊️ Practical Algorithm
基于上述思想提出两种实用的策略优化算法,分别采用 single-path 采样方案或 vine 采样方案。这些算法会重复执行如下步骤
- 使用 single-path 或 vine 过程,收集一组状态-动作对,并通过 Monte Carlo 方法估计其 Q 值
- 对样本取平均,构造目标函数与约束函数的估计
- 近似求解该约束优化问题,从而更新策略参数向量。具体而言,使用共轭梯度算法,并随后进行线搜索
在实际操作中,直接求解带有约束的优化问题通常比较复杂。因此,TRPO 在实现时引入进一步的近似处理。对目标函数和约束分别在 处做泰勒展开,目标函数用一阶近似,约束用二阶近似
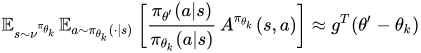 (27)
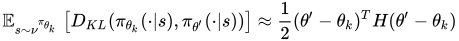 (28)
优化目标被转化为如下的二次约束优化问题
 (29)
 (30)
 (31)
用卡罗需-库恩-塔克(Karush-Kuhn-Tucker,KKT)条件直接导出上述问题的解
 (32)
𝓒𝓸𝓷𝓳𝓾𝓰𝓪𝓽𝓮 𝓖𝓻𝓪𝓭𝓲𝓮𝓷𝓽:在强化学习实际应用中,策略网络通常拥有成千上万甚至更多的参数。对于带有二次约束的优化问题,理论上需要用到 Hessian 矩阵的逆,而直接计算和存储这样的大矩阵在计算和内存上都极其昂贵。为解决这个问题,TRPO 采用共轭梯度法。假设参数更新的方向为 ,KL 距离约束下允许的最大步长记为
 。根据约束条件:
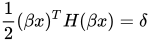 ,求解,得到
 (33)
𝓛𝓲𝓷𝓮 𝓢𝓮𝓪𝓻𝓬𝓱:由于 TRPO 算法的参数更新是基于目标函数和 KL 散度约束的一阶、二阶泰勒近似,这种近似本身不是严格精确的,因此有可能计算得到的新参数 并不能保证一定比当前参数更优,也可能不满足 KL 散度的限制条件。为解决这个问题,TRPO 在每次参数更新前都会进行一次线性搜索(Line Search),确保新的参数既满足 KL 散度的约束,同时也能降低代理代价
- 沿着共轭梯度方向(即上一步计算得到的更新方向),尝试不同的步长
- 通常用指数衰减的方式缩小步长,也就是不断尝试
 倍的步长(其中是一个小于 1 的常数,
 是非负整数)
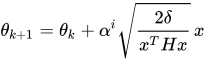 (34)
总结第 3 节中的理论与本文实际算法之间的关系
- 理论上应当优化一个带 KL 散度惩罚项的代理损失。然而,理论给出的较大惩罚系数
 会导致更新步长过小,因此希望减小该系数。经验上,稳健地选择惩罚系数较为困难,所以改用硬约束代替惩罚项,并使用参数
 作为 KL 散度上界
- 对
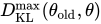 施加约束在数值优化和估计上较为困难,因此改为约束平均 KL 散度

🐳 Connections with Prior Work
作者的推导得到的策略更新与若干已有方法相关,从而为多种策略更新方案提供一个统一视角。自然策略梯度可以看作一个特例:对 采用线性近似,并对
 约束采用二次近似,从而得到如下问题
 (35)
其更新形式为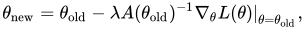 其中拉格朗日乘子
 通常被视为算法超参数。作者在每次更新时显式强制满足约束。标准策略梯度更新也可以通过使用
 约束或惩罚得到
 (36)
策略迭代更新也可以通过求解无约束问题 得到。还有若干方法采用相似的更新形式。相对熵策略搜索约束的是状态-动作边缘分布
 ,而 TRPO 约束的是条件分布

🕊️ GENERALIZED ADVANTAGE ESTIMATION (GAE)
策略梯度方法是强化学习领域中一类重要的优化范式,其核心优势在于能够直接以累积奖励最大化为目标,并可自然地结合神经网络等非线性函数逼近器进行策略表示
- 两个关键挑战:一方面,策略梯度估计通常具有较高方差,导致算法需要大量交互样本才能获得有效更新;另一方面,由于训练过程中采集的数据分布会随策略更新而不断变化,输入数据呈现显著的非平稳性,从而使算法难以实现稳定且持续的性能提升
- 针对前一问题,作者引入价值函数来降低策略梯度估计的方差,并在允许一定估计偏差的前提下,构造一种与
 思想相近的优势函数指数加权估计器
- 针对后一问题,作者进一步将信赖域优化机制同时应用于策略函数和价值函数的训练过程,并采用神经网络对二者进行参数化建模
强化学习中的典型问题形式是最大化某一策略的期望总奖励
- 该问题的一个核心难点在于:动作与其对奖励产生的正面或负面影响之间往往存在较长的时间延迟。这一问题在强化学习文献中被称为信用分配问题,而在行为学文献中则被称为远端奖励问题
- 价值函数为解决信用分配问题提供一种优雅的思路:它能够在延迟奖励真正到来之前,估计某一动作的优劣程度。强化学习算法会以多种不同方式利用价值函数;本文关注的是这样一类算法:它们优化参数化策略,并借助价值函数来估计策略应当如何改进
- 当使用参数化随机策略时,可以获得期望总回报梯度的无偏估计。这些带噪声的梯度估计可用于随机梯度上升算法。然而,这种梯度估计器的方差会随着时间跨度的增长而不利地扩大,因为某个动作的影响会与过去动作和未来动作的影响相互混杂
- actor-critic 方法使用价值函数而非经验回报,从而以引入偏差为代价获得较低方差的估计器。尽管高方差会迫使算法使用更多样本,偏差却更加棘手:即使拥有无限数量的样本,偏差仍可能导致算法无法收敛,或者收敛到一个较差的解,而该解甚至并非局部最优解
作者提出一族策略梯度估计器,它们能够显著降低方差,同时将偏差维持在可接受的水平。将这种由 和
 参数化的估计方案称为广义优势估计。同时还讨论将该方法解释为一种奖励塑形实例的视角,其中近似价值函数被用于对奖励进行塑形
- 作者对广义优势估计提供系统的理论依据与直观解释,并说明该方法能够作为一种有效的策略梯度方差降低方案
- 将信赖域优化方法用于价值函数训练,并表明该方法能够以鲁棒且高效的方式优化包含大量参数的神经网络价值函数
- 将广义优势估计与价值函数的信赖域优化相结合,构建出一种能够有效学习神经网络策略的强化学习算法,并在高维连续控制任务中取得较好的实验效果
🦊 PRELIMINARIES
作者首先给出无折扣策略优化问题的基本设定,再说明策略梯度可以通过不同形式的 来构造。不同的本质上都是对当前动作长期贡献的估计,并在方差、偏差和稳定性之间形成不同权衡
- 策略梯度方法通过反复估计梯度
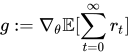 来最大化期望总奖励。策略梯度存在若干相互关联的表达形式,通常为
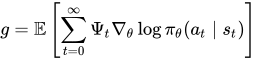 (1)
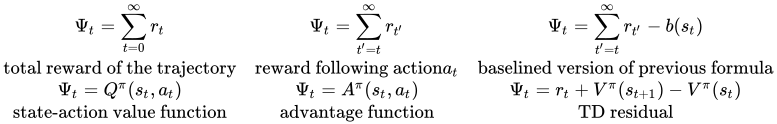 (2)
- 价值函数的值是对未来奖励的预测,可以用它来评估状态的好坏
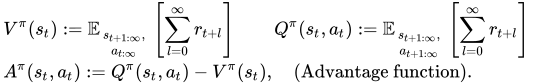 (3)
选择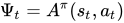 几乎能够得到最低方差的策略梯度估计:沿策略梯度方向进行更新,应当提高优于平均水平动作的选择概率,同时降低劣于平均水平动作的选择概率
- 根据优势函数的定义
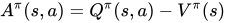 ,它衡量的是某一动作相对于当前策略默认行为而言是更优还是更差
- 选择
 为优势函数
 ,使得梯度项
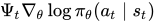 当且仅当
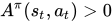 时,指向增大
 的方向
原始问题虽被设定为无折扣目标,但作者仍引入 作为算法层面的方差控制参数。较小的
 会降低远期奖励对当前梯度估计的影响,从而减少方差;但由于远期影响被削弱,估计也会偏离原始无折扣目标,因此会引入一定偏差
- 折扣价值函数定义如下
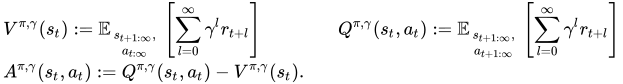 (4)
- 策略梯度的折扣近似形式定义如下
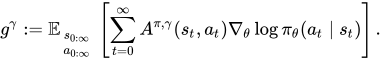 (5)
引入优势函数的 γ-just 估计器:所谓 γ-just 估计器,是指当用它替代未知且需要估计的 来估计
 时,不会引入偏差的估计器。考虑一个优势估计器
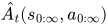 ,一般而言,它可以是整条轨迹的函数
定义(γ-just 估计器)。 若估计器
- 如果
 对所有时间步都是
 的,则有
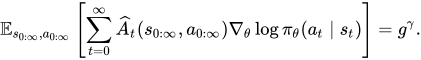 (7)
- 若优势估计器
 可以表示为未来回报的无偏估计与历史信息构造的基线项之差,则该估计器不会改变策略梯度估计的期望方向,因此是
 的。具体而言,
 负责无偏估计 γ-折扣状态-动作价值函数
 ,而
 只能依赖于动作
 之前的历史信息,因此不会对当前动作的梯度估计引入偏差
命题 1(γ-just 的充分条件)。 假设估计器可以写为
且对所有
则
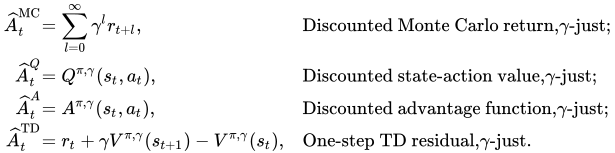 (10)
🦒 ADVANTAGE FUNCTION ESTIMATION
本节主要讨论如何构造折扣优势函数 的准确估计量,并利用该估计量构造如下形式的策略梯度估计器
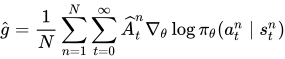 (11)
其中 表示一个 episode 批量中的第条轨迹。令
 表示一个近似价值函数,并定义
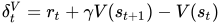 (12)
即价值函数 在折扣因子下的时间差分残差,简称 TD residual。
 可以被视为动作优势值的一个估计量。如果价值函数是准确的,即
 ,那么是一个满足 γ-just 条件的优势估计器,并且是的无偏估计
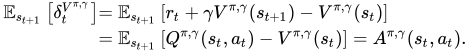 (13)
接下来,考虑对连续 个项进行加权求和,并将其记为
 。具体形式如下
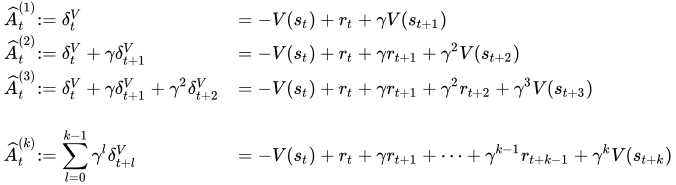 (14)
上述等式来自望远镜求和。本质上是一个 k-step 回报估计,再减去基线项 。类似于
 的情况,也可以被视为优势函数的估计量,并且只有当
 时才满足 γ-just 条件。随着
 ,该估计量的偏差通常会逐渐减小。末端 bootstrap 项
 会随着
 的增大受到更强的折扣影响,而基线项
 本身不会影响策略梯度估计的偏差
当 时,该估计量等价于折扣 Monte Carlo 回报减去价值函数基线
 (15)
TD 残差
广义优势估计器 被定义为这些 k-step 优势估计器的指数加权平均
 (16)
- 广义优势估计器实际上是对一系列 Bellman 残差,也就是 TD 残差,进行折扣累加得到的。它不再显式地写成多个 k-step 回报估计的加权平均,而是等价地表示为 TD 残差的指数加权和
- 上述构造方式与
 的定义具有高度相似性。用于估计价值函数,用于估计优势函数
公式有两个重要的特殊情形,分别对应于 和

 (17)
 无论价值函数的准确性如何,都满足 γ-just 条件,但由于其包含多项累加,因此通常具有较高方差
 只有在时才满足 γ-just 条件;若价值函数不准确,则会引入偏差,但其方差通常显著更低
- 对于
 的一般情形,广义优势估计器在偏差与方差之间进行折中,而这一折中由参数
 控制
上述优势估计器包含两个独立参数和。当使用近似价值函数时,二者都会影响偏差—方差权衡
- 参数主要决定折扣价值函数
 的尺度,而该价值函数并不依赖于。取
 会在策略梯度估计中引入偏差,无论价值函数是否准确
- 相较之下,取
 只有在价值函数不准确时才会引入偏差
- 最优的通常明显小于最优的,可能是因为在价值函数较为准确的情况下,所引入的偏差远小于所引入的偏差
利用广义优势估计器,可以构造折扣策略梯度的一个有偏估计器
 (18)
🐬 INTERPRETATION AS REWARD SHAPING
奖励塑形是指对马尔可夫决策过程的奖励函数进行如下变换。设 为定义在状态空间上的任意标量函数,并将变换后的奖励函数定义为
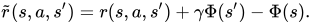 (19)
该变换进一步定义一个新的马尔可夫决策过程。对于任意策略 ,这一变换不会改变其折扣优势函数。考虑一条从状态
 出发的轨迹。变换后奖励的折扣累积回报为
 (20)
其中与势函数 有关的各项在求和过程中发生望远镜式消去,最终仅保留初始状态对应的项
 。记
 、
 和
 分别为变换后马尔可夫决策过程中的动作价值函数、状态价值函数和优势函数。可以得到
 (21)
- 当优化目标为最大化折扣累积奖励
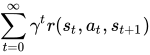 时,奖励塑形变换不会改变策略梯度与最优策略
使用塑形奖励 的折扣累积和来构造策略梯度估计器。该折扣累积和等价于原马尔可夫决策过程中奖励
 的折扣累积和减去一个基线项。进一步考虑采用更强的折扣因子
 ,其中
 。令
 时,塑形奖励
 恰好等于贝尔曼残差

 (22)
- 因此对塑形奖励采用
 折扣累加,恰好可以得到广义优势估计。当时,该估计是的无偏估计;当时,若价值函数不准确,则可能引入偏差
为进一步分析奖励塑形变换以及参数和的影响,作者引入响应函数 ,其定义为
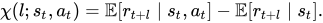 (23)
- 注意到
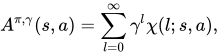 因此响应函数
 描述当前动作对未来第
 个时间步奖励的影响,而优势函数则是这些影响的折扣累积。由此,时间信用分配问题可以表述为:若动作对较远期奖励仍具有显著影响,则响应函数在较大的处仍不为零
重新考察折扣因子,以及以近似 所带来的影响。折扣策略梯度估计器包含如下形式的项
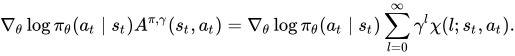 (24)
- 采用
 的折扣因子,实际上会显著削弱时间延迟超过约
 的奖励项。因此当响应函数
 随时间延迟的增加而快速衰减时,使用近似所引入的误差较小。若某一动作对未来奖励的影响在约个时间步后便基本消失,则该折扣近似是较为合理的
若塑形奖励是在令 的条件下得到的,则对于
 ,有
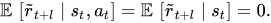 响应函数仅在
 时非零。因此,该奖励塑形变换能够将原本跨越多个时间步的延迟响应转化为即时响应
- 由于精确的价值函数可以完全消除响应函数在时间维度上的延展,因此可以期望,一个较好的近似价值函数
 也能够在一定程度上缩短其时间跨度
- 首先利用价值函数对奖励进行重塑,以缩短响应函数的时间范围;随后引入更强的折扣因子,以滤除长时间延迟带来的噪声,即忽略满足
 时的项
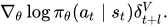
- 利用价值函数将长期延迟的信用分配转化为更接近当前时刻的学习信号。随后,GAE 对这些 TD 残差进行加权累积。价值函数
 负责将远期奖励的信息提前压缩到当前的 TD 残差中,而控制还需要保留多少远期 TD 残差信息
🦉 VALUE FUNCTION ESTIMATION
价值函数可以采用多种方法进行估计。当使用非线性函数逼近器表示价值函数时,最直接的方法是求解如下非线性回归问题
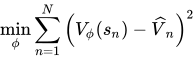 (25)
- 其中
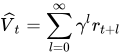 表示从时刻
 开始的折扣累积奖励。该方法通常被称为价值函数估计的蒙特卡洛方法或 TD(1) 方法
作者在每轮批量优化过程中采用信赖域方法对价值函数进行优化,以避免模型过度拟合最近采集的一批数据。为构造相应的信赖域优化问题,首先计算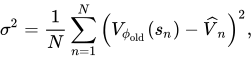 其中
 表示优化前的价值函数参数。随后求解如下约束优化问题
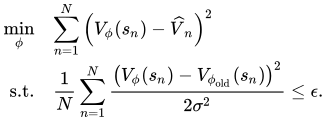 (26)
- 该约束等价于将更新前后价值函数之间的平均 KL 散度限制在以内。其中,价值函数被视为一个条件高斯分布的参数化形式,其均值为
 ,方差为

作者采用共轭梯度算法求解上述信赖域问题的近似解。具体而言,作者求解如下二次规划问题
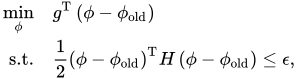 (27)
- 其中
 为目标函数关于参数
 在旧参数处的梯度,

- 在共轭梯度算法中,通过计算矩阵—向量乘积
 ,近似获得搜索方向
 随后,对搜索方向进行缩放
 ,使其满足信赖域边界条件
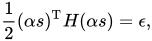 并据此更新价值函数参数
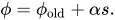
🕊️ Proximal Policy Optimization Algorithms
作者提出一类新的用于强化学习的策略梯度方法。该类方法在两个过程之间交替进行:一方面,通过与环境交互来采样数据;另一方面,利用随机梯度上升方法对一个替代目标函数进行优化
- 与标准策略梯度方法通常对每个数据样本只执行一次梯度更新不同,作者提出一种新的目标函数,使得算法能够在同一批采样数据上进行多个 epoch 的小批量更新。将这类新方法称为近端策略优化算法,即 Proximal Policy Optimization
- PPO 继承信赖域策略优化算法的部分优点,但在实现上更加简单,适用范围更广,并且在经验上具有更好的样本复杂度
近年来,研究者提出多种基于神经网络函数逼近器的强化学习方法。其中较具代表性的竞争方法包括深度 Q 学习、普通策略梯度方法,以及信赖域或自然策略梯度方法。然而,现有方法在可扩展性、数据效率和鲁棒性方面仍然存在改进空间
- 带有函数逼近的 Q 学习在许多简单问题上也可能失败,且其理论机制尚未得到充分理解
- 普通策略梯度方法通常存在数据效率较低和鲁棒性不足的问题
- 信赖域策略优化虽然性能可靠,但算法相对复杂,并且不适用于包含噪声机制的网络结构,例如 dropout,也不便于处理策略网络与价值函数网络之间存在参数共享,或与辅助任务共享参数的架构
- TRPO 属于近似二阶策略优化方法,其核心在于将目标函数进行一阶近似、将 KL 约束进行二阶近似,并利用 Fisher 信息矩阵刻画策略分布的局部曲率,从而得到自然梯度形式的更新方向,在控制策略变化幅度的同时提升更新稳定性
旨在通过提出一种新的算法来改善上述状况。该算法能够在一定程度上达到 TRPO 的数据效率和稳定性能,同时仅依赖一阶优化方法
- 提出一种基于截断概率比的新型目标函数,该目标函数是未截断代理目标的下界,不直接保证真实策略回报的下界
🦫 Background: Policy Optimization
策略梯度方法的基本思想:首先构造策略梯度的估计量,然后将该估计量代入随机梯度上升算法中进行优化。常用的梯度估计器形式为
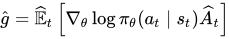 (1)
- 其中
 表示一个随机策略,表示时间步上优势函数的估计值。
 表示在有限批量样本上的经验平均,该算法通常在采样阶段和优化阶段之间交替进行
在使用自动微分软件进行实现时,通常会构造一个目标函数,使其梯度恰好对应于策略梯度估计器。也就是说,估计量 可以通过对如下目标函数求导得到
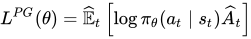 (2)
- 尽管在同一条轨迹数据上对该损失函数
 执行多步优化在直觉上具有一定吸引力,但这种做法并没有充分的理论依据支持;并且在经验上,它往往会导致策略更新幅度过大,从而对训练产生破坏性影响
在 TRPO 中,算法通过在策略更新幅度受限的条件下最大化一个目标函数,即所谓的替代目标函数。具体而言,其优化问题可以写作
 (3)
- 其中表示策略更新之前的参数向量。该约束优化问题通常可以在对目标函数进行线性近似、并对约束项进行二次近似之后,利用共轭梯度算法进行高效的近似求解
实际上,用于支撑 TRPO 的理论结果更倾向于建议使用惩罚项而不是硬约束。换言之,可以考虑求解如下无约束优化问题
 (4)
- 其中是惩罚系数。之所以可以采用这种形式,是因为某个特定的替代目标函数可以构成策略性能的下界,即一种保守的、悲观的性能界。需要注意的是,该理论中的替代目标函数使用的是所有状态上的最大 KL 散度,而不是平均 KL 散度
然而,TRPO 最终采用的是硬约束形式,而不是惩罚项形式。原因在于,很难选择一个固定的值,使其能够在不同问题上都取得良好效果;即使是在同一个问题中,随着学习过程的推进,问题本身的性质也会发生变化,因此单一的惩罚系数往往难以始终适用
因此,如果目标是设计一种仅依赖一阶优化、同时又能够模拟 TRPO 单调改进性质的算法,那么实验结果表明,仅仅选择一个固定的惩罚系数 ,并使用随机梯度上升方法优化公式中的惩罚目标,是不充分的;为达到这一目标,还需要引入额外的改进机制
🦅 CLIPPED SURROGATE OBJECTIVE
令 表示概率比值
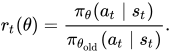 因此有
 。TRPO 最大化如下替代目标函数
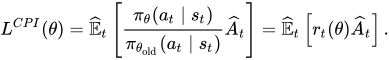 (5)
- 其中上标 CPI 指的是 Conservative Policy Iteration,即保守策略迭代。在该方法中,上述目标函数最早被提出。如果不对其施加约束,直接最大化
 将会导致策略更新幅度过大。接下来考虑如何修改该目标函数,以惩罚那些使偏离 1 的策略变化
作者提出的核心目标函数如下
 (6)
- 其中是一个超参数,可以取
 。
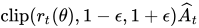 通过对概率比值进行截断来修改替代目标函数。作用是:当沿着提高该样本代理目标的方向超出区间
 时,该样本项不再提供继续推动远离该区间的优化激励
最后在截断目标和未截断目标之间取较小值,因此最终目标函数是未截断代理目标的一个下界。采用这种设计后,当概率比值 的变化会使目标函数获得过大的正向提升时,PPO 会通过截断机制抑制这种额外收益;而当这种变化会降低目标函数时,算法不会将其截断掉,而是保留其负面影响,从而避免策略更新过于激进
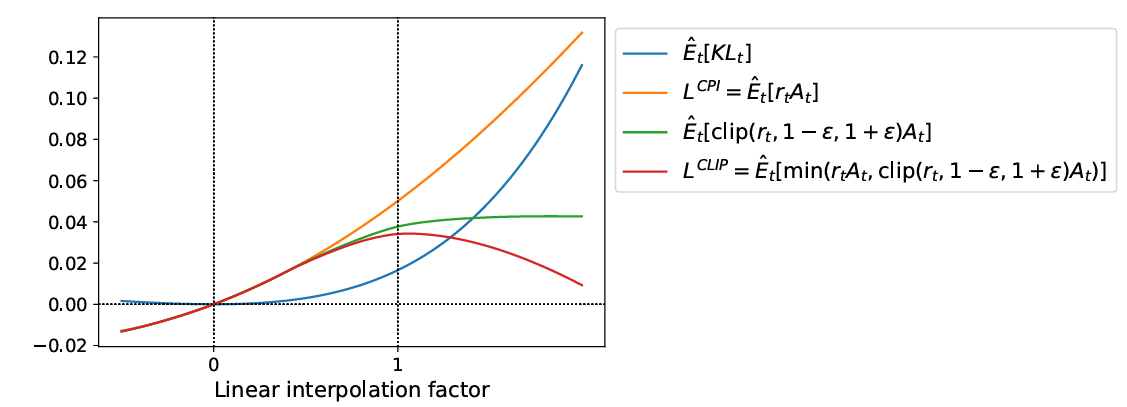
在附近,也就是 附近,
 与
 在一阶近似意义下是相同的。然而,随着逐渐远离,二者将开始产生差异
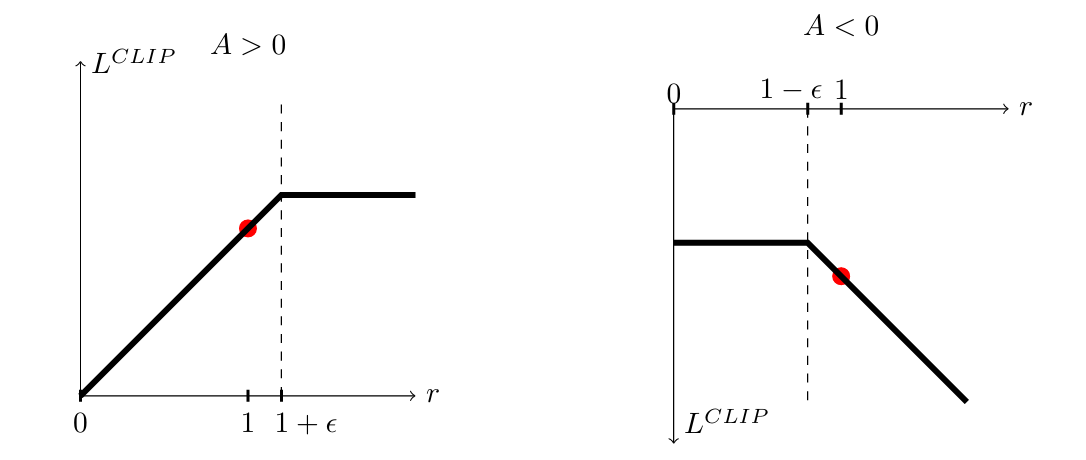
- 概率比值在该样本的目标项中,会根据优势函数的正负截断到
 或
 。具体而言,当优势函数为正时,过大的概率比值不再增加该样本目标;当优势函数为负时,过小的概率比值不再增加该样本目标。该机制不保证实际概率比值始终位于截断区间内
 是的一个下界,并且会对过大的策略更新施加惩罚
🦎 Adaptive KL Penalty Coefficient
另一种方法是对 KL 散度引入惩罚项。这种方法既可以作为截断替代目标函数的替代方案,也可以与截断替代目标函数结合使用。其基本思想是:在每次策略更新中,通过自适应地调整 KL 惩罚系数,使实际的 KL 散度接近某个目标值
在实验中,KL 惩罚方法的表现不如截断替代目标函数。在该算法最简单的实现形式中,每次策略更新包含以下步骤
- 首先使用若干个 epoch 的小批量随机梯度上升方法,优化带有 KL 惩罚项的目标函数
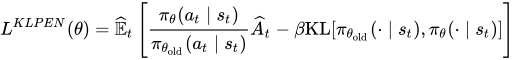 (7)
- 然后计算当前策略更新前后之间的平均 KL 散度
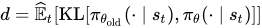 (8)
- 接着根据
 与目标 KL 散度的关系,自适应调整惩罚系数
 (9)
🦉 Algorithm
对于使用自动微分的软件实现而言,只需要构造或 作为损失函数,而不是原始的,然后在该目标函数上执行多步随机梯度上升即可。大多数用于计算低方差优势函数估计量的方法,都会使用一个学习得到的状态价值函数

如果采用一种在策略函数和价值函数之间共享参数的神经网络结构,则必须使用一个同时包含策略替代目标和价值函数误差项的联合损失函数。为保证充分探索,该目标函数还可以进一步加入熵奖励项。将这些项结合起来,可以得到如下目标函数
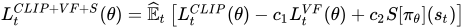 (10)
- 其中
 和
 是权重系数,
 表示熵奖励项,
 表示价值函数的平方误差损失
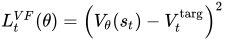
PPO 可基于固定长度 rollout 进行更新,即每次采集 T 步轨迹后立即优化策略;相应地,优势估计仅使用片段内信息,并通过 对片段外未来回报进行 bootstrap
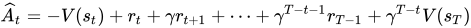 (11)
- 其中
 表示在长度为
 的轨迹片段中的时间索引,且
 。该式的含义是:从当前状态
 出发,累积到片段末尾
 为止的折扣奖励,并使用对片段之后的未来回报进行 bootstrap,然后减去当前状态价值,从而得到优势估计
进一步地,可以将上述有限时域优势估计推广为截断形式的广义优势估计
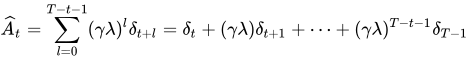 (12)
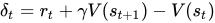 (13)