Speculative Decoding II
🌿 EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
自回归解码是大语言模型事实上的标准解码方式。由于其按照顺序逐个生成 token ,生成过程速度较慢且成本高昂。基于投机采样的方法通过将这一过程划分为低开销的草稿生成阶段,以及对草稿 token 进行并行处理的验证阶段,使大语言模型能够在一次前向传播中验证多个 token
- 这些方法通过在每次前向传播中生成多个 token 来加速生成。更重要的是,验证阶段确保生成文本的分布与原始大语言模型的解码结果精确一致,从而保持生成内容的一致性
- 应用投机采样的关键,在于找到一个能够近似复现原始大语言模型功能、同时具有更低延迟的草稿模型,通常采用同一大语言模型系列中参数量较小的版本。专门为投机采样训练一个规模适当的新草稿模型,也并非理想的解决方案,因为训练成本高昂
提高投机采样加速效果的关键,在于降低时间开销,并提高草稿被原始大语言模型接受的概率。许多方法着重降低草稿生成阶段的开销
- Lookahead 采用 n-gram 和 Jacobi 迭代,而 Medusa 则利用一组多层感知机,根据原始大语言模型倒数第二层的特征预测 token
- 这些策略显著降低草稿生成的延迟,从而改善加速效果。然而,所生成草稿的准确率较低,限制这些方法的效果
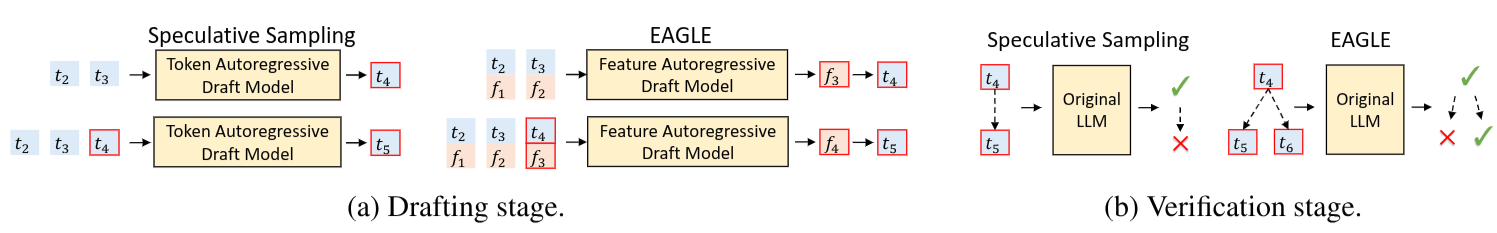
EAGLE 通过预测特征并引入提前一个时间步的 token 序列,提高草稿生成的准确性,其设计基于以下两项观察
- 首先,在特征层面进行自回归预测,比在 token 层面进行自回归预测更为简单。特征指原始大语言模型倒数第二层的特征,即位于语言模型输出头之前的表示。 token 序列只是自然语言的简单转换形式,相比之下,特征序列表现出更强的规律性。在特征层面进行自回归预测,再利用原始大语言模型的 LM head 得到 token ,其效果优于直接以自回归方式预测 token
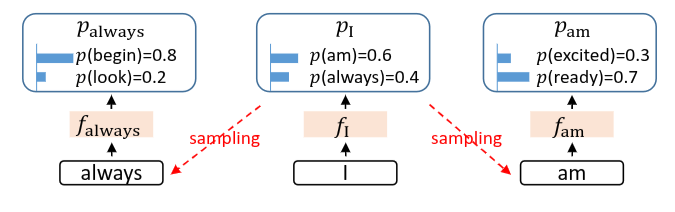
- 其次,采样过程固有的不确定性,显著限制下一特征预测的性能。在文本生成过程中,目标大语言模型预测 token 的概率分布,并据此进行采样,从而引入随机性。然而,特征具有高维、连续的性质,无法采用相同的方式处理。采样得到不同的 token ,会产生不同的特征序列,从而为特征层面的自回归预测引入歧义。为解决这一问题,EAGLE 将相对于特征序列提前一个时间步的 token 序列输入草稿模型,该序列包含采样结果
🍀 Extrapolation Algorithm for Greater Language-model Efficiency
输入序列 首先通过嵌入层转换为嵌入序列
 ,随后转换为特征序列
 。语言模型输出头将
 映射为概率分布
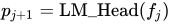 ,再从该分布中采样得到下一个 token
 。因此,对于任意整数
 ,标准的 token 级自回归过程可以表示为
EAGLE 在特征层面自回归生成草稿,再通过目标模型的 LM head 得到 token 分布
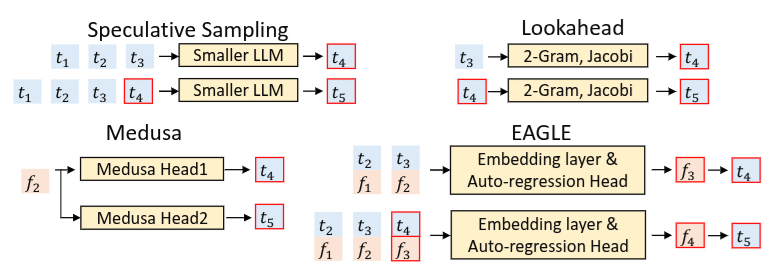
- 投机采样和 Lookahead 均根据 token 预测 token ;Medusa 利用目标大语言模型的特征
 ,分别独立预测
 和

- EAGLE 则利用特征序列
 ,以及相对于特征序列提前一个时间步的 token 序列
 ,预测特征
 。随后,从分布
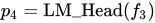 中采样得到。接着,将和追加至输入序列,以预测下一特征
 ,并采样得到后续 token
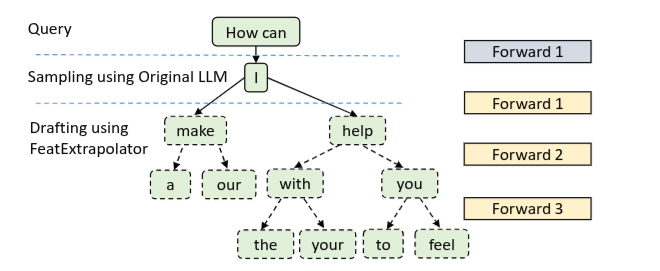
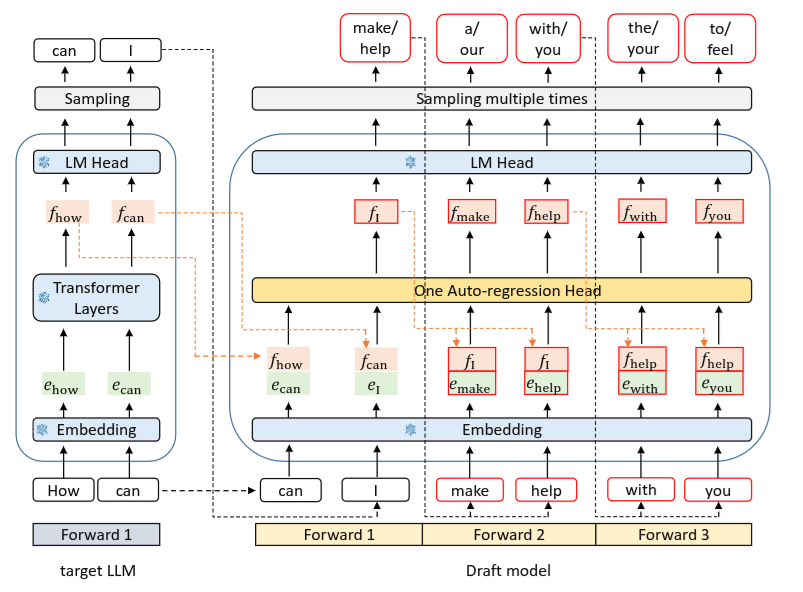
目标模型:How can → f_can → LMHead → softmax → 采样 I
初始化:S = [f_How, f_can],E = [e_can, e_I]

每轮草稿计算:配对输入 → Concat → FC → DraftDecoder → 取末位输出

第 1 轮
  配对输入 = [(f_How, e_can), (f_can, e_I)]
  末位输出 f_hat_I → LMHead → softmax → 采样 do
  更新 S = [f_How, f_can, f_hat_I],E = [e_can, e_I, e_do]

第 2 轮
  配对输入 = [(f_How, e_can), (f_can, e_I), (f_hat_I, e_do)]
  末位输出 f_hat_do → LMHead → softmax → 采样 it
  更新 S = [f_How, f_can, f_hat_I, f_hat_do],E = [e_can, e_I, e_do, e_it]

第 3 轮
  在历史输入之后新增配对 (f_hat_do, e_it)
  末位输出 f_hat_it → LMHead → softmax → 采样下一个草稿 token
EAGLE 的草稿模型由三个模块组成:嵌入层、语言模型输出头和自回归头。嵌入层和语言模型输出头使用目标大语言模型的参数,无需额外训练。草稿模型接收两个输入:形状为(bs, seq_len, hidden_dim)的特征序列,以及形状为(bs, seq_len) 的、提前一个时间步的 token 序列
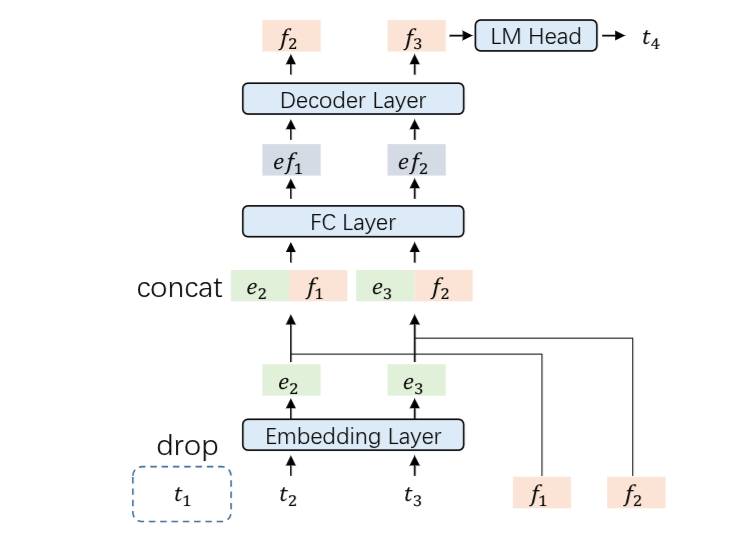
- token 序列转换为形状为
(bs, seq_len, hidden_dim)的 token 嵌入序列;与特征序列拼接,得到形状为(bs, seq_len, 2 × hidden_dim)的融合序列 - 自回归头由一个全连接层和一个解码器层组成。全连接层将融合序列的形状降为
(bs, seq_len, hidden_dim),随后由解码器层预测下一特征。语言模型输出头根据该特征计算概率分布,并从中采样得到下一个 token 。最后,将预测特征和采样得到的 token 追加至输入,以继续执行自回归过程 - EAGLE 使用树形注意力构建树形草稿,通过
 次前向传播生成深度为、 token 数量超过的草稿树
草稿模型通过 Smooth L1 损失学习预测下一特征
- 特征预测是草稿模型的中间目标,其最终目标是通过预测 token 来生成 token 序列。因此采用分类损失,直接针对这一最终目标进行优化
- 结合回归损失和分类损失,使用联合损失函数
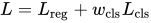 训练自回归头。通常,分类损失在数值上比回归损失大一个数量级
- 理想情况下,EAGLE 的自回归头应当使用目标大语言模型以自回归方式生成的文本进行训练,但这种方式开销较高。所幸,EAGLE 对训练数据的敏感性较低。不使用目标大语言模型生成的文本,而是采用固定的数据集,从而显著降低开销
- 在草稿生成阶段,EAGLE 在特征层面执行自回归预测,而特征预测的不准确可能导致误差累积。为缓解这一问题,采用数据增强:在训练过程中,向目标大语言模型的特征添加从均匀分布
 中采样的随机噪声
借助树形注意力,目标大语言模型仅需一次前向传播,即可计算树形草稿中每个 token 的概率。在草稿树的每个节点上,递归应用投机采样算法进行采样或调整分布。处理方式与 SpecInfer 一致,能够确保输出文本的分布与目标大语言模型的分布保持一致。同时记录被接受的 token 及其特征,供下一轮草稿生成使用
🌿 EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees
投机采样通过快速生成草稿 token,再由目标模型并行验证,在一次前向传播中接受多个 token,从而降低推理延迟
- 标准投机采样采用链式结构的草稿。为增加接受长度,近期的投机采样研究开始采用树形结构的草稿。Sequoia 明确假设,草稿 token 的接受率仅取决于其在树中的位置
- EAGLE 和 Medusa 则在所有上下文中使用相同的静态草稿树结构:在草稿生成阶段的第
 步,添加
 个候选,其中为固定值。这实际上隐含上述假设。然而,这一假设似乎与投机采样所依据的认识相矛盾,即某些 token 更易预测,可以由较小的模型完成预测
- 实验表明,草稿 token 的接受率不仅取决于位置,而且高度依赖于上下文。因此,静态草稿树结构存在固有的局限性。根据不同上下文中草稿 token 的接受率,动态调整草稿树结构,可以获得更好的效果
获取草稿 token 的接受率需要原始大语言模型的前向计算结果,这与投机采样旨在减少原始大语言模型前向传播次数的目标相冲突。所幸 EAGLE 具有良好的校准性:草稿模型的置信度分数能够较好地近似草稿 token 的接受率。这一发现使得采用依赖上下文的动态草稿树结构成为可能
- EAGLE-2 利用草稿模型的置信度分数近似估计接受率,并据此动态调整草稿树结构,从而增加被接受的 token 数量
- 相较于 EAGLE,EAGLE-2 无需额外训练;它直接利用现有草稿模型输出的置信度分数调整草稿树结构
- EAGLE-2 不对原始大语言模型进行微调或参数更新,也不放宽接受条件。可以从理论上保证,生成文本的分布与原始大语言模型的分布完全一致
🍄 Context-Dependent Acceptance Rates
首先,评估采用动态草稿树的必要性。这取决于草稿 token 的接受率是否仅与其所在位置有关
- 使用 Vicuna 7B,在 Alpaca 数据集上测试草稿树中不同位置 token 的接受率。总体而言,草稿 token 的接受率具有位置依赖性:位置 P1 的接受率最高,位置 P6 的接受率最低。草稿树左上方的 token 具有较高的接受率,而右下方的 token 的接受率较低。这为 EAGLE 和 Medusa 等方法所采用的静态草稿树中左上方配置较多节点、右下方配置较少节点的设计提供合理性依据
- 同一位置的接受率存在较大的方差,表明草稿 token 被接受的概率不仅取决于其位置,还取决于上下文。这说明,与静态草稿树相比,上下文感知的动态草稿树具有更大的潜力
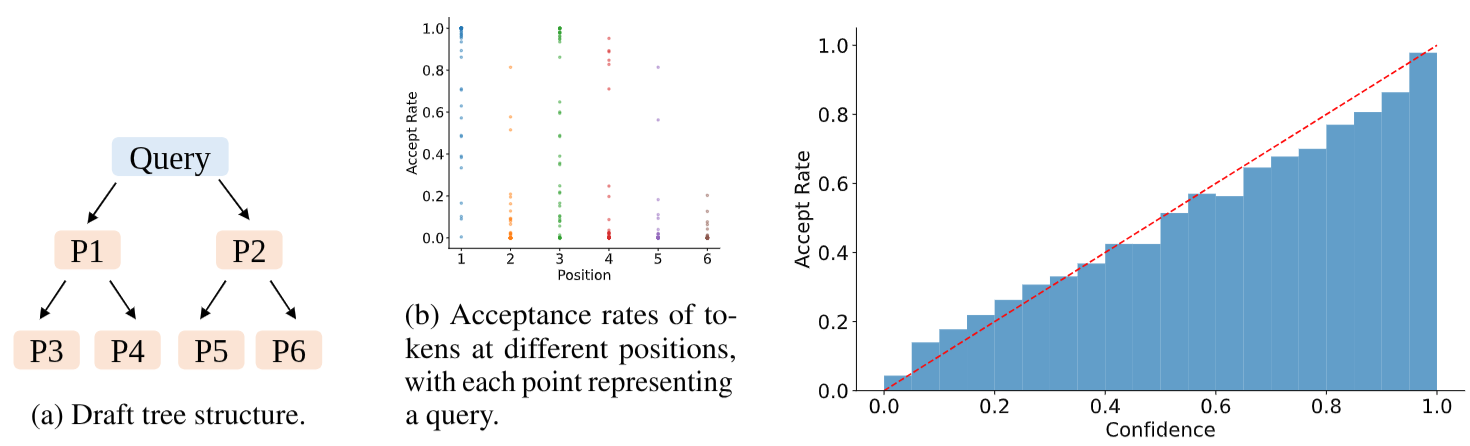
为采用动态草稿树,需要一种低开销的方法,在不调用原始大语言模型的情况下估计草稿 token 的接受率。在 Alpaca 数据集上开展实验,探究草稿模型的置信度分数(即语言模型为各个 token 输出的概率)与接受率之间的关系
- 草稿模型的置信度分数与 token 接受率之间存在较强的正相关关系。置信度分数低于 0.05 的草稿 token ,其接受率约为 0.04;而置信度分数高于 0.95 的草稿 token ,其接受率约为 0.98。可以使用草稿模型的置信度分数估计接受率,而无需引入额外开销,从而实现对草稿树的动态调整
🪐 Context-Aware Dynamic Draft Tree
基于上述观察,作者提出 EAGLE-2,这是一种通过动态调整草稿树来加速大语言模型推理的算法。EAGLE-2 不改变草稿模型的训练与推理方式,也不改变验证阶段。其改进集中在两个方面:如何扩展草稿树,以及如何对草稿 token 进行重排序
- 在扩展阶段,将草稿树最新一层中最有希望被接受的节点输入草稿模型,以构建下一层。在重排序阶段,选择接受概率较高的 token ,构成验证阶段中原始大语言模型的输入
借助树形注意力,草稿模型可以同时接收当前层的全部 token ,并在一次前向传播中计算后续 token 的概率,从而扩展当前层的所有 token 。然而,一次输入过多 token 会减慢草稿模型的前向计算,而且草稿树各层的 token 数量会呈指数增长。因此,需要对草稿树进行选择性扩展
- 从当前层中选择全局接受概率最高的个 token 进行扩展。在投机采样中,拒绝一个草稿 token 会导致其后所有 token 被丢弃;只有当前缀中的所有 token 均被接受时,该 token 才会最终被接受。 token
 的全局接受率,等于从根节点到的路径上所有 token 接受率的乘积。将其定义为节点的价值分数

- 其中,
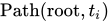 表示草稿树中从根节点到节点的路径,
 表示节点
 的接受率,
 表示草稿模型对给出的置信度分数。置信度分数与接受率之间存在较强的正相关关系。利用这一关系,对节点的价值分数进行近似估计
- 从价值分数较高的 token 开始的分支,更有可能被接受。选择最新一层中价值分数最高的个节点作为草稿模型的输入,并根据其输出扩展草稿树
扩展阶段的目的是增加草稿树的深度。由于接受率的取值范围为 0 到 1,路径上更深位置的 token 具有更低的价值分数。某些未被扩展的浅层节点,其价值分数可能高于已经扩展出的深层节点
- 不直接将扩展阶段选中的 token 作为最终草稿,而是对所有草稿 token 进行重排序,并选择价值分数最高的个 token 。一个节点的价值分数始终小于或等于其父节点的价值分数。对于价值分数相同的节点,优先选择深度较小的节点。这确保重排序后选出的前个 token 仍然构成一棵连通的树
- 随后,将选中的 token 展平为一维序列,作为验证阶段的输入。为确保与标准自回归解码保持一致,还需要调整注意力掩码。在标准自回归解码中,每个 token 都可以看到此前的所有 token ,因此注意力矩阵呈下三角结构。当使用草稿树时,不同分支上的 token 不应彼此可见。因此,必须根据树结构调整注意力掩码,确保每个 token 只能看到其祖先节点
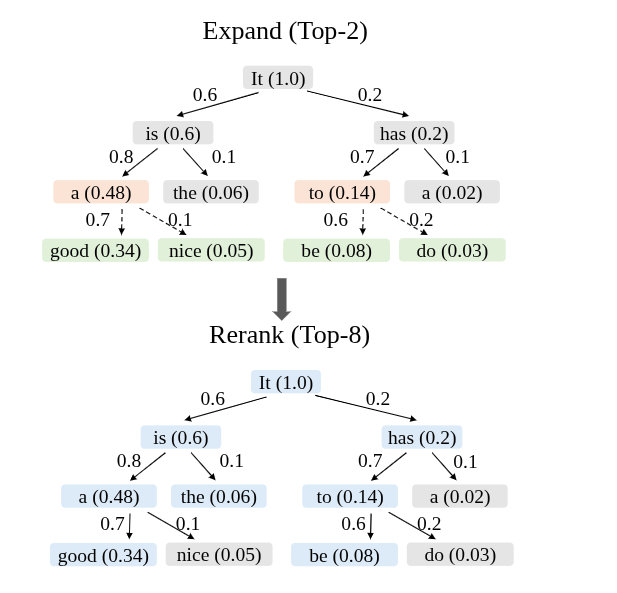
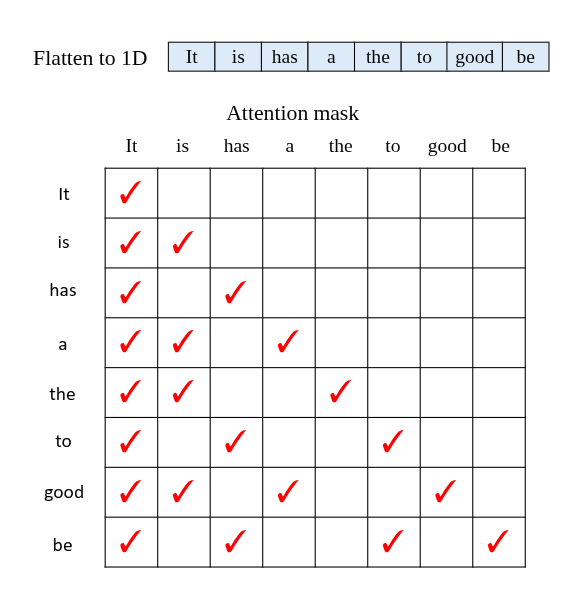
EAGLE-2 逐层选择高分节点继续扩展,再从整棵候选树中重排得到最终待验证草稿
以下使用示意概率,每次扩展从各父节点的分布中取 top-2 候选,每轮选择当前层的两个节点继续扩展,最终保留八个节点(含根节点 I)。c 表示草稿模型的条件概率,V 为路径上各候选概率的乘积,用于近似衡量路径的接受概率;根节点已经确定,令 V(I) = 1。S 记录特征序列,E 记录向后错开一个 token 的嵌入序列,各分支仅使用自身及祖先节点的历史
目标模型:How can → f_can → LMHead
          → softmax → 采样 I
S = [f_How, f_can],E = [e_can, e_I]
草稿计算:配对输入 → Concat → FC
          → DraftDecoder → 末位输出

第 1 轮:生成第一层候选
  配对:[(f_How, e_can), (f_can, e_I)]
  → f_hat_I → LMHead → softmax
    do:   c = 0.60,V = 1 × 0.60 = 0.60
    make: c = 0.20,V = 1 × 0.20 = 0.20
  选择 do、make 继续扩展
  S_do = S_make = S + [f_hat_I]
  E_do = E + [e_do]
  E_make = E + [e_make]

第 2 轮:并行扩展 do、make
  do 新增配对 (f_hat_I, e_do)
  → f_hat_do → LMHead → softmax
    it:   c = 0.80,V = 0.60 × 0.80 = 0.48
    this: c = 0.10,V = 0.60 × 0.10 = 0.06
  make 新增配对 (f_hat_I, e_make)
  → f_hat_make → LMHead → softmax
    a:    c = 0.70,V = 0.20 × 0.70 = 0.14
    some: c = 0.10,V = 0.20 × 0.10 = 0.02

  当前层排序:it(0.48) > a(0.14)
              > this(0.06) > some(0.02)
  选择 it、a 继续扩展
  this、some 留在候选树中,不继续扩展
  S_it = S_do + [f_hat_do]
  E_it = E_do + [e_it]
  S_a = S_make + [f_hat_make]
  E_a = E_make + [e_a]
第 3 轮:并行扩展 it、a
  it 新增配对 (f_hat_do, e_it)
  → f_hat_it → LMHead → softmax
    now:   c = 0.70,V = 0.48 × 0.70 = 0.336
    later: c = 0.10,V = 0.48 × 0.10 = 0.048
  a 新增配对 (f_hat_make, e_a)
  → f_hat_a → LMHead → softmax
    plan: c = 0.60,V = 0.14 × 0.60 = 0.084
    list: c = 0.20,V = 0.14 × 0.20 = 0.028
  本例到此停止扩展

全树重排:比较所有已生成节点的 V
  I(1.00) > do(0.60) > it(0.48) > now(0.336)
  > make(0.20) > a(0.14) > plan(0.084)
  > this(0.06) > later(0.048)
  > list(0.028) > some(0.02)

  保留前八个节点(含根节点 I):
  I、do、it、now、make、a、plan、this
  this 未继续扩展,但分数高于 later、list
  因此仍进入最终待验证草稿

目标模型验证:按树结构展平
  [I, do, make, it, this, a, now, plan]
  相对位置:[0, 1, 1, 2, 2, 2, 3, 3]
  tree attention 限制各节点仅关注自身与祖先
  所有节点均可关注已验证前缀 How can
  一次前向计算以下分支的目标模型分布:
    How can I do it now
    How can I do this
    How can I make a plan

  随后按投机采样规则接受或纠正候选
  展平顺序仅用于计算,不作为一句话直接输出
🌿 EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
投机采样方法通过对生成过程进行部分并行化,能够降低大语言模型的推理延迟。这类方法首先快速生成草稿 token ,然后对其进行并行验证,从而能够在一次前向传播中生成多个 token ,显著降低推理延迟
- 作为一种先进的投机采样方法,EAGLE 利用目标模型的顶层特征,即语言模型输出头之前的表示,执行下一特征预测,以实现大语言模型解码
- EAGLE 在训练草稿模型时,将此前的全部特征
 输入草稿模型,以预测下一特征
 ,并以训练数据中的特征
 作为标签
- 在测试阶段,EAGLE 以自回归方式预测下一特征
 ,再利用目标模型的语言模型输出头得到草稿 token
 。通过利用目标模型中的丰富信息,EAGLE 相较于标准投机采样实现显著更好的加速效果
近年来,大语言模型越来越依赖更大规模的训练数据集来提升性能。类似地,作者希望通过增加训练数据,提高 EAGLE 的接受率和加速比
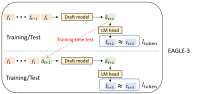
- 然而,观察到,增加训练数据为 EAGLE 带来的收益十分有限。在测试阶段,EAGLE 在特征层面进行自回归预测:首先预测下一特征,再将该特征输入目标模型的语言模型输出头,以获得 token 分布
- 在训练阶段,EAGLE 的损失函数由两部分组成:特征预测损失
 和 token 预测损失
 。借助特征预测损失,训练后的草稿模型能够适应测试阶段的情形,并获得多步预测能力
- 然而,如果以 token 预测为最终目标,特征预测便可以视为一项额外约束。这一约束限制草稿模型的表达能力,使其难以从训练数据规模的增加中获益。移除特征约束并扩大训练数据规模后,第一个草稿 token 的接受率
 显著提高
- 训练阶段草稿模型的输出记为
 ,它与真实特征相差较大,导致测试阶段的输入序列
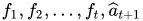 显著偏离训练分布,使第二个草稿 token 的接受率
 非常低。为解决这一问题,可以在训练过程中,将输出重新送入草稿模型的输入端,以模拟自回归推理过程。采用这一方法后,增加训练数据所带来的收益更加显著。将这项技术称为训练时测试(training-time test)
EAGLE 以及 Medusa 等投机采样方法会复用目标模型的顶层特征,具体而言,就是紧邻语言模型输出头之前的特征。对于权重矩阵满秩的语言模型输出头,与下一个 token 的 logits 相对应的顶层特征是唯一的,因此,这些特征所包含的信息与下一个 token 的 logits 直接对应
- 然而,顶层特征在本质上局限于下一个 token ,仅依赖这些特征来预测再下一个 token ,面临着显著挑战。由于训练过程中已经移除特征预测损失 ,训练时测试使草稿模型能够使用中间层特征,而不再仅依赖顶层特征
本文提出 EAGLE 的增强版本 EAGLE-3,实现显著的推理加速,主要贡献如下
- EAGLE-3 通过训练时测试学习多步草稿生成。移除特征预测约束,转而直接预测 token ,并在训练过程中模拟多步生成。直接进行 token 预测,使草稿模型的输入设计具有充分的灵活性。不再仅复用顶层特征,而是整合并利用目标模型的低层、中层和高层特征,从不同层级中获取丰富的语义信息
- 新架构使推理加速受益于草稿训练数据的扩展。采用新架构后,增加草稿模型的训练数据量,会使 EAGLE-3 的加速比获得成比例的提升。这种随数据规模扩展而提升的现象,在原始 EAGLE 架构中并未被观察到
🍄 Preliminaries
投机采样是一种无损的大语言模型加速技术,通过交替执行草稿生成与验证两个阶段实现加速。其中,草稿生成以较低的开销完成,而验证过程则并行执行。用表示第个 token ,用 表示 token 序列
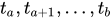 。以为前缀时,投机采样的两个阶段如下
- 在草稿生成阶段,投机采样利用草稿模型,即与目标模型属于同一系列的较小规模模型,以自回归方式生成个 token ,构成草稿
 ,同时记录各 token 对应的概率

- 在验证阶段,投机采样调用目标模型对草稿进行评估,并记录其对应的概率
 。随后,按照从前到后的顺序,依次决定是否接受各个草稿 token 。对于 token
 ,其接受概率为
- 如果该 token 被接受,则继续处理下一个 token ;否则,从以下分布中采样一个 token 以替换,并丢弃草稿中剩余的 token
容量有限的草稿模型难以精确近似大规模目标模型。EAGLE 利用目标模型的顶层特征作为额外信息,并在特征层面执行自回归预测,从而简化草稿生成过程
- EAGLE 在特征层面进行自回归预测,随后使用目标模型的语言模型输出头获得草稿 token 。由于 token 层面的采样结果对特征级自回归过程不可见,这一过程会引入不确定性。EAGLE 通过将上一时间步的 token 序列,即采样结果,输入草稿模型来解决这一问题
- 与标准投机采样的链式草稿不同,EAGLE 在同一位置生成多个草稿 token ,从而形成树形草稿。在验证阶段,EAGLE 使用树形注意力并行验证草稿树
EAGLE、Medusa 等方法采用树形草稿,其草稿树结构是预先定义的、静态的,并且与上下文无关。然而,草稿生成的难度与上下文密切相关,因此,静态草稿树可能导致资源浪费。EAGLE-2 利用草稿模型的置信度近似估计接受率,并据此动态生成草稿树,在草稿生成阶段结束时对其进行剪枝。EAGLE-3 同样采用 EAGLE-2 提出的上下文感知动态草稿树
🪐 EAGLE-3
EAGLE-3 融合目标模型的多层特征,并结合已采样 token 的嵌入递归生成草稿
- 以前缀
How can为例,目标模型在预填充或上一轮验证中采样得到I,同时提供低层、中层和高层特征、 、 。将三个 维向量拼接后,经全连接层从 维投影到 维,得到融合特征 ,其中 为目标模型的隐藏维度 - 为生成以
How can I为前缀的草稿,除复用和 外,还引入已采样 token I的嵌入,使草稿模型获知采样结果。拼接后的向量经全连接层降至 维,再输入单层解码器,得到输出 ;随后通过目标模型的 LM head 采样得到 do I尚未作为输入经过目标模型,因此没有对应的。草稿模型以自身输出 替代该特征,并与 do的嵌入拼接,继续生成 和下一个草稿 token it。下一步再输入与 ,依此递推

训练时测试(TTT)在训练中将草稿解码器输出的隐状态
- EAGLE 同时优化特征预测损失
与 token 预测损失 。特征回归使草稿输出接近目标模型的顶层特征,为多步自回归提供较一致的输入表示;但草稿模型必须同时满足特征拟合与 token 预测两个目标,额外的特征约束限制其表达能力,以及从更大规模训练数据中获得的收益 - EAGLE-3 移除
,仅保留 token 预测目标,草稿单层解码器在 LM head 之前的输出隐状态 不再需要逼近目标模型的顶层特征。论文实验表明,仅移除约束并增加训练数据,能够提高第一个草稿 token 的接受率,但第二个 token 的接受率仍然很低:训练时输入真实特征,推理时却将自身输出作为后续输入,二者的表示分布可能显著不同 - 训练时将草稿解码器生成的隐状态
重新送入输入端,与目标模型的融合特征 共同构成后续预测的上下文。各轮使用训练数据相应位置的 token 作为监督信号,通过 token 预测损失学习后续预测,而无需恢复顶层特征回归约束 - 移除特征约束提高表示的自由度,TTT 则缓解输出反馈引起的训练与推理分布偏移。结合多层特征融合,论文在所评估的数据规模范围内观察到:扩大草稿模型的训练数据量,可以进一步提升接受长度与推理加速比
目标模型:How can → f_can → LMHead → softmax → 采样 I
初始化:S = [g_How, g_can],E = [e_can, e_I]

第 1 轮
  配对输入 = [(g_How, e_can), (g_can, e_I)]
  末位输出 a_I → LMHead → softmax → 采样 do
  更新 S = [g_How, g_can, a_I],E = [e_can, e_I, e_do]

第 2 轮
  配对输入 = [(g_How, e_can), (g_can, e_I), (a_I, e_do)]
  末位输出 a_do → LMHead → softmax → 采样 it
  更新 S = [g_How, g_can, a_I, a_do],E = [e_can, e_I, e_do, e_it]

第 3 轮
  在历史输入之后新增配对 (a_do, e_it)
  末位输出 a_it → LMHead → softmax → 采样下一个草稿 token
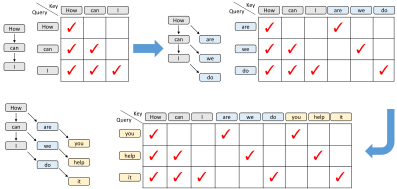
训练时测试调整注意力掩码,使各预测位置仅访问其所属路径的历史上下文
- 以
How can I表示三个输入位置,初始注意力掩码为下三角矩阵。三个位置分别预测are、we和do,对应How → are、How can → we和How can I → do三条上下文路径;这些输出之间没有顺序依赖 - 下一轮将这些预测位置的特征反馈为输入时,对原始训练数据的注意力仍遵循各自的前缀关系;对生成位置的注意力则只保留同一路径上的对应位置,因此各生成轮次之间的掩码块为对角矩阵。这些对角块可以用对应向量的点积计算,避免执行完整的矩阵乘法