FLASH-ATTN
🐩 FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
Transformer 的参数规模不断扩大,网络深度也持续增加。然而,为 Transformer 配备更长的上下文窗口仍然十分困难,其核心原因在于自注意力模块的时间复杂度和内存复杂度均随序列长度呈二次增长。因此,一个重要问题是:能否通过提高注意力计算的速度和内存效率,缓解 Transformer 在处理长序列时所面临的运行时间与内存瓶颈
- 大量近似注意力方法试图降低注意力计算所需的计算量和内存开销。这些方法包括稀疏近似、低秩近似,以及二者的组合。尽管这些方法可以将计算复杂度降低至关于序列长度的线性或近线性级别,但其中许多方法相较于标准注意力并未表现出明显的实际运行时间优势
- 上述方法主要关注浮点运算次数的减少,而 FLOPs 的降低并不必然转化为墙钟时间的缩短。同时,这些方法通常忽略内存访问所产生的 I/O 开销
注意力算法设计中缺失的一项重要原则是 I/O 感知,即需要精确考虑不同速度、不同层级存储器之间的数据读写过程。例如,在 GPU 中,片上 SRAM 的访问速度较快,但容量较小;高带宽显存 HBM 的容量较大,但访问速度相对较慢
- 在现代 GPU 上,计算能力的增长速度已经超过内存带宽的增长速度,因此 Transformer 中的大量操作实际上受限于内存访问,而非纯粹的算术计算
- 对于数据库连接、图像处理、数值线性代数等内存受限任务,I/O 感知算法已经被证明至关重要,因为数据读写可能占据总体运行时间的很大一部分
- PyTorch 和 TensorFlow 等常用深度学习框架所提供的 Python 接口,通常无法对底层内存访问过程进行细粒度控制
FlashAttention 的核心目标,是避免在 HBM 中显式写入和读取完整的注意力矩阵。实现这一目标需要解决两个关键问题
- 在无法一次访问完整输入的情况下完成 Softmax 归约与归一化计算
- 在反向传播过程中避免存储规模巨大的中间注意力矩阵
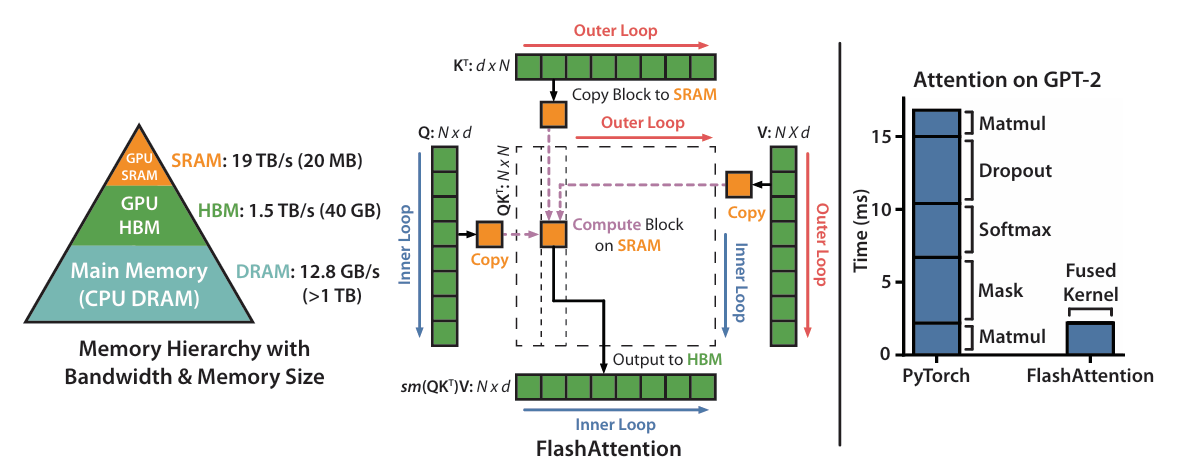
FlashAttention,一种基于分块计算的 I/O 感知型精确注意力算法。该算法通过分块技术,显著减少 GPU 高带宽显存(High Bandwidth Memory,HBM)与片上静态随机存取存储器(SRAM)之间的数据读写次数
- FlashAttention 通过分块计算重组注意力运算。将输入划分为多个数据块,并对这些输入块进行多次遍历,从而以增量方式完成 Softmax 的归约与归一化。这种计算方式通常称为分块计算
- 仅保存前向传播过程中得到的 Softmax 归一化因子:在反向传播阶段,算法利用这些归一化因子,在 GPU 片上重新计算注意力结果。与从 HBM 中读取完整的中间注意力矩阵相比,这种片上重计算方式具有更高的运行效率
- 使用 CUDA 实现 FlashAttention,以便对内存访问进行细粒度控制,并将注意力计算中的各项操作融合到单个 GPU 内核中。尽管重计算会增加一定数量的浮点运算,但由于大幅减少 HBM 数据访问,FlashAttention 仍然能够同时获得更快的运行速度和更低的内存占用
- 设序列长度为
 ,注意力头维度为
 ,GPU 片上 SRAM 的容量为
 ,则 FlashAttention 所需的 HBM 访问量为
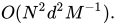 标准注意力算法所需的 HBM 访问量为
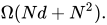
FlashAttention 通过优化 GPU 内存访问,在保持精确注意力计算的同时显著提升 Transformer 的训练效率,并支持更长序列建模
- 在计算效率方面,块稀疏 FlashAttention 将精确注意力扩展为近似的块稀疏形式,其运行速度快于已有近似注意力方法
- 在训练速度方面,FlashAttention 在 BERT-large、GPT-2 和 Long Range Arena 等任务上分别实现 15%、3 倍和 2.4 倍的训练加速
- 在模型性能方面,更长的上下文使 GPT-2 的困惑度降低 0.7,并使长文档分类性能提升 6.4 个百分点
- 在长序列建模方面,FlashAttention 支持 16K 序列,并在 Path-X 上达到 61.4% 的准确率;块稀疏 FlashAttention进一步将序列长度扩展至 64K,并在 Path-256 上达到 63.1% 的准确率
🪶 Background
GPU 存储层次结构:GPU 的存储层次结构由多种容量和访问速度不同的存储器组成。通常,容量越小的存储器,其访问速度越快
- 以 NVIDIA A100 GPU 为例,其配备 40–80 GB 的高带宽显存,带宽约为 1.5–2.0 TB/s。同时,A100 包含 108 个流式多处理器,每个 SM 配备 192 KB 的片上 SRAM,其总带宽估计约为 19 TB/s
- 片上 SRAM 的访问速度比 HBM 高一个数量级,但其容量却小多个数量级。随着 GPU 计算能力相对于存储器访问速度不断提升,越来越多的计算操作受到 HBM 访问开销的限制。因此,如何充分利用高速片上 SRAM,已经成为提高 GPU 程序执行效率的关键
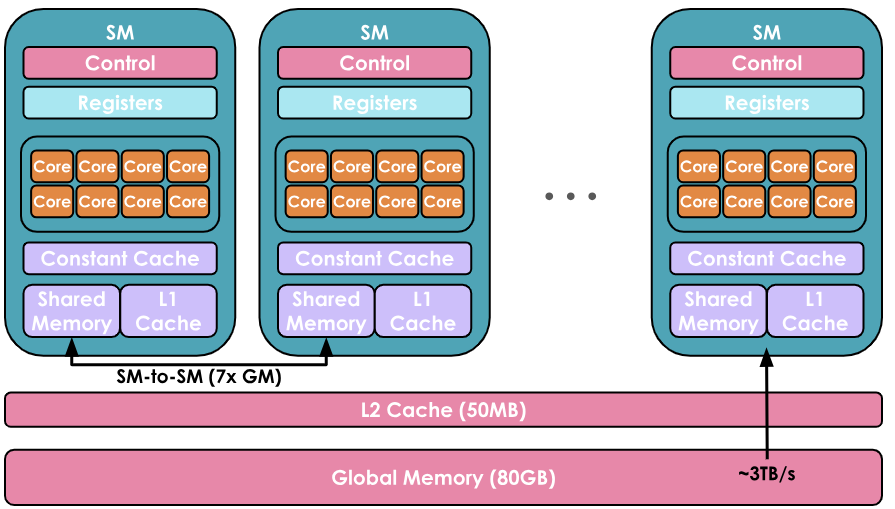
GPU 执行模型:GPU 包含大量并行线程,可用于执行某一计算操作,该操作通常被称为一个计算内核
- 在执行过程中,每个计算内核首先将输入数据从 HBM 加载至寄存器和片上 SRAM,随后完成相应计算,最后再将计算结果写回 HBM。因而,内核执行时间不仅取决于算术运算量,还与 HBM 和片上存储器之间的数据传输量密切相关
- 根据计算量与内存访问量之间的相对关系,GPU 操作通常可以分为计算受限和内存受限两类
- 计算受限(compute-bound):此类操作的运行时间主要由算术运算量决定,而访问 HBM 所消耗的时间相对较少。典型操作包括内维度较大的矩阵乘法,以及通道数较多的卷积运算
- 内存受限(memory-bound):此类操作的运行时间主要由内存访问次数决定,而实际算术计算所消耗的时间相对较少。除大型矩阵乘法和卷积外,许多常见操作都属于内存受限操作,包括逐元素操作,如激活函数和 Dropout,以及归约操作,如求和、Softmax、批归一化和层归一化
内核融合:加速内存受限操作最常用的方法是内核融合。当多个操作作用于同一输入时,可以将这些操作融合到同一个计算内核中,使输入数据只需从 HBM 加载一次,而不必针对每个操作分别加载
- 现代编译器已经能够自动融合许多逐元素操作。然而,在模型训练场景中,反向传播通常需要使用前向传播产生的中间结果。因此,这些中间值仍然需要被写入 HBM 并保存,从而限制简单内核融合方法所能取得的性能收益
标准注意力通过查询与键的相似度,对值向量进行加权聚合。给定输入序列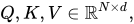 其中表示序列长度,表示单个注意力头的维度。注意力机制需要计算输出
 标准注意力的计算过程为
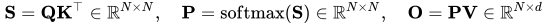
- 其中,Softmax 沿矩阵
 的每一行进行计算。标准注意力实现会在 HBM 中显式生成并存储中间矩阵和
 ,因此需要
 的额外内存空间。在实际 Transformer 模型中,序列长度通常远大于注意力头维度
 。这意味着中间注意力矩阵和
 的规模远大于输入矩阵
- 由于注意力计算中的部分或大部分操作属于内存受限操作,例如 Softmax,因此大量的 HBM 数据读写会直接导致实际墙钟运行时间增加。当注意力矩阵上还需要执行其他逐元素操作时,这一问题会进一步加剧。例如,需要对应用注意力掩码,或者对执行 Dropout。每增加一个独立操作,都可能需要重新从 HBM 中读取注意力矩阵,并将结果再次写回 HBM
🐓 Tiling and Recomputation
核心思想是将输入矩阵 、
 和
 划分为若干数据块,并将这些数据块从访问速度较慢的 HBM 加载至高速片上 SRAM。随后,在 SRAM 中逐块计算对应的注意力结果。通过在累加不同数据块的输出之前,使用正确的归一化因子对各块结果进行缩放,最终可以获得与标准注意力完全一致的精确输出
FlashAttention 以数据块为单位执行注意力计算。由于 Softmax 的归一化过程会同时关联 的所有列,因此不能简单地对各数据块独立计算 Softmax 后直接拼接。为解决这一问题,采用带缩放的分块 Softmax 分解方法
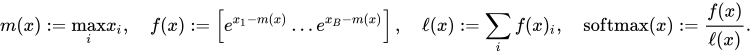
- 对于拼接向量
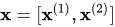 ,可通过维护统计量
 增量计算
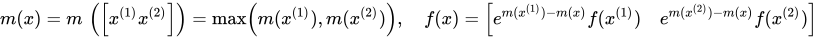
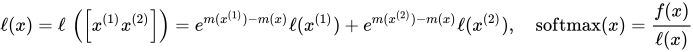
- 只要在逐块计算过程中额外维护两个统计量
 就可以在不同时访问完整输入向量的情况下,逐块计算全局精确的 Softmax
- 基于这一性质,FlashAttention 首先将
 、和划分为多个数据块,对每个块计算局部 Softmax 结果及其附加统计量,随后利用更新后的最大值和归一化因子,对已有输出与当前块输出进行重新缩放和累加。经过所有数据块后,即可得到与标准注意力完全一致的输出
FlashAttention 的另一个目标,是避免为反向传播保存规模的中间结果
- 在标准注意力实现中,为计算关于、和的梯度,反向传播通常需要使用前向传播中生成的矩阵
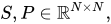 如果在前向传播过程中将和完整保存至 HBM,就会产生随序列长度平方增长的内存开销
- FlashAttention 只保存最终输出
 以及 Softmax 的归一化统计量
 在反向传播过程中,算法再次将、和的数据块加载至 SRAM,并利用这些输入数据和已保存的统计量,在片上重新计算相应的数据块。因此,反向传播所需的注意力矩阵可以按块即时重建,无须将完整的
 中间矩阵存储在 HBM 中
- 可以视为一种选择性梯度检查点。传统梯度检查点方法通过在反向传播中重新执行部分前向计算来降低峰值内存占用,但通常需要以更长的运行时间作为代价。与传统方法不同,FlashAttention 的重计算虽然增加浮点运算次数,却减少大量昂贵的 HBM 数据访问。因此,其反向传播过程不仅更加节省内存,在实际运行中反而更加快速
🦫 FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
FlashAttention 利用 GPU 非对称的存储层次结构,在不引入任何近似的情况下,显著降低内存开销。将其由二次复杂度降至线性复杂度——并相较于经过优化的基线实现获得 2–4 倍的运行速度提升
- 与经过高度优化的矩阵乘法(GEMM)操作相比,FlashAttention 的运行效率仍存在明显差距,其实际吞吐率仅达到理论峰值 FLOPs/s 的 25%–40%
- FlashAttention 在 GPU 不同线程块和线程束之间的任务划分仍然不够合理,从而导致 GPU 占用率不足,或者产生不必要的共享内存读写操作
提出 FlashAttention-2,通过改进任务划分方式进一步提升计算效率
- 第一,调整算法以减少非矩阵乘法浮点运算的数量
- 第二,即使对于单个注意力头,也将注意力计算并行分配至不同线程块,以提高 GPU 占用率
- 第三,在线程块内部重新划分不同线程束之间的任务,以减少通过共享内存进行的通信
🕊️ Background
GPU 性能特征:GPU 由计算单元(例如浮点运算单元)和存储层次结构组成。大多数现代 GPU 都包含用于加速低精度矩阵乘法的专用计算单元,例如 NVIDIA GPU 中用于 FP16/BF16 矩阵乘法的 Tensor Core
- GPU 的存储层次结构主要包括高带宽显存 HBM 和片上 SRAM,即共享内存。以 A100 GPU 为例,其配备 40–80 GB 的 HBM,带宽为 1.5–2.0 TB/s;同时,A100 包含 108 个流式多处理器,每个 SM 配备 192 KB 的片上 SRAM,其总带宽估计约为 19 TB/s
执行模型:GPU 包含大量线程,用于并行执行某项操作,该操作通常称为一个计算内核。线程被组织为多个线程块(thread block),线程块由 GPU 调度至不同的流式多处理器上执行
- 在线程块内部,线程进一步被划分为线程束(warp),每个线程束包含 32 个线程。同一线程束内的线程可以通过高效的 shuffle 指令交换数据,也可以协同执行矩阵乘法。位于同一线程块中的不同线程束,则可以通过读写共享内存进行通信
- 每个计算内核首先将输入数据从 HBM 加载至寄存器和 SRAM,随后执行计算,最后将输出结果写回 HBM
标准注意力实现:给定输入序列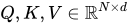 ,其中
 表示序列长度,表示注意力头维度,希望计算注意力输出

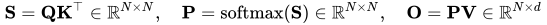
- 其中 Softmax 按行计算。对于多头注意力,上述计算会在多个注意力头之间并行执行,同时也会沿批次维度并行
注意力机制的反向传播过程:设 表示某一损失函数关于输出的梯度。根据链式法则,即反向传播

标准注意力的实现过程:首先调用矩阵乘法(GEMM)子程序计算 ,并将结果写入 HBM;随后从 HBM 中加载 S,计算
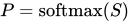 ,并将结果 P 写回 HBM;最后,再次调用 GEMM 计算

- 其中大多数操作受内存带宽限制,大量内存访问会导致较长的实际运行时间。由于必须显式生成并存储 S 和 P,标准注意力的内存复杂度为。同时,为在反向传播过程中计算梯度,还必须保存
 ,从而进一步增加训练阶段的显存开销
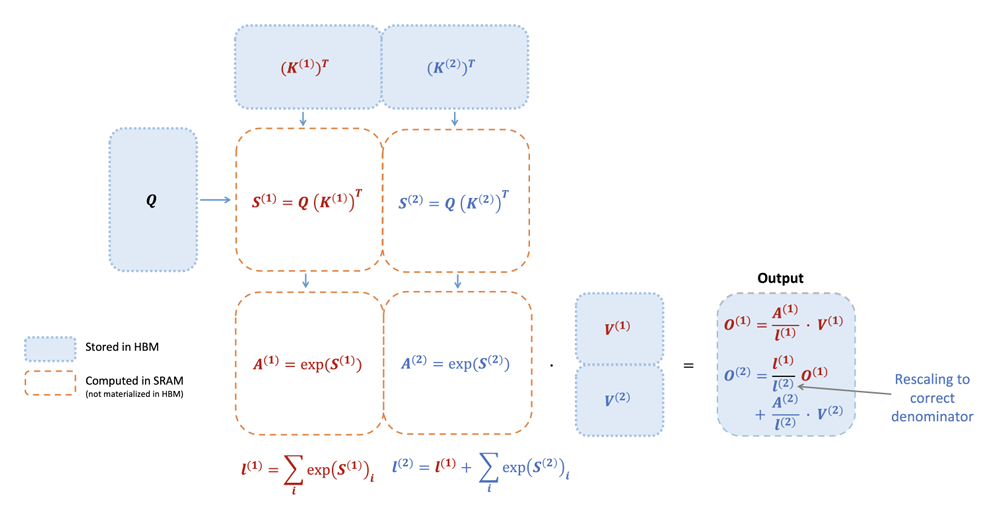
FlashAttention 采用经典的分块计算(tiling)技术减少内存 I/O。首先将输入数据块从 HBM 加载至 SRAM,随后基于当前数据块计算注意力,并直接更新输出,而无须将大型中间矩阵 S 和 P 写入 HBM
- 由于 Softmax 的归一化过程会关联整行或整个行块,online softmax 可以将注意力计算划分为多个数据块,并在处理不同数据块时对输出进行重新缩放,最终得到完全正确的结果,而不引入任何近似
- 标准 Softmax 的计算过程
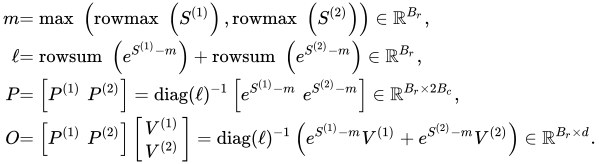
- 在线 Softmax 则分别针对每个数据块计算局部 Softmax,并通过重新缩放得到最终的精确输出

🫎 FlashAttention-2
对 FlashAttention 的算法进行调整,以减少非矩阵乘法浮点运算的数量。这是因为现代 GPU 配备专门的计算单元,例如 NVIDIA GPU 上的 Tensor Core,可以显著加速矩阵乘法。重新审视上述在线 Softmax 技术,并对其进行两项小幅调整,以减少非矩阵乘法 FLOPs
- 在更新输出时,无须使用
 分别缩放两个输出项。原始更新过程表示为

- 作为替代,可以维护
 的一个未缩放版本,并同时保留统计量


- 仅在循环全部结束后,才使用
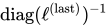 对最终的
 进行缩放,从而得到正确的输出
- 在反向传播过程中,无须同时保存最大值
 和指数和
 ,只需保存二者对应的 LogSumExp 统计量
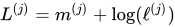
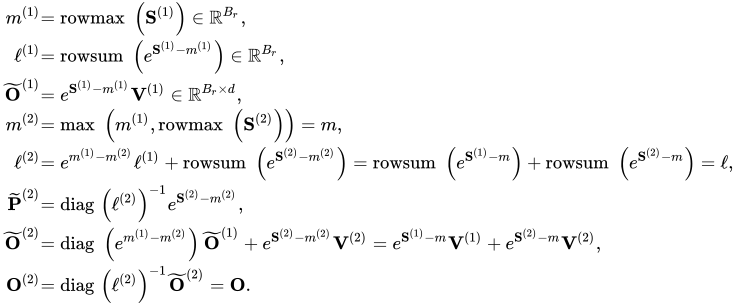
因果掩码:注意力机制的一种常见应用是自回归语言建模。需要对注意力矩阵 S 施加因果掩码,即将所有满足 的元素
 设置为

- 由于 FlashAttention 和 FlashAttention-2 均采用分块计算,对于块内所有列索引都大于行索引的注意力块,可以直接跳过整个块的计算。当序列长度较大时,这类块约占全部注意力块的一半。因此,与不使用因果掩码的注意力计算相比,该方法可实现约 1.7–1.8 倍的加速
- 对于行索引均严格大于列索引的注意力块,无须在块内部施加因果掩码。因此,在采用方形数据块的情况下,每个行块仅需对一个位于主对角线上的数据块执行因果掩码操作
与 FlashAttention 相同,在不引入任何近似的情况下,能够返回正确的注意力输出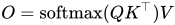 。该算法需要
 次浮点运算;除输入和输出外,仅需
 的额外内存,用于保存 LogSumExp 统计量
多查询注意力和分组查询注意力是两种注意力变体。在这两种机制中,多个查询头共享同一个键头和值头,从而减小推理阶段 KV Cache 的存储规模。在实际计算中,无须显式复制键头和值头,而是通过隐式调整注意力头索引完成等价计算。在反向传播阶段,则需要对这些被隐式复制到不同查询头的键和值梯度进行求和,即跨相关注意力头累加 和

🦜 Parallelism
沿序列长度维度并行:FlashAttention 主要沿批量大小和注意力头数量两个维度进行并行。对于每个注意力头,使用一个线程块进行处理,因此线程块总数为 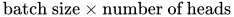 。每个线程块会被调度到一个流式多处理器上运行
- 对于长序列场景,批量大小或注意力头数量通常较小。为更充分地利用 GPU 上的流式多处理器,FlashAttention-2 进一步沿序列长度维度进行并行,从而在此类场景下获得显著加速
在前向传播中,沿序列长度展开的外层循环具有天然的并行性,因此可以将不同迭代调度到彼此独立的线程块上执行,且这些线程块之间无须通信。与此同时,FlashAttention-2 仍然保留原始 FlashAttention 中沿批次维度和注意力头维度的并行方式
- 当批量大小和注意力头数量较小时,沿序列长度维度增加的并行性能够提升 GPU 占用率,即提高实际被利用的 GPU 资源比例,从而在此类场景下带来性能提升
- 将循环顺序调整为外层遍历行块、内层遍历列块,而不是采用原始 FlashAttention 论文中相反的循环顺序,以及沿序列长度维度进行并行,这两项思路最早由 Phil Tillet 在 Triton 实现中提出并实现
反向传播同样沿序列长度维度进行并行,并为每个列块分配一个线程块。不同线程块在更新 时,通过原子加法进行通信
🐳 Work Partitioning Between Warps
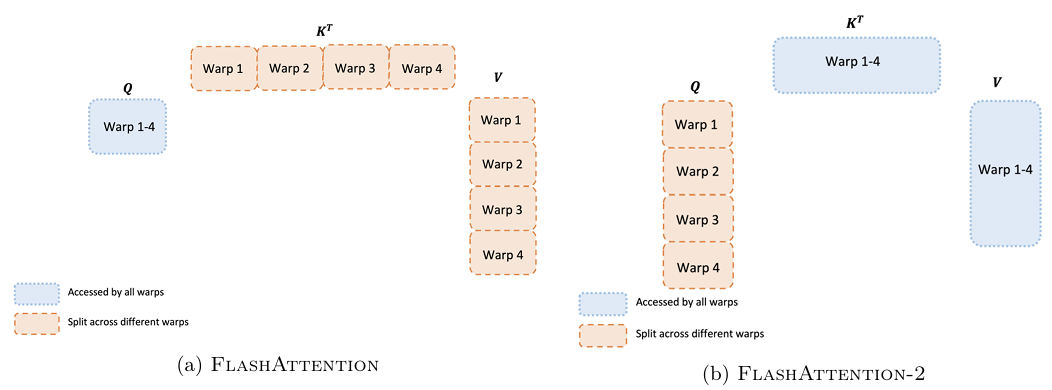
前向传播:对于每个计算块,FlashAttention 将和 划分给 4 个线程束,同时使所有线程束均可访问。每个线程束首先通过矩阵乘法计算
 的一个分片,随后再与的相应分片相乘,并通过通信将各线程束的计算结果累加起来。这种方式称为 split-K 方案
- split-K 方案的效率较低,因为所有线程束都需要将各自的中间结果写入共享内存,完成同步后,再对这些中间结果进行累加。频繁的共享内存读写会降低 FlashAttention 前向传播的执行速度
- 在 FlashAttention-2 中,改为将划分给 4 个线程束,同时使所有线程束均可访问和。每个线程束通过矩阵乘法得到
 的一个分片后,只需将其与所有线程束共享访问的相乘,即可得到对应的输出分片。整个过程中不再需要线程束之间的通信
在反向传播中,同样采用避免 split-K 方案的线程束划分方式。然而,由于输入和梯度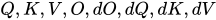 之间具有更加复杂的依赖关系,计算过程中仍然需要执行一定程度的同步操作
数据块大小调优:增大数据块尺寸通常能够减少共享内存的加载和存储次数,但同时也会增加所需的寄存器数量和共享内存总量。当数据块尺寸超过一定范围后,寄存器溢出会导致显著的性能下降;或者,所需共享内存可能超过 GPU 能够提供的容量,使计算内核无法运行
🐶 FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
本文建立在 FlashAttention 系列工作的基础之上,其核心思想是在高层算法设计阶段显式考虑 GPU 的执行模型和硬件特性,从而实现精确 Attention 的高效计算
- FlashAttention 最初提出一种面向 Attention 的新型分块策略,通过将 Attention 中的多个操作融合到单个 GPU Kernel 中,避免中间结果频繁读写低速的全局显存,从而显著降低内存访问开销
- FlashAttention-2 对原始算法进行进一步重构,使其能够沿 Sequence Length 维度进行并行,并在 Forward Pass 的内部循环中依次处理 Key 和 Value 矩阵的数据块,从而提高 GPU 的 Occupancy,并改善计算任务在 GPU 上的分配方式
- 与经过高度优化的矩阵乘法 Kernel 相比,FlashAttention-2 在新一代 GPU 上的硬件利用率仍然较低。例如,在 Hopper H100 GPU 上,FlashAttention-2 的硬件利用率约为 35%,而优化后的 GEMM Kernel 通常可以达到 80%–90%
这一差距部分来源于实现层面的差异。例如,在面向 Tensor Core 编程时,FlashAttention-2 并未充分采用 Hopper 架构特有的指令,而仍然沿用部分面向 Ampere 架构的执行方式。已有工作表明,通过使用 Hopper 专用指令以及基于 Tile 的编程抽象,可以同时提升 Attention 的计算性能并简化 Kernel 实现
- 更为根本的问题在于,FlashAttention-2 的算法设计仍然遵循一种相对简化的同步执行模型,并未在算法层面显式利用异步执行和低精度计算能力
异步执行能力来源于现代 GPU 针对机器学习核心工作负载所进行的硬件专用化。例如,矩阵乘法可以由专门的 Tensor Core 执行,而数据搬运则可以交由 Tensor Memory Accelerator(TMA) 完成;这些硬件单元可以与执行逻辑运算、整数运算和普通浮点运算的 CUDA Core 相互独立地工作
- 低精度计算也是提升 GPU 吞吐率的重要技术路径。从 Pascal 架构中的 FP16、Ampere 架构中的 BF16,到 Hopper 架构中的 FP8,再到 Blackwell 架构中的 FP4,GPU 不断引入更低精度的数据格式。在相同功耗和芯片面积条件下,这些低精度数据格式通常可以获得约两倍甚至四倍的计算吞吐率
- FlashAttention-3 面临的核心技术挑战,是重新设计 FlashAttention-2,使其能够充分利用现代 GPU 的异步执行能力和低精度 Tensor Core。其中,异步执行要求在 Matrix Multiplication 和 Softmax 之间实现计算重叠,尽管 Softmax 本身依赖于 GEMM 的输出;而低精度计算则需要谨慎控制量化误差,特别是在 LLM 激活中存在显著离群特征的情况下
作者提出 FlashAttention-3,通过综合以下三项关键技术进一步提升新一代 GPU 架构上的 Attention 性能
- 生产者-消费者异步执行(Producer-Consumer Asynchrony):设计一种基于 Warp 专门化(Warp Specialization) 的软件流水线机制,通过将数据的生产者与消费者划分至不同的 Warp,充分利用数据搬运与 Tensor Core 计算的异步执行能力,从而进一步增强算法隐藏内存访问延迟和指令发射延迟的能力
- 利用异步分块 GEMM 隐藏 Softmax 开销(Hiding Softmax under Asynchronous Block-wise GEMMs):Softmax 中包含浮点乘加、指数运算等吞吐率相对较低的非 GEMM 操作。将这些操作与用于 GEMM 计算的异步 WGMMA 指令进行重叠执行。重新设计 FlashAttention-2 算法,以规避 Softmax 与 GEMM 之间的部分串行依赖。例如,在两阶段版本的算法中,当 Softmax 正在处理 Score Matrix 的一个 Block 时,WGMMA 可以同时通过异步执行机制计算下一个 Block,从而实现 Softmax 与 GEMM 的流水线重叠
- 硬件加速的低精度 GEMM(Hardware-accelerated Low-precision GEMM):对前向传播算法进行适配,使 GEMM 能够直接利用 FP8 Tensor Core 执行,从而使实测 TFLOPs/s 几乎提升一倍。实现这一目标需要解决 WGMMA 对不同数据布局的约束,即协调 FP32 Accumulator Block 与 FP8 Operand Matrix Block 在内存布局上的不同要求。采用分块量化(Block Quantization)和非相干处理(Incoherent Processing)技术,以减轻由计算精度降低至 FP8 所导致的数值精度损失
🐡 Background: Multi-Head Attention and GPU Characteristics
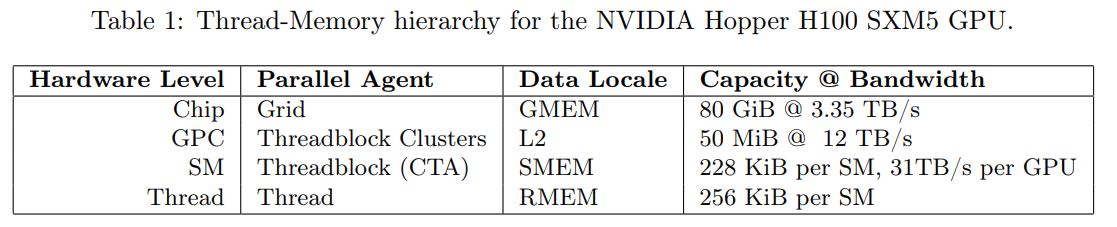
GPU 的存储系统由多个不同层级的数据存储位置构成,其容量通常与带宽呈反向关系,即容量越大的存储层级通常具有越低的访问带宽
- Global Memory(GMEM),通常也称为 HBM,是位于芯片外部的 DRAM,可由所有 Streaming Multiprocessor(SM)访问。从 GMEM 读取的数据会透明地缓存在芯片上的 L2 Cache 中
- 每个 SM 内部都包含容量较小、位于片上的 Shared Memory(SMEM)。SMEM 由程序员显式管理,并采用高度 Banked 的存储结构
- 每个 SM 内部还包含 Register File,用于为各个 Thread 提供私有的高速寄存器存储空间
GPU 的编程模型围绕 Thread 这一最基本的逻辑执行单元进行组织
- 从粒度最细到最粗,其线程层次结构依次为 Thread → Warp → Warpgroup → Threadblock/CTA → Threadblock Cluster → Grid
- Thread:GPU 中最细粒度的逻辑执行单元,每个 Thread 执行相同 Kernel 中的一条执行路径,并拥有自己独立的寄存器状态。Thread 的私有数据通常优先存放在高速的 Register Memory 中
- Warp:NVIDIA GPU 将 32 个 Thread 组织为一个 Warp,并由 Warp Scheduler 统一调度执行。通常情况下,同一个 Warp 内的线程执行相同指令,因此 Warp 是 GPU 实际指令调度和执行的基本粒度之一
- Warpgroup:在 Hopper 架构中,4 个连续 Warp(128 个 Thread)可以进一步组成一个 Warpgroup。Hopper 的 WGMMA 等 Tensor Core 指令以 Warpgroup 为协作粒度,使多个 Warp 能够共同完成一次较大规模的矩阵乘法计算
- Threadblock / CTA(Cooperative Thread Array):一个 CTA 由若干 Warp 组成,并整体调度到同一个 SM 上运行。同一 CTA 内的线程可以通过 Shared Memory 共享数据,并利用同步原语进行协作,因此 CTA 是 CUDA Kernel 中最重要的线程协作单元
- Threadblock Cluster:Hopper 架构进一步引入Threadblock Cluster,将多个 CTA 组织为更高一级的协作单元。同一 Cluster 中的 CTA 会被协同调度到同一个 GPC 内,并能够利用 Hopper 提供的跨 CTA 协作与 Distributed Shared Memory 等机制进行更大范围的数据共享
- Grid:Grid 是一次 Kernel Launch 所创建的全部 Threadblock 的集合,也是 CUDA 编程模型中最高层级的并行结构。Grid 中大量 CTA 会根据 GPU 的可用资源动态分配到不同 SM 上执行,从而实现整个 GPU 范围内的大规模并行
线程层次结构与 GPU 的硬件及存储层次密切相关:Thread 主要使用私有 Register,Warp/Warpgroup 负责细粒度的协同执行,CTA 被调度至单个 SM 并共享 SMEM,Cluster 将多个 CTA 扩展到 GPC 范围,而 Grid 则覆盖整个 GPU
GPU 本质上是一种面向吞吐率的处理器,主要依靠高并发与异步执行来隐藏内存访问延迟和指令执行延迟。对于 GMEM 与 SMEM 之间的异步数据搬运,Hopper 引入专用硬件单元 Tensor Memory Accelerator(TMA)
- 与 Ampere 等上一代架构不同,Hopper Tensor Core 可以通过面向整个 Warpgroup 的 WGMMA 指令进行访问。WGMMA 本身采用异步执行方式,并且能够直接从 Shared Memory 中读取输入数据
GPU 对异步执行的硬件支持进一步催生 Warp-specialized Kernel。在这种 Kernel 中,一个 CTA 内的不同 Warp 被划分为不同角色
- Producer Warp:主要负责数据搬运
- Consumer Warp:主要负责实际计算
- 通过将数据搬运和计算分配至不同 Warp,可以提高编译器生成高效指令调度的能力,并进一步实现不同硬件单元之间的执行重叠
- Hopper 还支持通过
setmaxnreg在不同 Warpgroup 之间动态重新分配寄存器资源。因此,负责执行 MMA 的 Warp 可以获得更大比例的 RMEM,而仅负责发射 TMA 操作的 Warp 则只需要较少的寄存器资源,因为发射 TMA 操作实际上只需要单个 Thread
现代 GPU 配备专用于低精度计算的硬件单元。例如,在 Hopper GPU 上,WGMMA 可以直接使用 FP8 Tensor Core,与 FP16 或 BF16 相比,其单个 SM 的理论计算吞吐率可以提高约 2 倍。要正确使用 WGMMA,需要满足其对 Operand Memory Layout 的特定要求
- 考虑 GEMM 计算
 ,其中
 、
 。如果
 或
 在外部的
 或维度上连续,则称其采用 mn-major 布局;如果数据在内部的维度上连续,则称其采用 k-major 布局
- 对于 FP16 WGMMA,当 Operand 位于 SMEM 中时,mn-major 和 k-major 两种输入布局均受到支持;而对于 FP8 WGMMA,则仅支持 k-major 格式
- Attention 通常需要在同一个 Kernel 中连续执行多个 GEMM,而前一个 GEMM 的 FP32 Accumulator 会直接作为后一个 FP8 GEMM 的 Operand。因此,FP32 Accumulator 与 FP8 Operand 对数据布局的不同要求,会对连续调用具有数据依赖关系的 FP8 WGMMA 构成障碍。因此,在 Attention 场景中,这些 Layout 限制要求对 FP8 Attention 算法进行针对性的重新设计
🐮 Producer-Consumer asynchrony through warp-specialization and pingpong scheduling
FlashAttention-3 的前向传播可以沿 Batch、Attention Head 和 Query Sequence Length 三个维度进行并行。算法从 CTA 粒度进行组织:每个 CTA 负责处理 Query 的一个 Block ,并计算对应的 Block
 。设 Query Block Size 为
 ,则长度为的 Query 被划分为
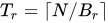 个 Block
- Producer Warpgroup 主要负责数据搬运,利用 TMA 将以及各个
 Block 从 HBM 异步加载至循环式 SMEM Buffer
- Consumer Warpgroup 负责实际计算,利用 WGMMA 执行和
 两个 GEMM,同时完成局部 Softmax 和输出累积
- Hopper 的
setmaxnreg机制用于在 Producer 与 Consumer 之间动态重新分配寄存器,使执行 GEMM 的 Consumer 获得更多寄存器资源 - 由于 TMA Load 本身是异步的,Producer 无需等待前一次数据搬运结束后才能发射下一次 Load。在最初若干次迭代中,Producer 可以持续填充循环 Buffer,从而将 HBM → SMEM 数据搬运与 Tensor Core 计算形成流水化执行
仅实现异步数据搬运仍不足以充分利用 Hopper,因为 Softmax 中的指数、浮点乘加等非 GEMM 操作,其硬件吞吐率远低于 Tensor Core GEMM
- H100 SXM5 的 FP16 Matrix Multiplication 吞吐率约为 989 TFLOPS,而指数等特殊函数的吞吐率仅约为 3.9 TFLOPS
- 对于 Head Dimension 为 128 的 FP16 Attention,虽然矩阵乘法 FLOPs 约为指数运算的 512 倍,但指数运算的吞吐率约低 256 倍,因此其执行开销仍可能达到 GEMM 执行周期的约一半。FP8 下 GEMM 吞吐率进一步提高,而指数运算吞吐率基本不变,因此这一问题更加突出
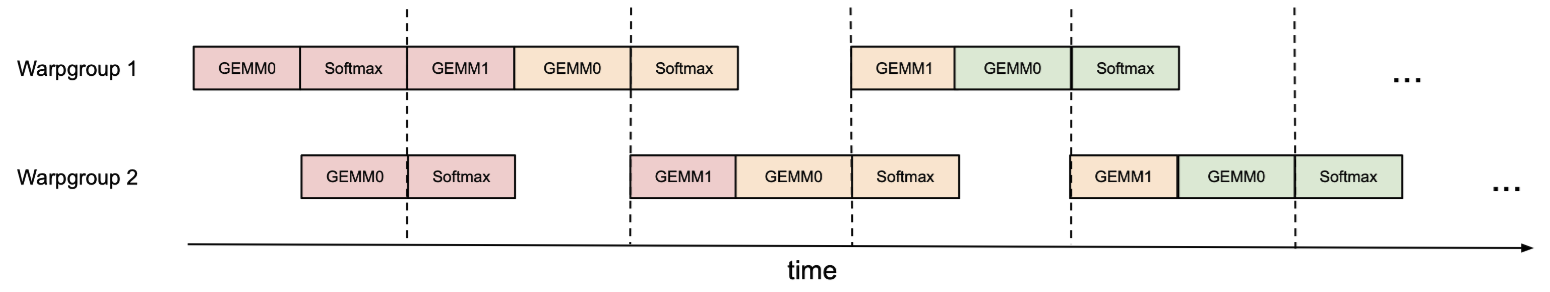
FlashAttention-3 提出 Ping-Pong Scheduling。两个 Consumer Warpgroup 交替执行 GEMM 与 Softmax
- Warpgroup 1 执行 Softmax 时,Warpgroup 2 执行 GEMM;随后二者交换角色
- 这样可以让由独立硬件单元执行的 Softmax 与 Tensor Core 上的 GEMM 并行进行,从而将部分 Softmax 开销隐藏在 GEMM 的执行时间之下。作者通过 Barrier 控制两个 Warpgroup 的调度顺序,使一个 Warpgroup 的 Softmax 尽可能与另一个 Warpgroup 的 GEMM 重叠
🦓 Intra-Warpgroup Overlapping GEMMs and Softmax
通过额外的寄存器缓冲区,构建跨迭代的两阶段流水线,使同一 warpgroup 内的 GEMM 与 softmax 重叠执行
- 具体而言,异步发起第
 块的 GEMM 和第
 块的 GEMM;当第块的完成后,即可计算该块的 softmax,同时让前一块的
 GEMM 继续执行。待前一块的 GEMM 完成后,再对输出进行重缩放,并推进流水线
尽管上述流水线结构在理论上能够带来性能收益,但在实践中仍有几个方面需要考虑
- 编译器指令重排。 伪代码呈现的是理想化的执行顺序,但编译器(NVCC)经常会出于优化目的重新排列指令。这可能扰乱精心设计的 WGMMA 与非 WGMMA 操作之间的流水线执行顺序,进而导致非预期行为或削弱性能收益
- 寄存器压力。 为保持最佳性能,应尽可能减少寄存器溢出。然而,两阶段流水线需要额外的寄存器来存储中间结果,并维护阶段之间的上下文。具体而言,需要在寄存器中额外保留一个
 ,使每个线程块增加
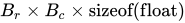 大小的寄存器用量。寄存器需求的增加可能与采用更大分块尺寸这一常见优化手段产生冲突,因为更大的分块同样需要大量寄存器
三阶段流水线。 在上述两阶段算法的基础上,提出一种三阶段变体,以进一步增加第二个 WGMMA 与 softmax 的重叠程度。尽管这种方法有望进一步提高 Tensor Core 的利用率,但新增的流水线阶段需要更多寄存器,使分块尺寸与流水线深度之间的权衡更加困难
🐼 Low-precision with FP8
以 FP8 精度计算 FlashAttention-3 的前向传播时,在满足布局要求方面会遇到 FP16 中不存在的额外挑战。对于的布局变换,有两种方案
- 方案一是在预处理阶段对全局内存(GMEM)中的 进行转置
- 方案二是将 分块加载到共享内存(SMEM)后,在内核中进行转置。方案(1)可以将转置融合到前序操作(如旋转位置编码)的收尾阶段,或调用独立的预处理转置内核,交换序列长度维度与注意力头维度的步长。但前者难以集成到标准库中,后者在推理等受内存带宽限制的场景下开销过大
FP8 FlashAttention-3 采用方案二,利用 LDSM(ldmatrix)和 STSM(stmatrix)指令完成内核内转置。这些指令由一个 warp 内的线程协同执行,以 128 字节为粒度,在 SMEM 与寄存器内存之间搬运数据,并能够在搬运过程中完成布局转置
- 由于寄存器开销较低,它们可以在生产者 warpgroup 中执行。此外,从第一次迭代之后开始,下一个分块的转置可以与涉及前一个分块和当前 分块的两个 WGMMA 重叠执行
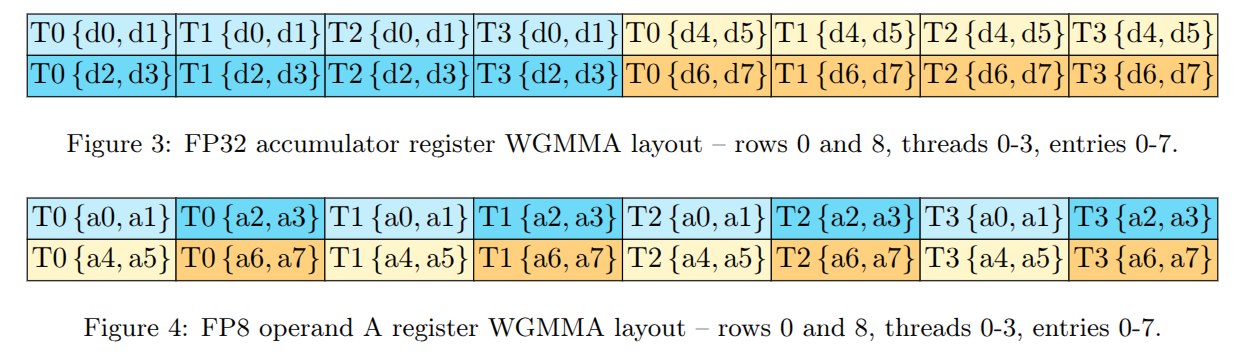
- 与 FP16 不同,FP8 WGMMA 的 FP32 累加器布局与其操作数存放在寄存器中时所要求的布局不一致。因此,需要使用字节置换指令,将第一个 WGMMA 的累加器转换为适合第二个 WGMMA 的格式,同时与内核内转置生成的分块布局相匹配
- 将元素顺序调整为
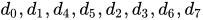 ,并对每个 8 字节组重复这一置换。从逻辑上看,这相当于置换分块的列,例如第 0、1、8、9 列成为前四列。为保证 WGMMA 计算出正确的输出,还需在内核内转置时,对写出的 分块进行相匹配的行置换
FP8(E4M3)格式仅使用 3 位存储尾数、4 位存储指数,因此其数值误差高于 FP16/BF16。此外,大模型通常存在幅值远大于其他大多数数值的离群值,这增加量化的难度。通常采用逐张量缩放,即为每个张量保留一个标量。为降低 FP8 注意力计算的数值误差,采用以下两种技术
- 分块量化。 为每个分块保留一个缩放因子,即将、、分别划分为大小为
 或
 的分块,并独立进行量化。该量化过程可以与紧邻注意力计算之前的操作(如旋转位置编码)融合,而不会带来额外的性能损失,因为旋转位置编码受内存带宽限制。由于 FlashAttention-3 算法本身以分块为单位执行,因此可以在不增加计算开销的情况下,对的各个分块进行缩放,以计入分块量化所引入的缩放因子
- 非相干处理。 为分散离群值,在量化为 FP8 之前,将和分别乘以随机正交矩阵。由于是正交矩阵,满足
 ,因此
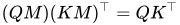 ,即同时将和乘以不会改变注意力输出。由于
 或
 的每个元素都是或中各元素的随机加权和,这一操作能够分散离群值,从而降低量化误差