Infra Optimizers
🌿 MUON IS SCALABLE FOR LLM TRAINING
受缩放定律影响,高性能大语言模型的训练仍然需要消耗大量计算资源。优化器直接决定参数更新方式,因此对提升大语言模型的训练效率和最终性能具有重要作用。目前,Adam 及其变体 AdamW 仍是大多数大规模语言模型训练中的标准选择
- 近期研究表明,一些新型优化方法有望在训练效率方面超越 AdamW
- K. Jordan 等人提出 Muon 优化器。Muon 使用 Newton–Schulz 迭代对梯度动量进行正交化,并以正交化后的动量更新矩阵参数。已有初步实验表明,Muon 在小规模语言模型训练中具有较好的效果
Muon 在大规模训练场景中的应用仍面临若干关键问题
- 尚不清楚基于矩阵正交化的优化器能否扩展到拥有数十亿参数、并在数万亿 token 上训练的大语言模型
- 在分布式训练环境中,如何高效计算近似正交化仍有待解决。最后,Muon 能否适用于预训练、监督微调等不同训练阶段,也缺乏系统性验证
本文针对上述问题,对 Muon 的大规模可扩展性进行全面研究,并系统分析和解决其在大规模训练场景下的主要局限
- 本文分析影响 Muon 规模化应用的关键因素。实验发现,权重衰减对于 Muon 的长期训练稳定性至关重要。同时,本文提出参数级更新尺度调整策略,根据不同矩阵参数的形状修正更新幅度。经过这些调整后,Muon 可以直接复用为 AdamW 调整得到的学习率和权重衰减等超参数,无须额外进行复杂的超参数搜索,并能够显著提升大规模训练的稳定性
- 本文提出一种高效的分布式 Muon 实现。该方法借鉴 ZeRO-1 的优化器状态分片机制,将主权重和动量状态划分到不同数据并行设备上,同时针对 Muon 必须基于完整梯度矩阵执行正交化这一特点,设计相应的梯度收集和局部更新流程。该实现能够在保持 Muon 数学性质的同时,降低优化器状态的内存占用,并将额外通信开销控制在较低水平
- 本文通过缩放定律实验系统比较 Muon 与经过充分调优的 AdamW 基线。实验结果表明,在达到相近模型性能时,Muon 仅需要 AdamW 约 52% 的训练 FLOPs,显示出明显的计算效率优势
综合实验结果表明,经过权重衰减、更新尺度修正和分布式实现优化后,Muon 可以有效应用于大规模语言模型训练,并有潜力替代 AdamW 成为大模型预训练中的标准优化器
🐾 Background
Muon 是一种面向矩阵形式神经网络权重的优化器。在第 次迭代中,给定当前权重
 、动量系数
 、学习率
 以及目标函数
 ,Muon 的更新规则可以表示为
 (1)
- 其中,
 表示第次迭代中的梯度动量;当
 时,被初始化为零矩阵。采用 Newton–Schulz 迭代近似计算

- 设的奇异值分解为
 ,则有

- 该过程实现对的正交化。直观而言,正交化能够使更新矩阵在不同方向上更加均衡,避免模型权重主要沿少数占主导地位的方向进行学习
- 作者采用 Nesterov 风格的动量,即送入 Newton–Schulz 迭代的并非单独的
 ,而是

用于矩阵正交化的 Newton–Schulz 迭代
- 首先,将初始矩阵设置为
 随后,在第
 次迭代中,根据
 更新

 (2)
- 经过 N 次迭代后,
 即为该迭代过程的输出。其中
 、
 和
 为迭代系数。为保证能够正确收敛,需要合理设置这些系数,使多项式
 在接近 1 的位置具有不动点
- 系数被设定为
 、
 和
 ,目的是使较小的初始奇异值能够更快收敛
范数约束下的最速下降:可以将深度学习中的优化过程理解为范数约束下的最速下降。从这一视角来看,Muon 与 Adam 之间的主要差异,可以归结为二者采用不同的范数约束
- Adam 所对应的最速下降方向受到一种由 Max-of-Max 范数动态调整得到的范数约束;相比之下,Muon 提供的约束位于某个较大
 值对应的 Schatten-ppp 范数的固定范围内。当上式中的正交化被精确计算时,Muon 对应的范数约束即为谱范数
- 神经网络权重通常作为作用于输入空间或隐藏空间的线性算子,而这些空间在局部通常可以视为欧氏空间。因此,对权重矩阵施加的范数约束应当采用诱导算子范数;对于矩阵而言,这对应于谱范数
- 论文认为 Muon 所采用的范数约束比 Adam 的范数约束更加符合神经网络权重的算子性质
🌲 Scaling Up Muon
权重衰减:尽管 K. Jordan 的研究表明,Muon 在小规模训练中显著优于 AdamW,但随着模型规模和训练 token 数量的增加,Muon 的性能优势会逐渐减弱
- 模型权重和各层输出的均方根(RMS)会持续增大,并可能超出 BF16 的高精度表示范围,从而损害模型性能。为解决这一问题,将标准的 AdamW 权重衰减机制引入 Muon
 (3)
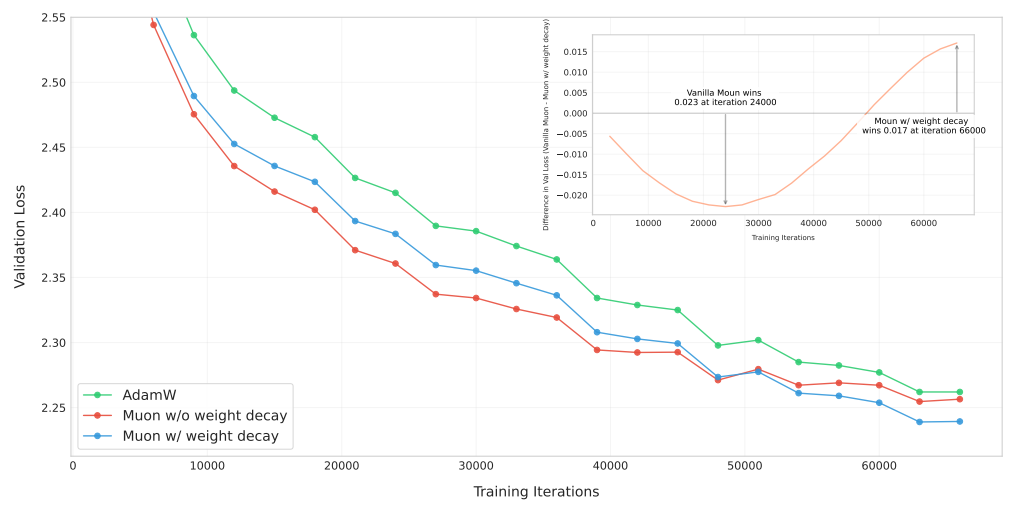
- 尽管原始 Muon 在训练初期收敛更快,但随着训练持续进行,部分模型权重会增长得过大,从而可能限制模型的长期性能。引入权重衰减后,这一问题得到缓解
- 实验结果表明,在超额训练阶段,带权重衰减的 Muon 同时优于原始 Muon 和 AdamW,并取得更低的验证损失
一致的更新 RMS:Adam 和 AdamW 的一个重要性质是,其理论更新 RMS 约为 1。³然而 Muon 的更新 RMS 会随参数矩阵的形状而变化
- 引理 1:对于形状为
 的满秩矩阵参数,其理论 Muon 更新 RMS 为

- 当
 较大时,例如稠密 MLP 中的权重矩阵,更新幅度会过小,从而限制模型的表示能力并导致次优性能
- 当较小时,例如将 GQA 或 MLA 中的每个 KV 头分别视为独立参数时,更新幅度会过大,进而引发训练不稳定并导致次优性能
- 为使不同形状矩阵之间的更新 RMS 保持一致,提出将每个矩阵对应的 Muon 更新乘以
 ,从而抵消引理 1 所描述的形状效应
与 AdamW 的更新 RMS 对齐:Muon 主要用于更新矩阵形式的参数。在实际训练中,Muon 通常需要与 AdamW 配合使用,由 AdamW 负责优化 RMSNorm、语言模型输出头和词嵌入等非矩阵参数
- 为使矩阵参数与非矩阵参数能够共享相同的优化器超参数,希望 Muon 和 AdamW 使用统一的学习率
 与权重衰减系数
 将 Muon 的更新 RMS 调整至与 AdamW 相近的范围
- 根据经验观察,AdamW 的更新 RMS 通常约为 0.2~0.4。因此按照以下方式缩放 Muon 的更新
 (4)
- 将 Newton–Schulz 迭代次数
 从 5 增加至 10,虽然能够获得更加精确的正交化结果,但并不会带来更好的模型性能。出于计算效率的考虑,将设置为 5。沿用 K. Jordan 的设置,将动量系数设为 0.95
⚡ Distributed Muon
Rajbhandari 提出 ZeRO-1 技术,通过在集群中的不同设备之间对开销较大的优化器状态进行分片,例如主权重和动量状态,从而降低单个设备的内存占用
- Megatron-LM 进一步将 ZeRO-1 集成到其原生并行训练框架中。借助 Megatron-LM 中完善的并行策略,包括张量并行、流水线并行、专家并行和数据并行,ZeRO-1 的通信范围可以从整个分布式进程组缩小至数据并行组内部
- ZeRO-1 对 AdamW 十分高效,因为 AdamW 以逐元素方式计算参数更新。然而,Muon 需要完整的梯度矩阵才能计算更新方向。因此,原始 ZeRO-1 不能直接应用于 Muon
本文提出一种基于 ZeRO-1 的新型 Muon 分布式方案,并将其称为 Distributed Muon。Distributed Muon 沿用 ZeRO-1 的设计,在数据并行维度上对优化器状态进行分片。与标准的 ZeRO-1 AdamW 优化器相比,额外引入以下两项操作
- 数据并行收集(DP Gather)。 对于当前设备所负责的本地主权重分片,其大小约为完整模型权重的
 ,该操作负责收集与该参数分片对应的梯度分片,从而重建完整的梯度矩阵
- 计算完整更新。 完成上述梯度收集后,在完整梯度矩阵上执行 Newton–Schulz 迭代。随后,完整更新矩阵中不属于当前设备的部分会被丢弃,因为每个设备只需要保留与其本地参数分片相对应的更新,用于执行本地参数更新
从内存占用、通信开销和训练延迟三个方面,将 Distributed Muon 与基于经典 ZeRO-1 的分布式 AdamW 进行比较
- Muon 只需要维护一个动量缓冲区,而 AdamW 需要维护两个动量缓冲区。因此,Muon 优化器状态所占用的额外内存仅为 Distributed AdamW 的一半
- 对于每个设备,新增的数据并行收集操作只针对当前设备负责的本地数据并行参数分片执行。因此,该操作的通信量小于对完整梯度执行 Reduce-Scatter 的通信量,也小于对完整参数执行 All-Gather 的通信量
- Muon 只需要使用 BF16 精度执行 Newton–Schulz 迭代,因此与 FP32 通信相比,该部分通信开销可进一步降低 50%。Distributed Muon 的通信量约为 Distributed AdamW 的 1 到 1.25 倍
- 与 Distributed AdamW 相比,Distributed Muon 的端到端延迟更高,因为它引入额外通信,并且需要执行 Newton–Schulz 迭代。然而,这一问题并不显著,主要有两个原因。首先,通常只需约 5 次 Newton–Schulz 迭代即可获得较好的优化效果。其次,与模型的前向传播和反向传播时间相比,优化器步骤造成的端到端延迟通常可以忽略