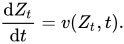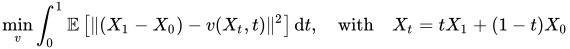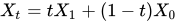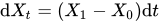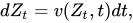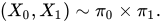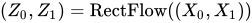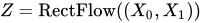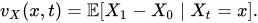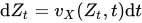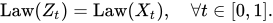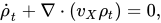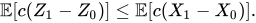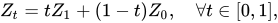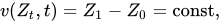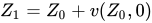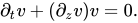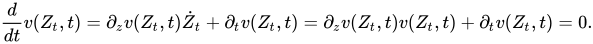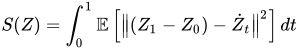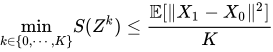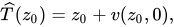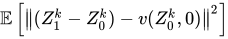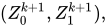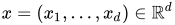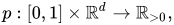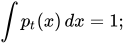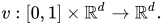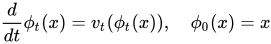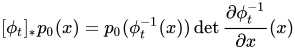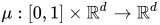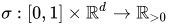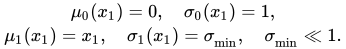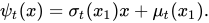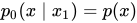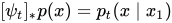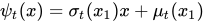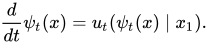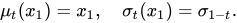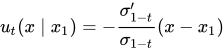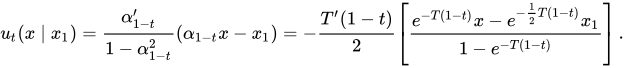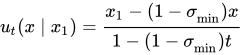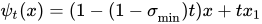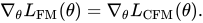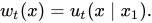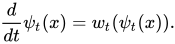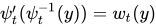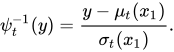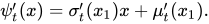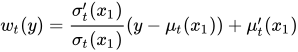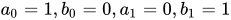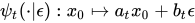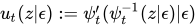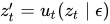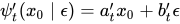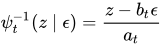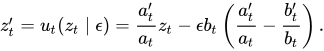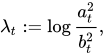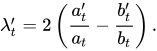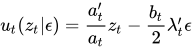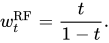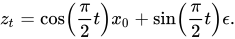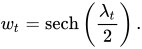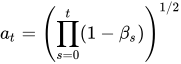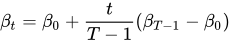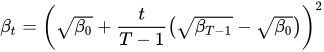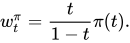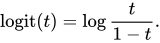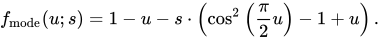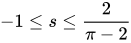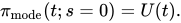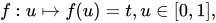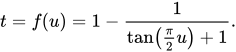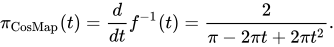Generative Models V

🦥 Rectified Flow

学习两个分布 与 之间的传输映射,可以统一描述生成建模与领域迁移。 这样的映射通常不唯一。最优传输要求进一步最小化指定的传输代价,但高维大规模问题难以精确求解;连续时间模型则通过 ODE 或 SDE 描述样本演化,采样时通常需要多次网络评估

Rectified Flow 用最小二乘回归学习神经 ODE 的速度场,使其逼近两端样本的线性插值方向。 训练可采用标准随机梯度优化,无需对抗训练或显式似然计算。其目标是学习易于快速模拟的流:沿恒定速度运动的直线轨迹可由单步 Euler 更新精确模拟,轨迹越接近这一形式,采用较少采样步数时的离散化误差通常越小

  • 在回归目标被精确求解且 ODE 适定的条件下,Rectified Flow 将初始耦合转化为连接 与 的新确定性耦合,且对任意凸的位移代价,其期望传输代价均不高于原耦合
  • Reflow 使用前一阶段流模型生成的成对样本重新训练 Rectified Flow,迭代使轨迹趋于直线,从而支持以更少的采样步数完成传输

🦨 Rectified Flow

给定来自两个分布的经验观测样本 X_0 \sim \pi_0与X_1 \sim \pi_1,由(X_0, X_1)所诱导的 rectified flow 是定义在时间区间t \in [0,1]上的常微分方程模型\frac{\mathrm{d}Z_t}{\mathrm{d}t}=v(Z_t,t).其目标是将初始分布 \pi_0中的样本 Z_0传输为服从目标分布 \pi_1的样本 Z_1。漂移力场v: \mathbb{R}^d\times[0,1] \to \mathbb{R}^d被设计为尽可能驱动流沿着从 X_0指向 X_1的线性路径方向(X_1-X_0)演化。该目标可通过求解如下简单的最小二乘回归问题实现

\min_v \int_0^1 \mathbb{E} \left[ \|(X_1 - X_0) - v(X_t, t)\|^2 \right] \mathrm{d}t, \quad \text{with} \quad X_t = tX_1 + (1 - t)X_0(1)

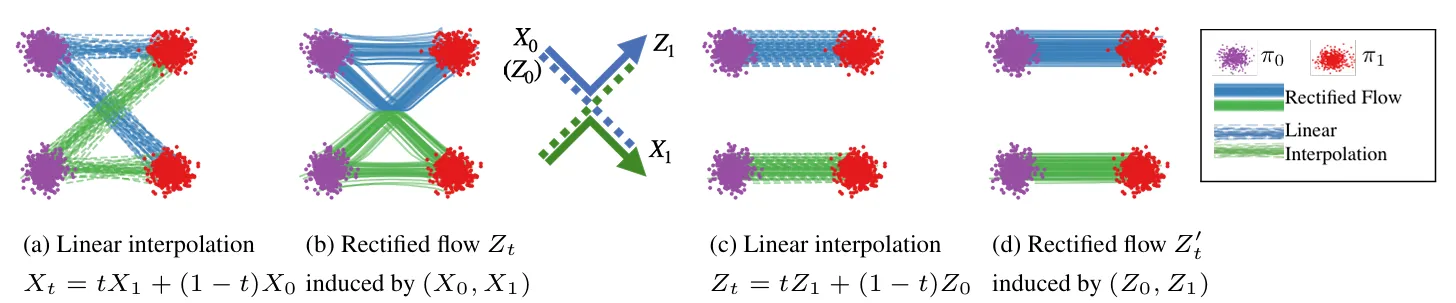
  • X_t表示X_0与 X_1之间的线性插值。期望\mathbb{E}[\cdot]是关于随机变量 (X_0,X_1)的,将X_t=tX_1+(1-t)X_0视为由 (X_0,X_1)决定的函数。线性插值过程 X_t满足一个朴素的 ODE

\mathrm{d}X_t = (X_1 - X_0) \mathrm{d}t(2)

  • 然而该 ODE 并不适合直接用于构造传输映射,因为它是非因果的,或者说具有预知性:对X_t的更新依赖于终点 X_1的信息。Rectified flow 通过拟合漂移场 v来近似 (X_1-X_0),从而将线性插值路径因果化,得到一个无需预先知道未来终点即可模拟的 ODE 流
  • 在实践中,v通常由神经网络或其他非线性模型参数化,并使用(X_0,X_1)的经验样本,通过随机梯度下降等通用随机优化方法求解上述目标。获得v后,可以从Z_0 \sim \pi_0出发正向求解 ODE,以实现从\pi_0到 \pi_1的传输;也可以从Z_1 \sim \pi_1出发反向求解,以实现从 \pi_1到\pi_0的传输

流避免交叉:对于一个适定的常微分方程dZ_t=v(Z_t,t)dt,若其解存在且唯一,则不同轨迹在任意时间t \in [0,1)上都不能相互交叉

  • 具体而言,不存在某个位置z \in \mathbb{R}^d和时间t \in [0,1),使得两条轨迹在该时刻以不同方向经过同一点 z。否则,该 ODE 在该点的解将不再唯一
  • 可以将线性插值 X_t理解为在\pi_0与 \pi_1之间构建道路或通道,而 rectified flow 则对应于粒子在这些道路上的运动方式。该运动是局部的、无记忆的且非交叉的:它忽略X_0与 X_1如何在全局上配对的路径信息,并重新构造出一个更具确定性的(Z_0,Z_1)配对关系

Rectified Flow 降低传输代价:若上述最小二乘问题能够被精确求解,则由 rectified flow 得到的样本对(Z_0,Z_1)被保证是\pi_0与\pi_1的一个有效耦合,即当Z_0 \sim \pi_0 时,有Z_1 \sim \pi_1。此外,相较于原始数据对(X_0,X_1),该耦合(Z_0,Z_1)对所有凸代价函数均能保证不产生更大的传输代价

  • 原始数据对 (X_0,X_1)可以是\pi_0与 \pi_1之间的任意耦合。在实际问题中,由于通常缺乏有意义的成对观测,它们往往被视为相互独立,即(X_0,X_1)\sim \pi_0 \times \pi_1.经过 rectified flow 得到的耦合(Z_0,Z_1)具有确定性依赖关系,因为它由一个 ODE 模型构造得到。
  • 记(Z_0,Z_1)=\mathrm{RectFlow}((X_0,X_1))表示从(X_0,X_1)到(Z_0,Z_1)的整流映射。因此\mathrm{RectFlow}(\cdot)可以将任意耦合转化为一个具有不增凸传输代价的确定性耦合

直线流实现快速模拟:记Z=\mathrm{RectFlow}((X_0,X_1))为由(X_0,X_1)诱导得到的 rectified flow。按照算法 1 递归地应用该算子,可以得到一系列 rectified flows

\boldsymbol{Z}^{k+1} = \mathrm{RectFlow}((Z_0^k, Z_1^k)), \text{ with } (Z_0^0, Z_1^0) = (X_0, X_1)(3)

  • 该 reflow 过程不仅能够降低传输代价,还具有一个重要作用,即逐步拉直 rectified flow 的轨迹,使流路径更加接近直线
Algorithm 1 Rectified Flow: Main Algorithm

Reflow (optional): , starting from , where is drawn from and

Distill (optional): Learn a neural network to distill the -rectified flow, such that

🦫 Main Properties

对于给定的输入耦合 (X_0,X_1),最小值在如下情形下取得:v_X(x,t)=\mathbb{E}[X_1-X_0 \mid X_t=x].即v_X(x,t)表示在时刻 t经过位置 x的线性路径方向X_1-X_0的条件期望。下面讨论由\mathrm{d}Z_t = v_X(Z_t, t) \mathrm{d}t定义的 rectified flow 的性质,其中Z_0\sim \pi_0,并假设该 ODE 存在唯一解

{v^X(x, t) = \mathbb{E}[X_1 - X_0 \mid X_t = x]}(4)

边缘分布保持性质:样本对(Z_0,Z_1)构成 \pi_0与 \pi_1的一个耦合。并且对任意时间,Z_t的边缘分布与 X_t的边缘分布相同,即

\mathrm{Law}(Z_t)=\mathrm{Law}(X_t), \quad \forall t\in[0,1].(5)

在X_t与Z_t的动力学下,任意位置与任意时刻穿过每个无穷小体积元的期望质量流入量和流出量是相同的。因此,二者刻画出相同的边缘分布演化
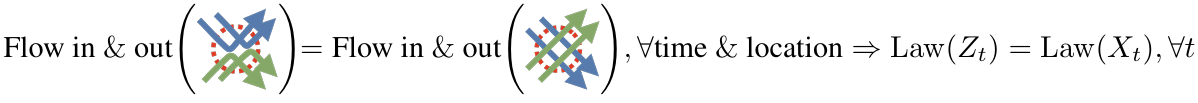
  • 从数学上看,通过证明 X_t与Z_t的边缘分布均满足相同的连续性方程得到:\dot{\rho}_t+\nabla\cdot(v_X\rho_t)=0,因此二者具有相同的边缘分布
  • Z_t 的整条轨迹的联合分布通常不同于 X_t的轨迹联合分布。特别地,X_t一般是一个非因果、非 Markov 过程,其中(X_0,X_1)是随机耦合;而 Z_t则在保持所有时刻边缘分布不变的同时,对 X_t进行因果化、Markov 化和去随机化

降低传输代价:由 rectified flow 得到的耦合(Z_0,Z_1)在任意凸传输代价意义下都不大于输入耦合 (X_0,X_1),即对于任意凸函数c:\mathbb{R}^d\to \mathbb{R},均有\mathbb{E}[c(Z_1-Z_0)] \leq \mathbb{E}[c(X_1-X_0)].

  • \mathrm{RectFlow}(\cdot)在所有凸传输代价构成的集合上实现一种 Pareto 下降,而不需要针对某个特定的代价函数进行优化。这一点使其区别于典型的最优传输优化方法;后者通常被明确表述为针对给定代价函数的优化问题

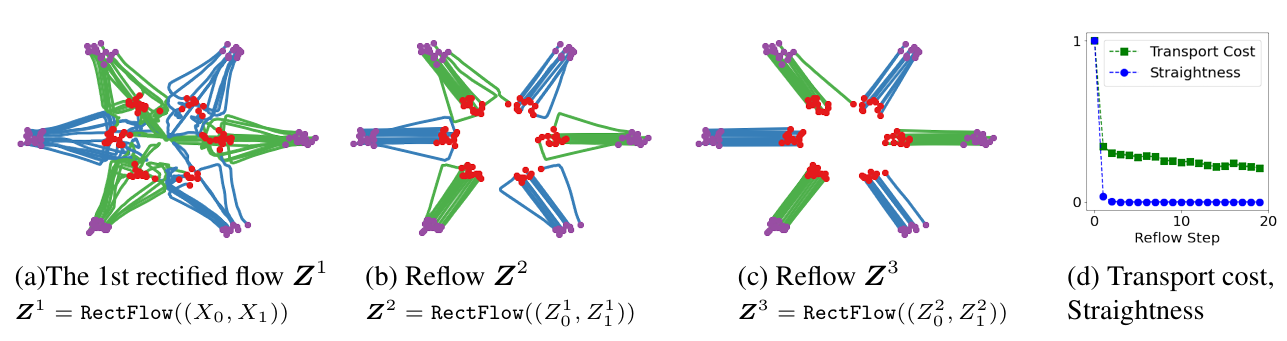
Reflow、轨迹直线化与快速模拟:当递归应用Z^{k+1}=\mathrm{RectFlow}((Z_0^k,Z_1^k))过程时,随着 k的增大,第 k阶 rectified flow Z^k的路径会逐渐趋于直线,因此在数值上更易于模拟。这种轨迹直线化趋势可以从理论上得到保证
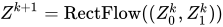
  • 具体而言,若一个流\mathrm{d}Z_t = v_X(Z_t, t) \mathrm{d}t几乎处处满足Z_t=tZ_1+(1-t)Z_0,\quad \forall t\in[0,1],或者等价地,沿每条轨迹都有v(Z_t,t)=Z_1-Z_0=\mathrm{const},则称该流是直线的
  • 此类直线流在计算上非常有吸引力,本质上是一个一步式模型:单步 Euler 更新Z_1=Z_0+v(Z_0,0)
  • 线性插值过程X=\{X_t\}按照上述定义是直线的,但它并不是一个因果流,因此在没有同时访问 \pi_0与 \pi_1样本的 oracle 的情况下无法进行模拟。相比之下,使一个因果流\mathrm{d}Z_t = v_X(Z_t, t) \mathrm{d}t成为直线流并非平凡任务。若要实现这一点,v必须满足无粘 Burgers 方程:\partial_t v+(\partial_z v)v=0.沿流轨迹有\frac{d}{dt}v(Z_t,t) = \partial_z v(Z_t,t)\dot{Z}_t+\partial_t v(Z_t,t) = \partial_z v(Z_t,t)v(Z_t,t)+\partial_t v(Z_t,t) = 0.
  • 任意光滑过程Z=\{Z_t\}的直线性可以通过S(Z)= \int_0^1 \mathbb{E} \left[ \left\| (Z_1-Z_0)-\dot{Z}_t \right\|^2 \right]dt量进行度量。当S(Z)=0时,表示过程具有精确直线性。若某个流的S(Z)较小,则说明其路径近似直线,因此可以使用较少的离散步数通过数值求解器进行准确模拟

[Theorem D.7]:令 Z^k表示由(X_0,X_1)诱导得到的第k阶 rectified flow,则有

\min_{k\in\{0,\cdots,K\}} S(Z^k) \leq \frac{\mathbb{E}[\|X_1-X_0\|^2]}{K}(6)

  • 仅执行一步 reflow 往往就可以得到近似直线的流模型,并且在单步 Euler 模拟下也能取得良好性能。但并不建议执行过多次 reflow,因为这可能导致对 v_X的估计误差逐步累积

蒸馏:在获得第 k阶 rectified flow  Z^k之后,可以进一步通过蒸馏提升推理速度。具体而言,可以将(Z_0^k,Z_1^k)之间的映射关系蒸馏到一个神经网络 \hat{T}中,使其无需模拟整个流过程,便可直接由Z_0^k预测Z_1^k。由于此时流轨迹已经近似直线,因此可以被单步更新良好近似,蒸馏过程也能够较为高效地完成。如果取\hat{T}(z_0)=z_0+v(z_0,0),则用于蒸馏Z^k的损失函数为

\mathbb{E} \left[ \left\| (Z_1^k-Z_0^k)-v(Z_0^k,0) \right\|^2 \right](7)

  • 蒸馏旨在忠实近似已有耦合(Z_0^k,Z_1^k),而 rectification 则会产生一个新的耦合(Z_0^{k+1},Z_1^{k+1}),并使其具有更低的传输代价和更直的流轨迹。因此,蒸馏应仅在最终阶段使用,用于将模型微调为一步推理形式

🎅 Flow Matching

论文提出 Flow Matching(FM)框架。这是一种 simulation-free 的 CNF 训练方法,其核心思想是:不再通过昂贵的轨迹求解来优化模型,而是直接让模型去回归一个能够生成目标概率路径的向量场。具体而言,作者考虑一类从噪声分布到数据分布的条件概率路径,并将训练目标转化为对这些路径对应速度场的匹配问题。CNF 的训练就不再依赖复杂的 ODE 数值模拟,而可以像监督学习一样直接进行优化

  • 提出 Conditional Flow Matching(CFM):虽然全局目标向量场通常难以直接计算,但可以通过逐样本的条件路径构造出等价的训练目标。模型并不需要显式知道难处理的整体流场,只需在样本级别上学习条件向量场,就能够获得与原始目标一致的梯度信号。这一点使得 Flow Matching 真正具备可实现性,也构成该方法能够扩展到大规模训练场景的核心基础
  • FM 并不局限于某一种特定路径,而是兼容一类通用的高斯概率路径。在这一框架下,现有扩散模型所采用的路径只是其中的一个特例。Flow Matching 一方面能够覆盖已有扩散模型的训练方式;另一方面,也为探索扩散之外的其他概率路径提供统一框架。即使仅在扩散路径上使用 FM,相比传统得分匹配方法,也能够获得更加稳健、更加稳定的训练效果
  • 它允许直接采用非扩散型概率路径来训练生成模型。其中最有代表性的例子,就是基于最优传输(Optimal Transport, OT)位移插值构造条件概率路径。与扩散路径相比,OT 路径通常更加简单,其样本轨迹更接近直线,而不是扩散过程中常见的弯曲轨迹。作者认为,这种更简洁的几何结构能够有效降低学习难度,并在经验上转化为更快的训练速度、更快的采样过程以及更好的泛化能力
  • 实验结果表明,使用 Flow Matching 训练得到的 CNF 模型,在样本质量和似然估计两个方面都能够稳定优于一系列基于扩散的替代方法;由于模型本身是连续时间动力系统,还可以直接结合现成的数值 ODE 求解器,实现快速且可靠的样本生成,在计算开销与生成性能之间取得更好的平衡

🦫 Preliminaries: Continuous Normalizing Flows

设\mathbb{R}^d表示数据空间,其中数据点记为x=(x_1,\dots,x_d)\in\mathbb{R}^d。两个重要对象:其一是概率密度路径p:[0,1]\times \mathbb{R}^d \to \mathbb{R}_{>0},它表示一个关于时间变化的概率密度函数,即满足\int p_t(x)\,dx = 1;其二是一个随时间变化的向量场v:[0,1]\times \mathbb{R}^d \to \mathbb{R}^d.

一个向量场v_t可以用来构造一个关于时间变化的微分同胚映射,称为流(flow),其定义满足如下常微分方程(ODE)
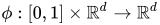
\phi:[0,1]\times \mathbb{R}^d \to \mathbb{R}^d  \frac{d}{dt}\phi_t(x) = v_t(\phi_t(x)), \quad \phi_0(x) = x(1)

此前,Chen 等人(2018)提出使用神经网络v_t(x;\theta)对向量场v_t进行建模,其中\theta\in\mathbb{R}^p表示可学习参数。由此可以得到一个对流映射\phi_t的深度参数化模型,称为连续归一化流(Continuous Normalizing Flow, CNF)。CNF 的作用是通过如下推前(push-forward)关系,将一个简单的先验密度p_0变换为一个更复杂的密度p_1

p_t=[\phi_t]_*p_0(2)

[\phi_t]_*p_0(x)=p_0(\phi_t^{-1}(x))\det \frac{\partial \phi_t^{-1}}{\partial x}(x)(3)

如果一个向量场v_t的流\phi_t满足式p_t=[\phi_t]_*p_0,则称该向量场v_t生成概率密度路径p_t。在实践中,判断一个向量场是否生成某条概率路径的一种有效方法,是利用连续性方程(continuity equation)

🕊️ Flow Matching

设 服从未知数据分布 ,只能获得来自该分布的数据样本,而无法直接访问其概率密度函数。考虑一条概率路径 ,其中 是简单分布,例如标准正态分布 ,而 在分布意义上近似于 。Flow Matching 的目标是匹配这条概率路径,使 CNF 将 变换为 。给定目标概率密度路径 及生成该路径的向量场 ,Flow Matching(FM)目标定义为

(4)
  • 其中, 表示 CNF 向量场 的可学习参数,,且 。FM 损失通过神经网络 回归目标向量场 ;当损失达到零时,所学习的 CNF 便生成概率路径

然而,这个目标还不能直接用于实际训练,因为尚不知道如何选择合适的 和 。满足 的概率路径有许多种,而生成指定路径 的向量场 通常没有已知的闭式表达。论文接下来从仅依赖单个数据样本的条件概率路径和条件向量场出发,通过适当聚合构造 与 ,并据此得到更易计算的训练目标

构造目标概率路径的一种简单方式,是混合若干更简单的概率路径。给定数据样本 ,记 为一条条件概率路径,并要求它在 时满足 。在 时,将 设计为集中在 附近的分布,例如 ,其中标准差 足够小。对这些条件概率路径关于 边缘化,得到边缘概率路径

(5)
  • 特别地,在 时,边缘分布 是一个逼近数据分布 的混合分布
(6)
  • 类似地,还可以通过对条件向量场加权聚合来定义边缘向量场。假设对所有 和 均有 ,定义
(7)

其中, 是生成条件概率路径 的条件向量场。上述聚合方式的关键在于:得到的边缘向量场 恰好生成边缘概率路径 。这建立起条件向量场与边缘向量场之间的联系,使未知且难以直接处理的边缘向量场,可以通过更简单的条件向量场来构造;后者只依赖单个数据样本,因而更易于定义。这一性质由以下定理给出

Theorem 1. 若 生成条件概率路径 ,则对任意数据分布 ,式(7)的边缘向量场 生成式(5)的边缘概率路径 ,即二者满足连续性方程

尽管上述构造给出 和 的表达式,但二者的定义仍包含难以处理的积分,因此依然难以计算边缘向量场 ,也无法直接构造原始 FM 目标的无偏估计。为此,论文提出一个更简单、且与原始目标具有相同最优解的替代目标,即 Conditional Flow Matching(CFM)

(8)
  • 其中,,,此时 。与 FM 目标不同,只要能够高效地从 采样,并计算 ,就能构造 CFM 目标的无偏估计。这两项操作都在单样本层面定义,可以通过选择合适的条件路径及条件向量场实现

FM 与 CFM 目标关于参数 的梯度完全一致,因此优化 CFM 在期望意义上等价于优化 FM。 由此,无需显式计算边缘概率路径 或边缘向量场 ,也能训练 CNF 来生成 ,并在 时逼近未知数据分布 。训练所需的构造因此归结为条件概率路径及其对应的条件向量场。这一等价性由以下定理给出

Theorem 2. 假设对所有 和 均有 ,则 与 仅相差一个与 无关的常数,因而

🕊️ Conditional Probability Paths And Vector Fields

Conditional Flow Matching 目标适用于任意条件概率路径及其对应的条件向量场。下面考虑一类一般的高斯条件概率路径,并构造相应的p_t(x\mid x_1)与u_t(x\mid x_1)。设条件概率路径具有如下形式

p_t(x\mid x_1)=\mathcal{N}\!\bigl(x\mid \mu_t(x_1),\sigma_t(x_1)^2 I\bigr)(9)

  • 其中\mu:[0,1]\times \mathbb{R}^d \to \mathbb{R}^d表示高斯分布随时间变化的均值函数,而\sigma:[0,1]\times \mathbb{R}^d \to \mathbb{R}_{>0}表示随时间变化的标量标准差函数。令均值与标准差满足以下边界条件

\begin{gather*}
\mu_0(x_1) = 0, \quad \sigma_0(x_1) = 1, \\
\mu_1(x_1) = x_1, \quad \sigma_1(x_1) = \sigma_{\min}, \quad \sigma_{\min} \ll 1.
\end{gather*}(10)

  • 这些边界条件使所有条件路径在 t=0 时对应同一个标准高斯分布,并在 t=1 时集中于数据样本 x_1 附近,即

\begin{gather*}
p_0(x \mid x_1) = \mathcal{N}(x \mid 0, I), \\
p_1(x \mid x_1) = \mathcal{N}(x \mid x_1, \sigma_{\min}^2 I).
\end{gather*}(11)

对于给定的概率路径,能够生成该路径的向量场一般并非唯一。若在速度场中加入 w_t,且满足 \nabla\!\cdot(p_t w_t)=0,连续性方程便保持不变。这类差异来自不会改变底层分布本身的分量。例如,当分布具有旋转不变性时,额外加入旋转分量并不会改变其概率分布,却会带来不必要的额外计算开销

  • 作者选择采用与高斯分布的一个规范变换(canonical transformation)相对应的简单向量场。给定数据样本 x_1,定义条件流映射

\psi_t(x)=\sigma_t(x_1)x+\mu_t(x_1). (12)

当x服从标准高斯分布时,\psi_t(x)服从均值为\mu_t(x_1)、标准差为\sigma_t(x_1)的高斯分布。因此,\psi_t能够将噪声分布p_0(x\mid x_1)=p(x)推送到条件概率路径p_t(x\mid x_1),即[\psi_t]_*p(x)=p_t(x\mid x_1)

  • 由条件仿射流\psi_t(x)=\sigma_t(x_1)x+\mu_t(x_1)可知,条件样本的演化由对应向量场u_t(x\mid x_1)所驱动,并满足

\frac{d}{dt}\psi_t(x)=u_t(\psi_t(x)\mid x_1).(13)

  • 进一步地,将条件路径写成对初始噪声变量x_0\sim p(x_0)的重参数化形式,并代入 Conditional Flow Matching 目标,可将训练过程写为对网络向量场v_t与真实条件速度场\frac{d}{dt}\psi_t(x_0)之间的平方误差回归

\mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{t, q(x_1), p(x_0)} \left\| v_t(\psi_t(x_0)) - \frac{d}{dt}\psi_t(x_0) \right\|^2.(14)

由于 是一个简单的可逆仿射映射,可以由式(13)求得 的闭式表达。对随时间变化的函数 ,记 ,则有如下结论

Theorem 3. 对于式(9)的高斯条件概率路径 和式(12)的仿射流,定义 的唯一向量场为

(15)

因此, 生成高斯概率路径

🕊️ Special Instances Of Gaussian Conditional Probability Paths

扩散条件向量场(Diffusion Conditional VFs):扩散模型从数据点出发,逐步向其中加入噪声,直至其近似为纯噪声。这一过程可以表述为随机过程;而为在任意时刻t获得闭式表达,随机过程必须满足较为严格的条件。高斯形式的条件概率路径p_t(x\mid x_1)的均值\mu_t(x_1)与标准差\sigma_t(x_1)具有特定选取方式

方差爆炸型(Variance Exploding, VE)路径:其中\sigma_t是一个递增函数,满足\sigma_0=0且\sigma_1\gg 1

p_t(x\mid x_1)=\mathcal N(x\mid x_1,\sigma_{1-t}^2 I)\mu_t(x_1)=x_1,\quad \sigma_t(x_1)=\sigma_{1-t}.(16)

u_t(x\mid x_1)= -\frac{\sigma'_{1-t}}{\sigma_{1-t}}(x-x_1)(17)

方差保持型(Variance Preserving, VP)扩散路径具有如下形式

p_t(x \mid x_1) = \mathcal{N}(x \mid \alpha_{1-t} x_1, (1 - \alpha_{1-t}^2) I), \text{ where } \alpha_t = e^{-\frac{1}{2} T(t)}, T(t) = \int_0^t \beta(s)ds(18)

u_t(x \mid x_1) = \frac{\alpha'_{1-t}}{1 - \alpha_{1-t}^2} (\alpha_{1-t} x - x_1) = -\frac{T'(1-t)}{2} \left[ \frac{e^{-T(1-t)} x - e^{-\frac{1}{2} T(1-t)} x_1}{1 - e^{-T(1-t)}} \right].(19)

对于这些条件扩散过程而言,所构造的条件向量场u_t(x\mid x_1)与先前在确定性概率流中使用的向量场是一致的。尽管如此,将这种扩散条件向量场与 Flow Matching 目标结合,仍提供一种极具吸引力的训练替代方案

最优传输条件向量场(Optimal Transport Conditional VFs):令其均值与标准差均随时间作线性变化

\mu_t(x_1) = tx_1, \text{ and } \sigma_t(x_1) = 1 - (1 - \sigma_{\min})t.(20)

可知该路径由如下向量场生成

u_t(x \mid x_1) = \frac{x_1 - (1 - \sigma_{\min})x}{1 - (1 - \sigma_{\min})t}(21)

与扩散条件向量场不同的是,该向量场在整个t\in[0,1]区间上均有定义。与u_t(x\mid x_1)对应的条件流为

\psi_t(x) = (1 - (1 - \sigma_{\min})t)x + tx_1(22)

在这种情形下,CFM 损失可写为

\mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{t, q(x_1), p(x_0)} \left\| v_t(\psi_t(x_0)) - (x_1 - (1 - \sigma_{\min})x_0) \right\|^2.(23)

令均值与标准差作线性变化,不仅能够得到简洁且直观的概率路径,而且这种构造在下述意义下还是最优的。条件流\psi_t(x)实际上是两个高斯分布p_0(x\mid x_1)与p_1(x\mid x_1)之间的最优传输位移映射。从直观上看,在 OT 位移映射下,粒子始终沿直线轨迹、以恒定速度运动。从扩散路径进行采样时,轨迹可能会越过最终样本,从而产生不必要的回溯;相比之下,OT 路径则保证始终保持直线形态

🕊️ Theorem Proofs

𝓣𝓱𝓮𝓸𝓻𝓮𝓶 𝟏 :由条件向量场加权聚合得到的边缘向量场,能够生成由条件概率路径边缘化所得的边缘概率路径

\begin{aligned}
\frac{d}{dt} p_t(x) &= \int \left( \frac{d}{dt} p_t(x|x_1) \right) q(x_1) dx_1 = - \int \mathrm{div} \left( u_t(x|x_1) p_t(x|x_1) \right) q(x_1) dx_1 \\
&= -\mathrm{div} \left( \int u_t(x|x_1) p_t(x|x_1) q(x_1) dx_1 \right) = -\mathrm{div}(u_t(x) p_t(x)),
\end{aligned}(24)

𝓣𝓱𝓮𝓸𝓻𝓮𝓶 𝟐 :假设对于任意x\in\mathbb{R}^d以及t\in[0,1],均有p_t(x)>0。则在忽略与参数\theta无关的常数项后,条件 Flow Matching 损失L_{\mathrm{CFM}}与 Flow Matching 损失L_{\mathrm{FM}}相等。因此,有\nabla_\theta L_{\mathrm{FM}}(\theta)=\nabla_\theta L_{\mathrm{CFM}}(\theta).

  • 为保证下述各积分均存在,并使后续能够依据 Fubini 定理交换积分次序,假设\|x\|\to\infty时,q(x)与p_t(x\mid x_1)均以足够快的速度衰减至零;同时u_t、v_t以及\nabla_\theta v_t都是有界的。首先,由欧氏范数平方的标准双线性展开可得

\begin{aligned}
\|v_t(x) - u_t(x)\|^2 &= \|v_t(x)\|^2 - 2\langle v_t(x), u_t(x)\rangle + \|u_t(x)\|^2 \\
\|v_t(x) - u_t(x|x_1)\|^2 &= \|v_t(x)\|^2 - 2\langle v_t(x), u_t(x|x_1)\rangle + \|u_t(x|x_1)\|^2
\end{aligned}(25)

  • 接下来,注意到u_t与参数\theta无关,并且有

\begin{aligned}
\mathbb{E}_{p_t(x)}\|v_t(x)\|^2 &= \int \|v_t(x)\|^2 p_t(x)dx = \int \|v_t(x)\|^2 p_t(x|x_1)q(x_1)dx_1 dx \\
&= \mathbb{E}_{q(x_1),p_t(x|x_1)}\|v_t(x)\|^2,
\end{aligned}(26)

  • 进一步地

\begin{aligned}
\mathbb{E}_{p_t(x)} \langle v_t(x), u_t(x) \rangle &= \int \left\langle v_t(x), \frac{\int u_t(x|x_1)p_t(x|x_1)q(x_1)dx_1}{p_t(x)} \right\rangle p_t(x)dx \\
&= \int \left\langle v_t(x), \int u_t(x|x_1)p_t(x|x_1)q(x_1)dx_1 \right\rangle dx \\
&= \int \langle v_t(x), u_t(x|x_1) \rangle p_t(x|x_1)q(x_1)dx_1 dx \\
&= \mathbb{E}_{q(x_1),p_t(x|x_1)} \langle v_t(x), u_t(x|x_1) \rangle,
\end{aligned}(27)

Theorem 3:给定上述仿射流映射,其对应的条件速度场由流方程唯一确定,从而将条件 Flow Matching 的监督目标具体化

  • 为简化记号,记w_t(x)=u_t(x\mid x_1).现考虑

\frac{d}{dt}\psi_t(x)=w_t(\psi_t(x)).(28)

  • 由于\psi_t是可逆的(因为\sigma_t(x_1)>0),令x=\psi_t^{-1}(y),则有

\psi_t'(\psi_t^{-1}(y))=w_t(y)(29)

  • 另一方面,由\psi_t(x)的表达式可得其逆映射为

\psi_t^{-1}(y) = \frac{y - \mu_t(x_1)}{\sigma_t(x_1)}.(30)

\psi_t'(x) = \sigma_t'(x_1)x + \mu_t'(x_1).(31)

  • 将上述两个式子代入,即可得到

w_t(y) = \frac{\sigma_t'(x_1)}{\sigma_t(x_1)}(y - \mu_t(x_1)) + \mu_t'(x_1)(32)

🎨 Stable Diffusion 3 (SD3)

Rectified Flow 是近年来提出的一类生成模型框架,其核心思想是在数据分布与噪声分布之间构造近似直线的传输路径。相比传统扩散模型中较为复杂的弯曲轨迹,Rectified Flow 在理论性质和概念形式上更为简洁。然而,尽管其具有潜在优势,该方法尚未在实际应用中被确立为主流或标准范式

  • 针对 Rectified Flow 模型训练中的噪声尺度采样策略进行改进,通过将采样分布偏向更具感知相关性的噪声尺度,提升模型对关键生成阶段的学习能力
  • 提出一种新的基于 Transformer 的文本到图像生成架构。不同于传统方法中将固定文本表示作为条件输入的设计,该架构分别为图像模态和文本模态设置独立的参数化表示通路,并允许图像 token 与文本 token 在网络内部进行双向信息交互,从而增强模型的文本理解能力、文字生成与排版能力,并提升人类偏好评价结果
  • 论文证明该架构具有可预测的缩放规律,即随着模型规模和训练配置的变化,验证损失呈现出稳定的下降趋势。实验结果表明,验证损失越低,模型在多种自动评估指标和人类评估中的文本到图像生成质量通常越高

关键问题:应当选择怎样的前向路径

  • 前向路径的选择会对采样过程产生重要影响。例如,如果某一前向过程在终点仍残留数据信号,未能充分转化为纯噪声,则可能导致训练分布与测试分布之间出现不一致,进而在生成结果中产生诸如灰色图像样本等伪影
  • 前向过程的设计还会影响模型所学习到的反向过程,从而进一步影响采样效率。相较于弯曲路径,直线路径在理想情况下可以通过单步积分进行模拟,并且不易受到误差累积的影响。由于采样过程中的每一步通常都对应一次神经网络前向计算,因此路径形式的选择会直接影响模型的采样速度
  • Rectified Flow 是一种特殊的前向路径设计方式,其核心思想是在数据与噪声之间建立直线连接。尽管这类模型在理论性质上具有优势,但其尚未在实践中被明确确立为主流方法

🦨 Simulation-Free Training Of Flows

考虑一类生成模型,其目标是在噪声分布 p_1中的样本 x_1与数据分布 p_0中的样本 x_0之间建立映射关系。该映射可以通过如下常微分方程(ordinary differential equation, ODE)来刻画
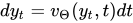
dy_t = v_\Theta(y_t, t) dt(1)

其中速度场v_{\Theta}由神经网络参数 \Theta进行参数化。Chen 早期工作提出,可以通过可微 ODE 求解器直接求解上述方程。然而,这一过程通常具有较高的计算成本,尤其是在使用大规模神经网络结构来参数化v_{\Theta}(y_t,t)时,计算开销会进一步增加。一种更高效的替代方案是:不直接通过数值求解 ODE 来模拟生成过程,而是直接回归一个向量场 u_t,使其能够在数据分布 p_0与噪声分布 p_1之间生成一条概率路径。为构造这样的u_t,首先定义一个前向过程,用以描述连接 p_0与p_1=\mathcal{N}(0,I)的概率路径 p_t

z_t = a_t x_0 + b_t \epsilon \quad \text{where } \epsilon \sim \mathcal{N}(0, I) .(2)

当满足a_0 = 1,b_0 = 0,a_1 = 0,b_1 = 1时,该过程在t=0时对应数据分布,在t=1时对应噪声分布。其边缘分布可写为

p_t(z_t) = \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} p_t(z_t \mid \epsilon)(3)

因此与数据分布和噪声分布保持一致。为刻画z_t、x_0与\epsilon之间的关系,引入映射 \psi_t及其对应的条件向量场 u_t

\psi_t(\cdot | \epsilon) : x_0 \mapsto a_t x_0 + b_t \epsilon(4)

u_t(z | \epsilon) := \psi'_t(\psi_t^{-1}(z | \epsilon) | \epsilon)(5)

由于 z_t可以看作z_t' = u_t(z_t \mid \epsilon)的解,并且其初始值为z_0=x_0,因此条件向量场u_t(\cdot \mid \epsilon)能够生成条件概率路径p_t(\cdot \mid \epsilon)。值得注意的是,基于这些条件向量场,可以进一步构造出一个边缘向量场 u_t,使其生成边缘概率路径p_t。具体形式为

u_t(z) = \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} u_t(z|\epsilon) \frac{p_t(z|\epsilon)}{p_t(z)}(6)

如果直接使用 Flow Matching 目标来回归边缘向量场u_t,则目标函数为

\mathcal{L}_{FM} = \mathbb{E}_{t, p_t(z)} \| v_\Theta(z, t) - u_t(z) \|_2^2(7)

然而,由于上述边缘向量场涉及对 \epsilon的边缘化计算,直接优化该目标在实践中是不可行的。相比之下,Conditional Flow Matching 使用条件向量场u_t(z\mid \epsilon)构造如下目标

\mathcal{L}_{CFM} = \mathbb{E}_{t, p_t(z|\epsilon), p(\epsilon)} \| v_\Theta(z, t) - u_t(z|\epsilon) \|_2^2 ,(8)

为将上述损失函数转化为显式形式,将\psi_t'(x_0\mid \epsilon) = a_t' x_0 + b_t' \epsilon以及\psi_t^{-1}(z\mid \epsilon) = \frac{z-b_t\epsilon}{a_t}代入条件向量场的定义中,可得

z_t' = u_t(z_t \mid \epsilon) = \frac{a_t'}{a_t}z_t - \epsilon b_t \left( \frac{a_t'}{a_t} - \frac{b_t'}{b_t} \right).(9)

进一步地,定义信噪比的对数形式为\lambda_t := \log \frac{a_t^2}{b_t^2},则有\lambda_t' = 2 \left( \frac{a_t'}{a_t} - \frac{b_t'}{b_t} \right).因此,上式可以重写为

u_t(z_t|\epsilon) = \frac{a'_t}{a_t}z_t - \frac{b_t}{2}\lambda'_t\epsilon(10)

随后,可以利用该形式将 Conditional Flow Matching 目标重新参数化为一个噪声预测目标

\mathcal{L}_{CFM} = \mathbb{E}_{t,p_t(z|\epsilon),p(\epsilon)}\|v_\Theta(z, t) - \frac{a'_t}{a_t}z + \frac{b_t}{2}\lambda'_t\epsilon\|_2^2

= \mathbb{E}_{t,p_t(z|\epsilon),p(\epsilon)}\left(-\frac{b_t}{2}\lambda'_t\right)^2\|\epsilon_\Theta(z, t) - \epsilon\|_2^2(11)

\text{where}\quad \epsilon_\Theta := \frac{-2}{\lambda'_t b_t}(v_\Theta - \frac{a'_t}{a_t}z).(12)

在各时间步的权重严格为正、且模型能够表示理想条件期望的前提下,时间加权不改变最优预测函数;有限容量模型的最优参数则可能随权重改变。因此,可以推导出多种加权损失函数形式。这些加权形式虽然都能够为模型提供朝向期望解的训练信号,但可能会影响优化过程中的训练轨迹。为在统一框架下分析不同方法,包括经典扩散模型表述,可以参照将目标函数写为如下形式

\begin{aligned}
&\mathcal{L}_w(x_0) = -\frac{1}{2}\mathbb{E}_{t \sim \mathcal{U}(t), \epsilon \sim \mathcal{N}(0,I)} \left[ w_t \lambda'_t \| \epsilon_\Theta(z_t, t) - \epsilon \|^2 \right] , \\[8pt]
&\text{where } w_t = -\frac{1}{2}\lambda'_t b_t^2 \text{ corresponds to } \mathcal{L}_{CFM} .
\end{aligned}(13)

🛤️ Flow Trajectories

Rectified Flow 将前向过程定义为数据分布与标准正态分布之间的直线路径
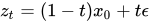
z_t = (1-t)x_0 + t\epsilon(14)

  • 模型优化\mathcal{L}_{\mathrm{CFM}},其对应的权重形式为w_t^{\mathrm{RF}} = \frac{t}{1-t}.此时,神经网络的输出直接用于参数化速度场v_\Theta

EDM 采用如下形式的前向过程

z_t = x_0 + b_t\epsilon, \quad \text{where } b_t = \exp F_{\mathcal{N}}^{-1}(t|P_m, P_s^2)(15)

  • 其中F_{\mathcal{N}}^{-1}表示均值为P_m、方差为 P_s^2的正态分布的分位数函数
  • 当 t \sim U(0,1)时,对数信噪比满足\lambda_t \sim \mathcal{N}(-2P_m, (2P_s)^2).EDM 中的网络采用 F-prediction 参数化形式,其损失函数可以写成统一加权形式L_w,对应的权重为w_t^{\mathrm{EDM}} = \mathcal{N}(\lambda_t \mid -2P_m, (2P_s)^2) \left( e^{-\lambda_t} + 0.5^2 \right).

Nichol 和 Dhariwal 提出如下形式的前向过程

z_t = \cos\left(\frac{\pi}{2}t\right)x_0 + \sin\left(\frac{\pi}{2}t\right)\epsilon .(16)

  • 当该前向过程与 ϵ-parameterization 以及对应的噪声预测损失结合时,其对应的权重为w_t = \mathrm{sech}\left(\frac{\lambda_t}{2}\right).
  • 当其与 v-prediction 损失结合时,对应的权重则为w_t = e^{-\lambda_t/2}.

LDM 采用对 DDPM 噪声调度策略的修改版本。二者都属于方差保持型调度,即满足b_t = \sqrt{1-a_t^2}.
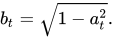
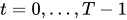
  • 在离散时间步t=0,\ldots,T-1上,a_t由扩散系数 \beta_t定义为a_t = \left( \prod_{s=0}^{t}(1-\beta_s) \right)^{1/2}
  • 给定边界值\beta_0和\beta_{T-1}时,DDPM 采用线性的 \beta调度\beta_t = \beta_0 + \frac{t}{T-1} (\beta_{T-1}-\beta_0)
  • LDM 则采用对\sqrt{\beta}进行线性插值的调度方式\beta_t = \left( \sqrt{\beta_0} + \frac{t}{T-1} \left( \sqrt{\beta_{T-1}}-\sqrt{\beta_0} \right) \right)^2
  • DDPM 是直接在\beta_t上做线性插值,而 LDM 是先对 \sqrt{\beta_t}做线性插值,再平方得到最终的 \beta_t

🦦 Tailored SNR Samplers For RF Models

RF 损失在[0,1]的所有时间步上均匀地训练速度场v_\Theta。从直觉上看,所得的速度预测目标\epsilon - x_0在区间中部的时间步上更难学习。因为当t=0时,输入已给定数据样本,未知噪声的最优估计是噪声分布p_1的均值,因此 v^*(x_0,0)=\mathbb E[\epsilon]-x_0=-x_0。当t=1时,输入已给定噪声,未知数据的最优估计是数据分布p_0的均值,因此 v^*(\epsilon,1)=\epsilon-\mathbb E[x_0]。一般而言,将时间步 t的采样分布从常用的均匀分布U(t)改为具有密度 \pi(t)的分布,等价于引入一个加权损失\mathcal{L}^{w^\pi}_t,其中权重为

w_t^\pi = \frac{t}{1-t}\pi(t).(17)

  • 通过更频繁地采样中间时间步,为这些时间步赋予更大的训练权重

Logit-Normal Sampling:一种能够对中间时间步赋予更高权重的分布是 logit-normal 分布。其密度函数为
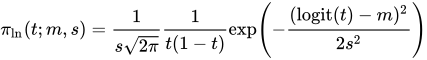
\pi_{\mathrm{ln}}(t;m,s) = \frac{1}{s\sqrt{2\pi}} \frac{1}{t(1-t)} \exp \left( -\frac{(\mathrm{logit}(t)-m)^2}{2s^2} \right)(18)

\mathrm{logit}(t) = \log \frac{t}{1-t}.(19)

  • 该分布包含位置参数 m 和尺度参数 s。位置参数 m 能够将训练时间步偏向数据分布p_0 或噪声分布 p_1
  • 当m<0时,采样更偏向数据端p_0;当m>0 时,采样更偏向噪声端p_1。尺度参数 s 控制分布的宽度
  • 从正态分布中采样随机变量u \sim \mathcal{N}(m,s^2),然后通过标准 logistic 函数将其映射到区间[0,1],从而得到时间步t

Mode Sampling with Heavy Tails:Logit-normal 密度在端点 0 和 1 处始终趋于零。为研究这一性质是否会对模型性能产生不利影响,采用一种在整个区间 [0,1]上都具有严格正密度的时间步采样分布。给定尺度参数 s,定义如下函数

f_{\mathrm{mode}}(u;s) = 1-u - s\cdot \left( \cos^2\left(\frac{\pi}{2}u\right)-1+u \right).(20)

  • 当-1 \leq s \leq \frac{2}{\pi-2}时,该函数是单调的。可以利用该函数所诱导的分布进行采样,其对应的密度为\pi_{\mathrm{mode}}(t;s) = \left|\frac{d}{dt}f_{\mathrm{mode}}^{-1}(t;s)\right|.
  • 尺度参数 s 控制采样过程中对不同区域的偏好程度:当 s>0时,采样更偏向区间中点;而当s<0时,采样更偏向两个端点。该形式也包含均匀采样作为一个特殊情形,即当s=0时,\pi_{\mathrm{mode}}(t;s=0)=U(t).

CosMap 找到一个映射f:u \mapsto f(u)=t, u\in[0,1],使得其对应的对数信噪比与 cosine schedule 的对数信噪比一致,即满足
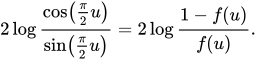
2\log \frac{ \cos\left(\frac{\pi}{2}u\right) }{ \sin\left(\frac{\pi}{2}u\right) } = 2\log \frac{1-f(u)}{f(u)}.(21)

  • 对该方程求解:当u\sim U(u)时,有t=f(u) = 1- \frac{1}{ \tan\left(\frac{\pi}{2}u\right)+1 }.由此可以得到对应的时间步密度

\pi_{\mathrm{CosMap}}(t) = \frac{d}{dt}f^{-1}(t) = \frac{2}{ \pi-2\pi t+2\pi t^2 }.(22)

🦫 Text-To-Image Architecture

对于文本条件图像采样任务,模型需要同时建模文本与图像两种模态。整体设置遵循 LDM的做法,即在预训练自编码器的潜在空间中训练文本到图像生成模型。类似于将图像编码为潜在表示的过程,同时沿用已有方法,使用预训练且冻结的文本模型对文本条件 c 进行编码
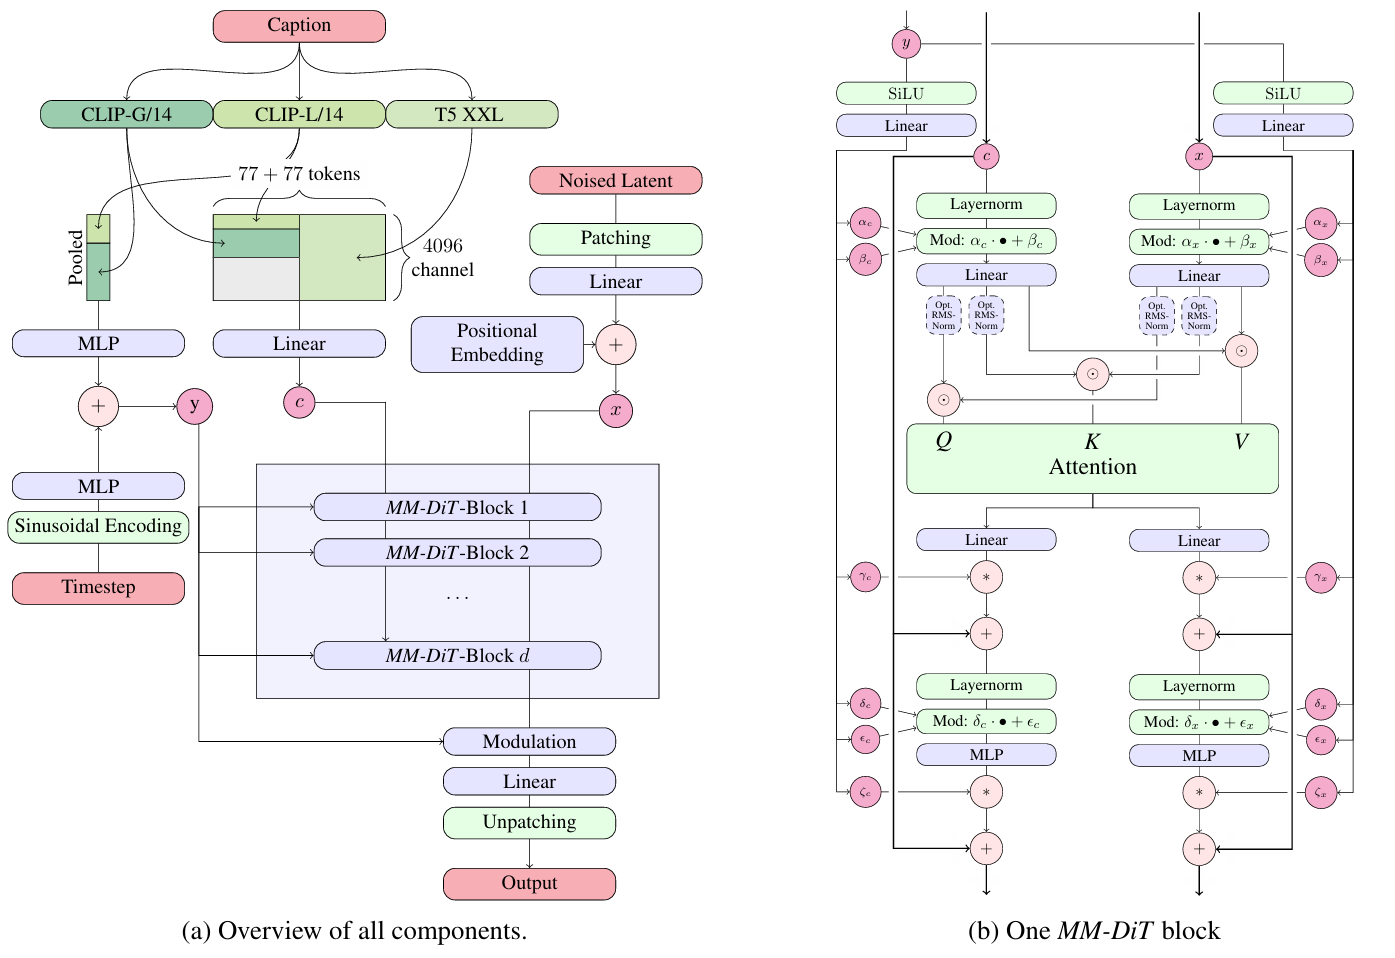
多模态扩散骨干网络:模型架构建立在 DiT 之上。DiT 主要面向类别条件图像生成任务,并通过调制机制将扩散过程的时间步信息和类别标签信息注入网络。类似地,将时间步 t的嵌入以及文本向量表示c_{\mathrm{vec}}作为调制机制的输入。然而,由于池化后的文本表示通常只保留文本输入中的粗粒度信息,网络还需要进一步利用文本的序列级表示c_{\mathrm{ctxt}}

  • 构造一个由文本输入嵌入和图像输入嵌入共同组成的序列。具体而言,对于潜在像素表示x \in \mathbb{R}^{h \times w \times c},首先加入位置编码,并将其划分为 2×2 的 patch,然后展平为长度为\frac{h}{2}\cdot \frac{w}{2}的图像 patch 编码序列。随后将该图像 patch 编码序列与文本序列表示c_{\mathrm{ctxt}}映射到相同的特征维度,并将二者在序列维度上进行拼接。遵循 DiT 的设计,依次应用一系列带调制机制的注意力层和 MLP 层
  • 由于文本嵌入和图像嵌入在语义和结构上具有显著差异,为两种模态分别设置独立的参数。这一设计等价于为文本模态和图像模态各自构建一个独立的 Transformer;但在注意力计算时,将两种模态的 token 序列合并在一起,从而使两种表示能够在各自的特征空间中进行处理,同时又能够通过注意力机制感知并利用另一种模态的信息​