Generative Models VI
🪐 Flow-GRPO: Training Flow Matching Models via Online RL
流匹配模型凭借坚实的理论基础和出色的高质量图像生成能力,已在图像生成领域占据主导地位。在构建涉及多个对象、属性及其相互关系的复杂场景 ,以及进行文字渲染时,这类模型仍然面临困难
- 与此同时,在线强化学习已被证明能够有效增强大语言模型的推理能力。已有研究主要关注将强化学习应用于早期的扩散生成模型,或者将直接偏好优化等离线强化学习技术用于基于流的生成模型
- 在线强化学习在提升流匹配生成模型方面的潜力,仍在很大程度上尚未得到探索
本文研究如何利用在线强化学习,有效提升流匹配模型的能力。利用强化学习训练流模型面临若干关键挑战
- 流模型的 ODE 采样器在给定初始噪声后沿确定性轨迹生成样本,后续步骤不再引入随机性。策略梯度训练需要可计算的随机转移概率,以支持轨迹探索与概率比更新。因此,Flow-GRPO 在每个去噪步骤中引入随机转移
- 在线强化学习依赖高效采样来收集训练数据,但流模型通常需要经过多次迭代才能生成一个样本,从而限制采样效率。对于大规模模型,这一问题更加突出。因此,要使强化学习能够实际应用于图像或视频生成等任务,提高采样效率至关重要
为解决上述挑战,提出 Flow-GRPO,通过两项关键策略,将 GRPO 引入用于文生图的流匹配模型
- 首先,采用 ODE-to-SDE 策略,克服原始流模型的确定性限制。通过将基于 ODE 的流转换为等价的随机微分方程框架,在保持原始边缘分布不变的同时引入随机性
- 其次,为提高在线强化学习的采样效率,采用去噪步数缩减策略,在训练期间减少去噪步数,而在推理期间保留完整的采样调度。实验表明,使用较少的去噪步数,能够在保持性能的同时,显著降低数据生成成本
- 采用不同类型奖励的文生图任务上评估 Flow-GRPO:可验证奖励和基于模型的奖励(例如用于衡量人类偏好的 PickScore 奖励)
综上,Flow-GRPO 的主要贡献如下
- 通过将确定性的 ODE 采样转换为 SDE 采样,Flow-GRPO 将 GRPO 引入流匹配模型。在 GenEval 组合图像生成基准上,SD3.5-M 的准确率从 63% 提升至 95%,同时保持相近的图像质量
- 对流匹配模型进行在线强化学习时,收集训练样本并不需要采用标准设置中的较多去噪步数。通过在训练期间使用较少的去噪步数,并在测试期间保留原始步数,可以显著加快训练过程
- Kullback–Leibler(KL)约束能够有效防止奖励投机,即以牺牲图像质量或多样性为代价来提高奖励的现象。从实证结果来看,KL 正则化并不等价于提前停止训练。采用适当的 KL 项后,尽管需要更长的训练时间,但仍能够在保持图像质量的同时,达到不使用 KL 约束时的高奖励水平
📡 Related Work
扩散与流匹配:扩散模型向数据中添加高斯噪声,并训练神经网络来逆转这一过程。采样时,通过离散的 DDPM 步骤、逆时间 SDE 求解器或概率流 ODE 求解器,生成高保真输出。流匹配则通过直接匹配速度场,学习一个连续时间归一化流,从而仅需少量 ODE 步骤即可进行高效的确定性采样。与扩散模型相比,流匹配使用少得多的去噪步骤便能取得具有竞争力的 FID,因此已成为近期图像生成模型和视频生成模型的主流选择
流匹配:设 为来自真实分布的数据样本,
 为标准高斯噪声样本,即
 。近期图像生成模型采用 Rectified Flow 框架,加噪数据
 定义为
- 随后,通过最小化流匹配目标,训练 Transformer 模型直接回归速度场

流匹配模型中的迭代去噪过程可以形式化为马尔可夫决策过程
表示去噪策略, 表示确定性状态转移, 是初始状态分布; 表示以 为中心的狄拉克分布 - 奖励仅在最后一步给出:当
、动作生成最终样本时, ;其余步骤的奖励均为 0
🌊 Flow-GRPO
流匹配中的 GRPO 通过最大化带 KL 正则项的期望累积奖励,优化策略
- 去噪过程可以被形式化为一个马尔可夫决策过程。给定提示
 ,流模型
 采样生成一组包含
 张图像的样本
 ,以及相应的逆时间轨迹
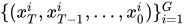 。在下述目标中,
 表示完整轨迹。随后,通过组内奖励标准化,计算第
 张图像的优势,同一图像的各去噪步骤共享该优势。组内标准差为 0 时将优势置 0,数值实现可在分母加入稳定项
- GRPO 通过最大化以下目标来优化策略模型
从 ODE 到 SDE。GRPO 依赖式(5)和式(6)中的随机采样,生成多样化的轨迹,以进行优势估计和探索。扩散模型天然支持这一过程:前向过程逐步添加高斯噪声,逆向过程则通过方差递减的马尔可夫链,近似实现基于得分的 SDE 求解器。相比之下,流匹配模型使用确定性的 ODE 描述前向过程
- 其中,
 通过式(2)中的流匹配目标学习得到。一种常用的采样方法是对这一 ODE 进行离散化,从而在相邻时间步之间建立确定性映射
- 这种确定性方法在两个关键方面无法满足 GRPO 的策略更新要求。
 要求计算
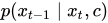 ,而确定性 ODE 的条件转移是狄拉克分布,不能直接采用普通连续密度比进行 GRPO 更新。对整个生成分布计算似然所需的散度积分,是另一类计算问题。确定性采样在初始噪声之外不再引入随机性,也限制后续步骤中的探索
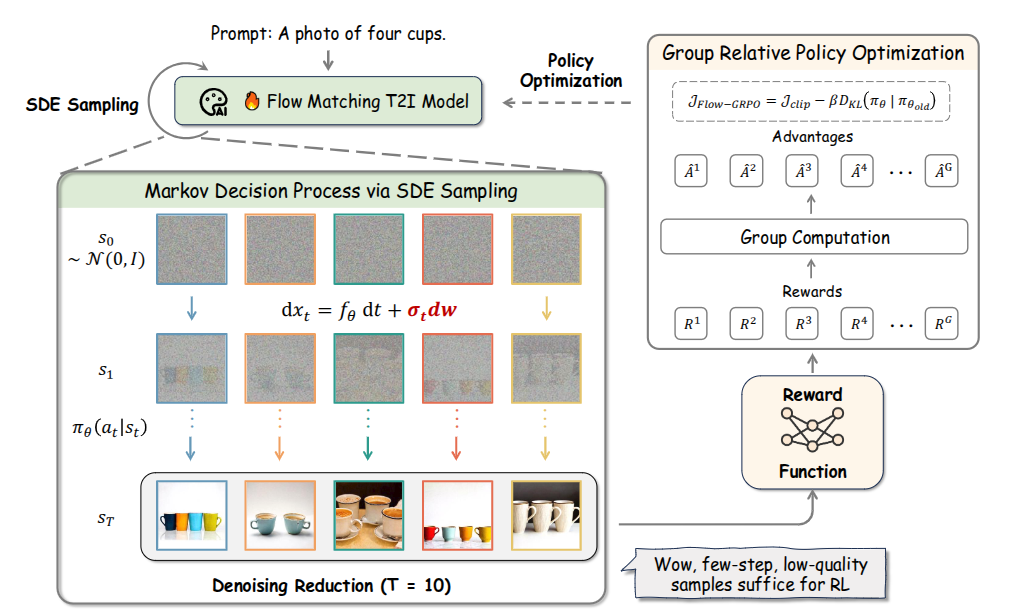
为引入随机转移,将式(7)中的 Flow-ODE 转换为逆时间 SDE。在连续时间及精确速度场与分数函数的条件下,该 SDE 与原 ODE 具有相同的边缘分布
- 其中,
 表示逆时间维纳过程的增量,
 控制生成过程中的随机性强度。以下省略固定文本条件;对标准高斯噪声的 Rectified Flow,式(8)可以具体写为
- 逆时间采样从 1 向 0 积分,令
 。采用 Euler–Maruyama 离散化,漂移乘有符号步长,噪声标准差乘步长绝对值的平方根
- 其中,
 用于引入随机性。本文采用
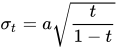 ,其中
 是控制噪声强度的标量超参数,该表达式适用于

- 式(10)表明,策略
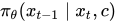 是一个各向同性高斯分布。因此,式(6)中与参考策略
 之间的 KL 散度具有闭式形式。这里两者使用相同的
 ,
 表示相应高斯转移的均值
去噪步数缩减:为生成高质量图像,流模型通常需要较多去噪步骤,这使在线强化学习的数据收集开销较高。然而,作者发现在线强化学习训练期间并不需要使用如此多的时间步。在生成训练样本时,可以显著减少去噪步数,而在推理时保留原始去噪步数,以获得高质量样本。具体而言,在训练时将步数 设为 10,而在推理时采用 SD3.5-M 的原始默认设置,即
 。实验表明,这种方法能够加快训练,同时不损害测试时的图像质量
🧮 Mathematical Derivations for Stochastic Sampling
在漂移中加入与 score 相关的修正项,可以构造与 Flow-ODE 具有相同边缘分布的 SDE,并由其逆时间过程得到随机采样规则
- 固定文本条件
,以下省略该条件。记 为 ODE 的边缘密度,扩散系数 仅依赖时间;在密度为正、系数足够光滑且相应方程解唯一的条件下,比较具有相同初始分布的两个过程
Fokker–Planck 方程将随机动力学转化为边缘密度的演化方程
- 考虑从数据向噪声演化的正向 SDE
- 其 Fokker–Planck 方程与原 ODE 的连续性方程分别为
- 因为
与空间位置无关,且 ,扩散项可以改写为
- 取下述漂移,代入式(13)后,score 对应的概率通量与扩散项恰好抵消
- 因此,在初始分布相同且密度演化方程解唯一时,下述正向 SDE 与原 ODE 在各时刻具有相同的边缘分布
逆时间公式将上述正向 SDE 转换为从噪声到数据的生成过程
- 对漂移为
、扩散系数为 的正向过程,逆时间漂移需减去 。令时间从 1 向 0 递减, 表示逆时间维纳增量,代入式(15)可得
- 这就得到正文式(8);相同边缘分布不要求两种过程具有相同的样本轨迹
高斯插值路径将不可直接计算的 score 表示为流匹配速度场的函数
-
设
与 相互独立, , 、 表示时间导数。这里 为插值系数,与 GRPO 目标中的 KL 权重 区分 -
给定
后,条件密度及其 score 为
- 对条件 score 按后验
求期望,即得边缘 score;这里不能直接用先验均值 替代条件期望
- 流匹配的理想速度场是路径导数的条件期望。利用
,在 的内部时间区间有
- 代入 Rectified Flow 的
、 ,整理得到
将 score 代回逆时间 SDE,即可仅使用速度网络构造随机转移
- 将式(21)代入式(17),得到正文式(9)所用的生成动力学
- 采用速度网络
和 Euler–Maruyama 离散化,令 、 。逆时间维纳增量的协方差为 ,因此漂移使用有符号步长,噪声使用
-
给定当前状态后,式(23)为各向同性高斯转移,其均值由漂移更新确定,协方差为
,因而可直接计算 GRPO 所需的转移密度比以及正文式(11)的 KL 散度 -
上述边缘分布等价性针对精确速度场与连续时间过程;实际采样包含网络近似和时间离散化误差
🌿 DiffusionNFT: Online Diffusion Reinforcement with Forward Process
在线强化学习在大语言模型的后训练中发挥关键作用,推动近年来大语言模型在对齐与推理能力方面的进展。然而,要在视觉生成领域的扩散模型上取得类似成功,并非易事
- 策略梯度算法假设模型的似然能够被精确计算。这一假设对于自回归模型成立,但扩散模型在本质上并不满足这一条件:其似然只能通过计算开销较高的概率常微分方程,或随机微分方程的变分界进行近似估计
- 近期研究通过离散化逆向采样过程,将扩散生成重新表述为多步决策问题,从而绕过这一障碍。这种处理使相邻步骤之间的转移成为易于计算的高斯分布,因而能够将 GRPO 等现有强化学习算法直接应用于扩散模型
尽管这些工作取得有希望的进展,但作者认为,GRPO 风格的扩散强化学习仍然面临以下根本性局限
- 前向不一致性:仅关注逆向采样过程,会破坏模型与前向扩散过程的一致性,使模型面临退化为级联高斯模型的风险
- 求解器限制:数据收集过程依赖一阶 SDE 采样器,无法充分利用 ODE 求解器或高阶求解器,而这些求解器是流模型的默认选择,有利于提高生成效率
- 与 CFG 的集成较为复杂:扩散模型高度依赖无分类器引导,这需要同时训练条件模型与无条件模型。现有强化学习方法通常在后训练中引入 CFG,从而形成复杂且低效的双模型优化方案
的目标是,在扩散强化学习中解耦数据收集过程、消除求解器限制,并保持与标准监督预训练的一致性。由于一个扩散策略对应单一的前向加噪过程,却可以对应多个逆向去噪过程,例如使用不同的采样器,因此,一个自然的问题是:能否在前向过程而非逆向过程中,对扩散模型进行强化学习?
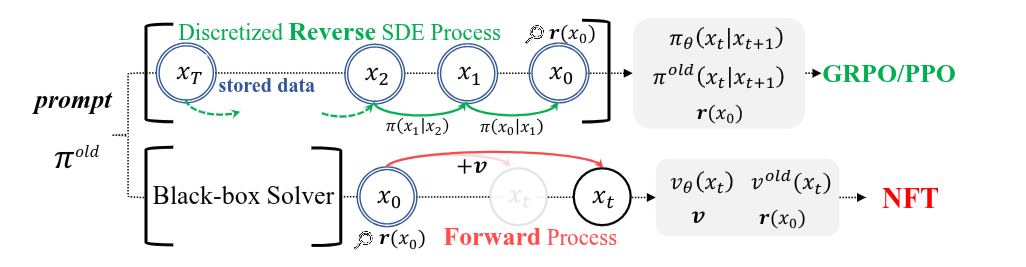
- 本文提出一种新的在线强化学习范式,称为扩散负样本感知微调。DiffusionNFT 不再基于传统的策略梯度框架,而是通过流匹配目标,直接在前向扩散过程中进行策略优化。直观而言,该方法依据奖励信号,将生成样本划分为正样本和负样本,在分别基于这两类样本学习得到的两个隐式策略之间定义对比式改进方向,并在不修改采样过程的情况下,朝正样本策略的方向进行优化
- 这种基于前向过程的强化学习形式化带来多项实际优势。首先,DiffusionNFT 允许使用任意黑盒求解器收集数据,而不再依赖一阶 SDE 采样器。其次,它无需存储完整的采样轨迹,策略优化仅需要无噪图像。再次,它与标准扩散模型训练完全兼容,只需对现有代码库进行少量修改。最后,它是一种原生的离策略算法,无需重要性采样,即可自然地将训练策略与采样策略解耦
DiffusionNFT 为传统策略梯度方法提供一种直接强化学习的替代方案,将负样本感知微调范式引入扩散模型领域。以监督学习为基础,这一范式为构建跨模态的通用、统一且原生支持离策略学习的强化学习方案,提供一条可行路径
📡 Diffusion and Flow Models
扩散模型通过前向过程,使用高斯噪声逐步扰动干净数据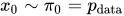 ,从而学习连续数据分布。随后,通过学习逆转这一过程,即可生成数据
- 给定噪声调度
 前向加噪过程具有闭式形式的转移核
 ,因此可以进行如下重参数化

- 学习扩散模型的一种方式,是采用速度参数化,预测轨迹的切向量,并通过最小化以下目标进行训练
- 其中,目标速度
 由噪声调度关于时间的导数定义为
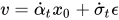 ,记号
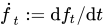 表示对时间求导,
 为某个加权函数
- 逆向采样通常遵循扩散模型的常微分方程形式;采用
 参数化后,该方程简化为
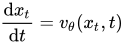 。这一形式化称为流匹配,其中,简单的欧拉离散化即可作为有效的 ODE 求解器,并与 DDIM 等价
- Rectified Flow 可以视为上述扩散模型的一种特例,其噪声调度为
 、
 ,从而将目标速度简化为

面向扩散模型的策略梯度算法:为将 PPO 或 GRPO 等策略梯度算法应用于扩散模型,近期研究将扩散采样形式化为一个多步马尔可夫决策过程。这一点可以通过离散化扩散模型的逆向采样过程来实现
- 尽管流模型天然能够通过 ODE 进行简单、高效的采样,但缺乏随机性阻碍 GRPO 的应用。FlowGRPO 通过采用速度参数化下的随机微分方程形式来解决这一问题
- 其中,
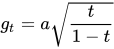 控制所注入随机性的强度。采用欧拉方法对其进行离散化,可得

- 这样,相邻步骤之间的转移核便成为似然可计算的高斯分布,从而能够直接应用 GRPO 等现有策略梯度算法
⛵ Diffusion Reinforcement via Negative-Aware Finetuning
在线强化学习: 考虑预训练扩散策略
- 策略改进要求优化后的
具有更高的期望奖励,即
- 基于正样本数据的策略改进: 当正、负分布均有定义,且奖励在旧策略下具有非零方差时,按期望奖励比较,有
。因此,一种直接方式是令 ,仅在 上微调扩散模型,即拒绝采样微调(RFT)。这种方式简单,但没有利用 中的负样本信息
强化引导: 同时利用正、负样本,可以构造相对于旧策略的改进方向
- 其中,
为旧策略的速度预测器, 称为强化引导, 控制引导强度。下面通过正、负策略与旧策略之间的关系确定这一方向
定理 3.1(改进方向)。 考虑分别对应
- 式(6)给出相对于
的理想改进方向。例如,在式(5)中令 ,便有
- 此时恢复正样本策略
。接下来通过隐式参数化,将正、负两项监督信号用于同一个可训练模型 ,直接学习沿强化引导方向改进的策略
定理 3.2(策略优化)。 考虑以下训练目标
其中,省略共同输入
在数据量和模型容量不受限制的条件下,式(8)的最优解满足
DiffusionNFT 通过监督学习目标利用在线正、负样本进行策略优化。 正、负预测器均由旧模型与同一个在线模型组合得到,训练时固定旧模型,仅更新
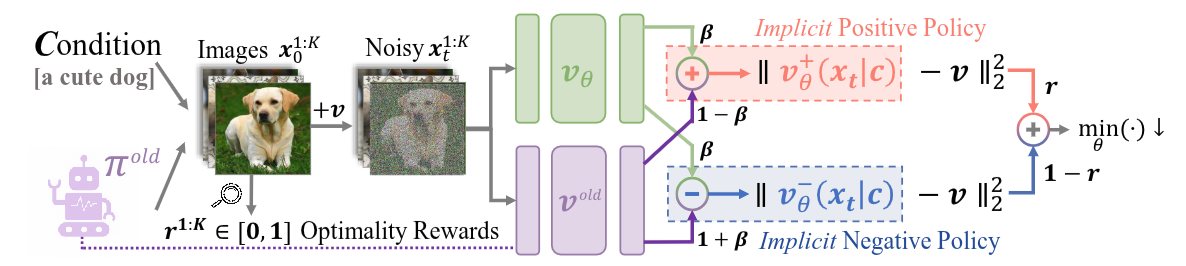
- 前向一致性: 在前向过程中定义标准扩散损失,使
与 通过联合分布 耦合,保留模型与前向扩散过程之间的联系 - 求解器灵活性: 策略训练与数据采样解耦,收集数据时可以使用黑盒求解器;训练仅需干净图像及其奖励,无需保存完整的逆向采样轨迹
- 隐式引导整合: 通过式(9)的参数化,将强化引导直接融入目标策略,无需单独学习引导模型
,也无需在采样时额外组合引导项 - 无需似然的优化: 训练目标由前向回归损失构成,无需利用变分界近似数据似然,也无需从离散逆向轨迹构造序列似然
🛠️ Practical Implementation
每轮先由旧策略生成图像并计算奖励,再对这些图像重新加噪、更新在线模型,最后软更新旧策略,进入下一轮。 其中,奖励归一化决定正、负损失的权重,EMA 控制采样策略的更新速度,自适应加权调整回归损失的尺度
最优性奖励: 将取值不受限制的原始奖励
为归一化因子,例如全局奖励标准差;式中的期望用同一提示下 张图像的平均奖励估计。高于组均值的样本满足 ,正项权重更大;低于组均值的样本满足 ,负项权重更大。训练直接使用 和 加权,无需将样本硬划分为两组
采样策略的软更新: 当前轮次内固定旧模型
- 其中,
为迭代次数。 表示直接将在线模型复制为采样模型; 越接近 1,旧模型保留的比例越高,更新越缓慢。较快更新有利于及时利用策略改进,但可能降低稳定性。更新后清空当前数据缓冲区,下一轮使用新的采样策略重新生成图像
自适应损失加权: 将速度预测器转换为
- 分子是干净样本预测的平方误差,分母是该误差向量各维度的平均绝对值。
表示停止梯度,使分母只参与数值缩放,不通过分母反向传播梯度。该归一化用于调整回归项的尺度,正、负两项之间的比例仍由 与 决定
不使用 CFG 的优化: 无分类器引导(Classifier-Free Guidance,CFG)在采样时组合条件预测与无条件预测,以增强生成结果对提示的响应。记两者为
时使用条件预测; 时,沿条件预测与无条件预测之差进一步增强引导。常规 CFG 在每个采样步需要计算条件、无条件两个分支,即使两者共享网络参数,也会带来额外的网络计算 - 与强化引导的联系: 上式同样具有“基础预测加引导方向”的形式。论文据此将 CFG 理解为一种离线强化引导,其中条件与无条件预测分别提供正、负信号。DiffusionNFT 中的正、负信号则来自奖励划分的生成分布,并通过式(9)的隐式参数化参与训练;这一联系是引导形式上的对应
- 将引导融入策略参数: DiffusionNFT 仅用预训练模型的条件分支初始化旧策略与在线策略。每轮生成样本、计算奖励后,通过正、负回归项更新在线模型,再以 EMA 更新采样策略。在定理 3.2 的理想条件下,优化目标推动模型沿
改进,因此采样时直接使用训练后的条件模型,无需额外计算无条件分支或显式组合 CFG - 实验表现: 论文中,无 CFG 的初始策略性能较弱,但经过在线强化学习后迅速提升,并超过使用 CFG 的基线。这支持通过后训练学习或替代 CFG 所承担的引导作用;这一结论对应论文测试的模型、奖励与生成任务
下述算法汇总数据收集、策略优化与软更新的循环。梯度步骤采用式(8)的基础回归目标;使用自适应加权时,将正、负预测器各自的回归项替换为式(13)对应的形式。采样和策略初始化均使用条件模型
📐 Proof Of Theorems
以下按原论文附录 A的顺序列出两个引理及定理 3.1、3.2 的证明。
Lemma A.1(Distribution Split)。 正、负分布分别为
旧策略可以写成这两个分布的线性组合
- 证明: 由式(A.1)直接代入式(A.2)右侧,得到
Lemma A.2(Posterior Split)。 三个分布对应的扩散后验满足
- 证明: 根据 Bayes 公式,有
- 将式(A.2)中的三个分布都用这一形式替换,得到
- 对式(A.2)两侧施加相同的前向扰动,得到受噪边缘分布之间的关系,进而得到两个系数之和为 1
- 又因为
,式(A.6)的两个系数分别为 和 ,因此
Theorem A.3(Improvement Direction,即定理 3.1)。 对应
- 证明: 根据最优速度预测器与
后验均值的关系,三个速度场分别写为
- 由引理 A.2,将旧策略的后验均值分解为正、负后验均值的加权和,得到
- 移项后,
, 。两式分别乘以 和 ,即得式(A.9),定理得证。这里的后验混合系数 与噪声调度 不同
Theorem A.4(Reinforcement Guidance Optimization,即定理 3.2)。 对训练目标及隐式正、负策略
在数据量和模型容量不受限制时,其最优解为式(10)中的强化引导策略
- 证明: 先将期望按
的边缘分布和 的条件后验分解
- 由引理 A.1,
。结合 Bayes 公式,正项中的奖励权重可以吸收到后验分布中
- 同理,负项满足
- 将式(A.14)、(A.15)代回损失,随后将随机目标替换为各自的条件均值,得到原论文中的三步等式
- 第二个等号使用
, 为与 无关的条件方差项。结合定理 A.3,正、负预测误差分别写为
- 上式及以下配方先考虑
,并按原论文省略 、 与 共同的输入 。将两项误差代回 ,提取 ,再把两个加权平方项合并
- 第三个等号使用以下加权平方恒等式,将与
无关的部分并入
因此,最优解满足
当