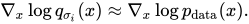Generative Models I
🐱 Auto-Encoding Variational Bayes
对于具有连续潜变量或模型参数后验分布不可解析的有向概率模型,如何实现高效的近似推断与参数学习,一直是概率建模领域的重要研究问题。针对这一问题,作者提出一种随机变分推断与学习算法。该方法不仅能够有效适用于大规模数据场景,而且在满足若干温和可微条件的前提下,即使面对后验不可解析的情形,仍然具有良好的适用性
- 变分贝叶斯(Variational Bayesian, VB)方法通常通过优化一个对真实后验的近似分布来处理该问题。然而,传统的 mean-field 变分方法往往要求能够解析地计算关于近似后验的若干期望,而在一般情形下,这些期望本身同样是不可解析的,从而限制该类方法在复杂模型中的适用性
- 通过对变分下界进行重参数化,可以得到一个简单、可微且无偏的下界估计器。该估计器被称为 SGVB(Stochastic Gradient Variational Bayes)估计器。SGVB 适用于几乎所有包含连续潜变量和/或参数的模型,能够有效实现近似后验推断,并且可以直接借助标准的随机梯度上升方法进行优化
- 针对由独立同分布样本构成、且每个样本均对应连续潜变量的情形,作者提出 Auto-Encoding Variational Bayes(AEVB)算法。在该算法中,利用 SGVB 估计器对一个识别模型进行优化,从而使推断与学习过程变得尤为高效。具体而言,该识别模型能够通过简单的祖先采样高效地完成近似后验推断,并进一步促进模型参数的有效学习,而无需针对每一个数据点都采用诸如 MCMC 等代价高昂的迭代式推断过程
- 学习得到的近似后验推断模型不仅可用于模型训练本身,还能够服务于多种下游任务,例如识别、去噪、表示学习以及可视化等。当识别模型由神经网络参数化时,便得到论文所称的变分自编码器(Variational Auto-Encoder, VAE)
论文的贡献主要体现在两个方面
- 证明对变分下界进行适当的重参数化后,可以构造一个易于处理的下界估计器,并能够借助标准的随机梯度优化方法对其进行直接优化
- 对于由独立同分布样本构成、且每个数据点均对应连续潜变量的数据集,论文表明可以通过拟合一个针对不可解析真实后验的近似推断模型(识别模型),显著提升后验推断的效率;该模型的学习同样依赖于 SGVB
🐮 Problem scenario
本节所提出的策略可用于为多种含有连续潜变量的有向图模型构造下界估计器,即一种随机目标函数
- 讨论范围限定于一种常见情形:给定一个由独立同分布样本构成的数据集,且每个数据点对应其自身的潜变量;在这一设定下,希望对全局参数进行最大似然估计或最大后验估计,同时对潜变量执行变分推断
- 所考虑的有向图模型中,实线表示生成模型
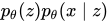 ,虚线表示对不可解析后验分布
 的变分近似
 。其中,变分参数
 与生成模型参数
 在训练过程中进行联合学习
1️⃣ 设有数据集 ,其中包含
 个关于某一连续或离散变量
 的独立同分布样本。假设这些数据由某一随机过程生成,而该过程涉及一个未被观测到的连续随机变量
 。具体而言,这一生成过程可分为两个步骤
- 其一,从先验分布
 中生成一个取值

- 其二,再由条件分布
 生成一个观测值

进一步假设,先验分布与似然分布分别来源于参数化分布族 与
 ,并且它们的概率密度函数关于参数
 以及潜变量
 几乎处处可微。但是生成过程中的大量关键信息是不可见的:真实参数
 以及各潜变量的具体取值都是未知的
2️⃣ 论文并未对边缘分布或后验分布作出常见的简化性假设。相反,关注一种更一般性的算法框架,即使在如下情形下也能够保持高效性
- 不可解析性。当边缘似然
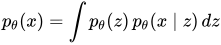 对应的积分不可解析时,既无法直接计算边缘似然,也无法对其求导;同时,真实后验密度
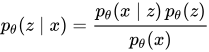 同样不可解析,从而传统的 EM 算法也无法使用;进一步地,即便采用任意合理的 mean-field 变分贝叶斯方法,其所需的积分在一般情况下也可能仍然不可解析
- 大规模数据集。即数据量极其庞大,以至于批量优化的代价过高;因此,希望能够仅利用较小的 mini-batch,甚至单个样本,就完成参数更新。基于采样的方法,例如 Monte Carlo EM,在这种情况下通常过于缓慢,因为它往往要求对每个数据点都执行一次代价不菲的采样循环
3️⃣ 在上述设定下,论文关注并试图解决以下三个相互关联的问题
- 如何对参数进行高效的近似最大似然估计(ML)或最大后验估计(MAP)
- 如何在给定参数的情况下,对观测值
 所对应的潜变量进行高效的近似后验推断
- 如何对变量的边缘分布进行高效的近似推断,从而支持各类需要的先验分布作为支撑的推断任务
4️⃣ 为解决上述问题,作者进一步引入一个识别模型 将其作为对不可解析真实后验
 的近似。与 mean-field 变分推断中的近似后验不同,这里的
 并不要求具有因子化结构,其参数也并非通过某种闭式期望计算获得。相反,论文提出一种方法用以将识别模型参数与生成模型参数进行联合学习
- 从编码理论的视角来看,未观测变量可以被解释为一种潜在表示或潜在编码。也将识别模型称为概率编码器:给定一个数据点,它输出一个关于潜在编码可能取值的概率分布(例如高斯分布),这些潜在编码都可能是生成该数据点的潜在原因
- 将称为概率解码器,因为在给定某个潜在编码的条件下,它给出对应的观测变量的可能取值分布
🦨 The Variational Bound
对数边缘似然可以分解为各个数据点边缘似然对数的求和,即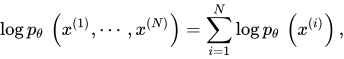 而对于每一个数据点,其对数边缘似然又可进一步改写为
 (1)
式中,右侧第一项表示近似后验分布 相对于真实后验分布
 的 Kullback–Leibler 散度。由于该 KL 散度恒为非负,因此右侧第二项
 被称为第
 个数据点对数边缘似然的变分下界。其具体形式可写为
 (2)
 (3)
该变分下界还可以等价地表示为
 (4)
目标是对变分下界分别关于变分参数与生成模型参数求导并进行优化。然而,相较于关于的优化,关于的梯度计算则稍显棘手。对于此类问题,通常使用的朴素 Monte Carlo 梯度估计器为
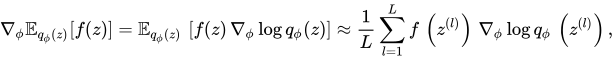 (5)
其中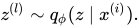 然而,这种梯度估计器通常具有较高的方差,因此在论文关注的问题设定下并不实用
🐻 The SGVB Estimator and AEVB Algorithm
在若干温和条件下,对于选定的近似后验,可以借助辅助噪声变量 及其可微变换
 对随机变量
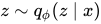 进行重参数化,即写为
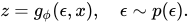 (6)
基于上述重参数化形式,可以对关于的某一函数 的期望构造如下 Monte Carlo 估计
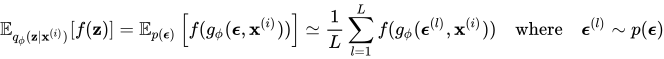 (7)
将这一技术应用于变分下界,从而得到一般形式的随机梯度变分贝叶斯(SGVB)估计器 其表达式为
 (8)
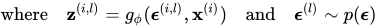
在许多情况下,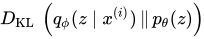 可以被解析积分求得,仅需对期望重构项
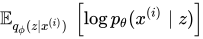 进行采样估计。此时,KL 散度项可以被解释为对参数的一种正则化,它鼓励近似后验分布靠近先验分布。基于此,可得到 SGVB 估计器的第二种形式
 ,并且通常相比一般形式的估计器具有更低的方差
 (9)
对于包含个样本的数据集 还可以基于 mini-batch 构造整个数据集边缘似然下界的估计器,即
 (10)
其中 是从包含个样本的完整数据集
 中随机抽取的
 个样本。在本文实验中,作者发现当 mini-batch 的规模足够大时,例如
 ,每个数据点只取一个采样点,即令
 ,通常便已足够。此时,可以进一步对
 关于和求梯度,并将所得梯度与 SGD、Adagrad 等随机优化方法结合使用
从 目标函数形式可以更加清晰地看出它与自编码器之间的联系。第一项,即近似后验相对于先验分布的 KL 散度,可被视为一种正则项;第二项则可以理解为期望意义下的负重构误差。函数
 被设计为将数据点与随机噪声向量
 映射为该数据点近似后验分布中的一个样本,即
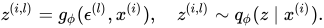 (11)
随后,该样本 被输入到函数
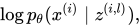 该项表示在给定潜变量样本的条件下,观测数据点在生成模型下的对数概率密度(或对数概率质量)。按照自编码器的术语,它可以被视为一种负重构误差
🫎 The Reparameterization Trick
1️⃣ 为解决上述问题,采用一种从中生成样本的替代方法。其核心的重参数化技巧实际上相当直接。设为一个连续随机变量,并且满足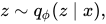 其中为某一条件分布。在许多情况下,可以将随机变量通过确定性变换表示为
 其中是一个辅助随机变量,服从与模型参数无关的边缘分布
 而则是一个由参数控制的向量值函数。这种重参数化能够将关于的期望改写为另一种形式,使得对应的 Monte Carlo 估计关于是可微的
2️⃣ 给定确定性映射 ,在该映射可微且可逆时,变量替换满足
 因此有
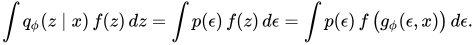 (12)
由此可知,可以构造如下可微估计器
 (13)
3️⃣ 重参数化公式本质上是一个对期望项进行可微 Monte Carlo 估计的通用工具,其具体作用取决于被积函数的选取
- 当
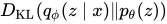 无解析解时,可令
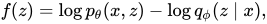 从而对整个 ELBO 进行采样估计,得到一般形式的 SGVB 目标

- 当散度具有闭式解,通常将其单独解析计算,对重构对数似然项进行采样估计,令
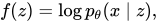 从而得到方差更低的目标形式

4️⃣ 以一维高斯分布为例。设 在这种情况下,一个有效的重参数化方式为
 其中是辅助噪声变量,并满足
 因此
 (14)
5️⃣ 对于近似后验分布,可根据其分布特性选择相应的重参数化方式;常见策略主要包括逆累积分布函数法、位置—尺度族构造法以及复合变换法
- 逆累积分布函数可将均匀辅助变量转换为目标分布样本。在这种情形下,可令
 并将定义为的逆累积分布函数。适用于该方法的分布包括指数分布、柯西分布、Logistic 分布、Rayleigh 分布、Pareto 分布、Weibull 分布、Reciprocal 分布、Gompertz 分布、Gumbel 分布以及 Erlang 分布等
- 位置—尺度族通过对标准分布样本平移与缩放完成重参数化。与高斯分布的例子类似,对于任意位置—尺度族分布,都可以将其标准形式(即位置参数为 0、尺度参数为 1 的分布)选作辅助变量,并令
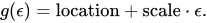 属于这一类的分布包括 Laplace 分布、椭圆分布、Logistic 分布、均匀分布、三角分布以及高斯分布等
- 复合变换通过组合简单随机变量构造更复杂的分布。在许多情况下,随机变量可以表示为辅助变量经过一系列不同变换后的结果。例如:对数正态分布可以看作正态变量的指数变换;当形状参数为正整数时,Gamma 分布可由相同速率的独立指数变量求和得到;将相同速率的独立 Gamma 变量分别除以它们的总和,可得到 Dirichlet 随机向量;此外,Beta 分布、卡方分布以及 F 分布等也都可以通过类似方式构造
🕊️ Example: Variational Auto-Encoder
采用神经网络来构造概率编码器即生成模型 后验分布的近似模型,并利用 AEVB 算法对参数与进行联合优化
1️⃣ 设潜变量的先验分布为中心化的各向同性多元高斯分布 需要注意的是,在这一设定下,先验分布本身不含可学习参数。对于条件分布
 作者假定当数据为实值型时,其服从多元高斯分布;当数据为二值型时,其服从 Bernoulli 分布。对应分布的参数由通过一个多层感知机计算得到
2️⃣ 在这种设定下,真实后验分布是不可解析的。尽管近似后验的形式具有较大的选择自由,作者在此假设真实但不可解析的后验分布可以由一个协方差近似对角化的高斯分布较好近似。在这一情形下,变分近似后验可设为具有对角协方差结构的多元高斯分布 其中,近似后验分布的均值
 与标准差
 由编码端 MLP 输出,即它们是数据点以及变分参数的非线性函数
3️⃣ 通过重参数化方式从后验分布中采样,即令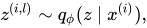 并写成
 在该模型中,先验分布和近似后验分布均为高斯分布,因此可以采用 SGVB 估计器。此时,KL 散度项可以直接解析计算并求导,而无需再通过采样进行估计。解码项
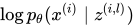 具体由 Bernoulli 型或 Gaussian 型的 MLP 给出,其形式取决于所建模数据的类型
 (15)
🦨 Nonequilibrium Thermodynamics
机器学习中的一个核心问题,是如何利用高度灵活的概率分布族对复杂数据集进行建模,同时仍使模型的学习、采样、推断与概率评估在解析上或计算上保持可处理性。从历史上看,概率模型长期面临灵活性与可处理性之间的权衡
- 易于解析求值和拟合的模型通常难以充分刻画复杂数据中的丰富结构
- 高度灵活的模型虽然能够适应任意复杂模式,却往往需要通过任意非负函数
 定义分布
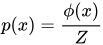 ,其中归一化常数
 通常难以计算,从而使概率评估、训练与采样严重依赖代价高昂的蒙特卡洛方法
针对这一问题,论文提出一种兼顾模型灵活性与计算可处理性的生成建模方法
- 核心思想来源于非平衡统计物理:首先通过迭代的前向扩散过程,有系统地、渐进地破坏数据分布中的结构;随后学习相应的反向扩散过程,以逐步恢复数据中的结构,从而构建出一种既具有高度表达能力、又具有良好可处理性的生成模型
- 该方法能够在具有数千层或数千个时间步的深层生成模型中高效完成模型学习、样本生成与概率评估,并进一步支持条件概率与后验概率的计算
该方法建立在马尔可夫链框架之上,其核心思想源于非平衡统计物理与序列蒙特卡洛,即通过逐步的分布变换过程,实现从简单先验分布到复杂目标数据分布的生成建模
- 构造一个生成性的马尔可夫链,通过扩散过程,将一个简单且已知的分布(例如高斯分布)逐步变换为目标的数据分布
- 不同于将该马尔可夫链仅作为近似计算某个既定模型的工具,而是直接将马尔可夫链的终点分布定义为模型本身。由于扩散链中的每一步转移概率都可以被解析计算,因此整条轨迹的联合概率同样能够被解析评估
- 学习过程可以被理解为:对扩散过程中的微小扰动进行估计。与其用单一的、不可解析归一化的势函数去直接描述完整分布,不如估计这些小的局部变化,这在计算上更加可行
- 由于对于任意平滑的目标分布都可以构造相应的扩散过程,因此该方法理论上能够刻画任意形式的数据分布
🐐 Relationship to Other Work
Wake-sleep 算法首次提出这样一种思想:让推断模型与生成概率模型相互对抗、共同训练。Kingma 与 Welling(2013)等工作发展变分学习与推断算法,使得灵活的生成模型与潜变量后验分布能够直接相互配合并联合训练。上述工作中的变分下界与本文训练目标中采用的目标函数的形式是相似的,但是本文的研究动机与模型形式均与这些方法不同。相较于这些变分推断技术,论文方法具有以下差异与优势
- 该方法从非平衡热力学、准静态过程与退火思想构建生成模型。方法建立在物理学、准静态过程以及退火重要性采样等思想基础之上,而不是建立在变分贝叶斯框架之上
- 学习到的分布可与其他概率分布结合以进行后验推断。展示如何将学习到的分布与另一个概率分布方便地相乘,例如与条件分布结合以计算后验分布
- 限制前向过程的函数形式,可简化推断模型的训练。在变分推断方法中,由于目标函数在推断模型与生成模型之间具有不对称性,推断模型的训练往往尤为困难。本文将前向过程(即推断过程)限制为一种简单的函数形式,从而使得反向过程(即生成过程)能够具有相同的函数形式
- 逐步扩散与反向生成支持包含数千层或数千个时间步的模型
- 熵产生的上下界为各层或各时间步提供热力学刻画
退火重要性采样与扩散方程为生成过程提供物理学联系
- 与本文密切相关的思想包括 Jarzynski 等式,其在机器学习中被称为退火重要性采样(Annealed Importance Sampling, AIS)。AIS 利用一个马尔可夫链,缓慢地将一个分布转化为另一个分布,以计算两个分布归一化常数之比。Burda 等进一步指出,AIS 不仅可以沿前向轨迹实施,也可以沿反向轨迹进行
- Langevin 动力学作为 Fokker–Planck 方程的随机实现,说明如何构造一个高斯扩散过程,使任意目标分布成为其平衡分布
- Kolmogorov 前向方程与后向方程从不同角度描述同一个扩散过程。前向方程即 Fokker–Planck 方程,描述概率密度的演化;后向方程描述给定起点时条件期望的演化。扩散过程的时间反演则由逆时间 SDE 描述,其漂移项需要边缘概率密度对状态变量的对数梯度(score)
🐿️ Algorithm
1️⃣ 前向轨迹(Forward Trajectory):将数据分布记为 。通过反复施加关于分布
 的马尔可夫扩散核
 ,可将数据分布逐步转化为一个良态的(即可解析处理的)分布,其中
 表示扩散速率。于是有
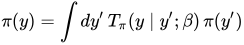 (1)
- 以下高斯情形沿用论文的数据标准化设定:输入数据已中心化且各坐标方差为 1,不要求白化。后文的熵上界及交叉熵常数化简均在此设定下使用。定义前向扩散过程的单步转移为
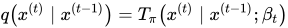 (2)
- 因此,从数据分布出发并执行
 步扩散所得到的前向轨迹可表示为
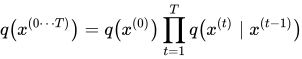 (3)
2️⃣ 反向轨迹(Reverse Trajectory):生成模型分布将被训练为描述与前向轨迹相同、但方向相反的过程,即
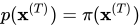 (4)
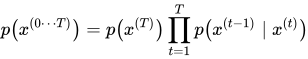 (5)
- 对于高斯扩散与二项扩散,在连续扩散情形下(即步长
 足够小时),扩散过程的反演在函数形式上与前向过程保持一致。也就是说,由于
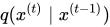 是高斯分布或二项分布,当足够小时,
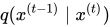 也可分别近似为高斯分布或二项分布
- 并且,轨迹越长,扩散速率就可以设定得越小。在学习过程中,仅需要估计以下参数:对于高斯扩散核,需要估计其均值与协方差;对于二项扩散核,则只需估计其比特翻转概率
3️⃣ 模型概率(Model Probability):生成模型赋予数据的概率可表示为
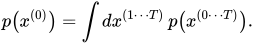 (6)
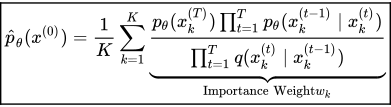
- 若直接计算该积分,通常是不可处理的。为此论文借鉴退火重要性采样以及 Jarzynski 等式的思想,不直接求解这一积分,而是转而考察前向轨迹与反向轨迹的相对概率,并对前向轨迹进行平均。于是有
 (7)
- 这一表达式可以通过对前向轨迹分布
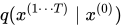 进行采样并取平均,从而高效地估计。当扩散步长趋于无穷小时,前向轨迹分布与反向轨迹分布可以被构造得彼此一致。如果两者完全相同,那么只需要从中抽取一个样本,就能够精确计算上述积分。该情形对应于统计物理中的准静态过程
 (8)
4️⃣ 训练(Training):模型训练的目标是最大化模型的对数似然
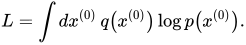 (9)
 (10)
- 根据 Jensen 不等式,上式可得到如下下界
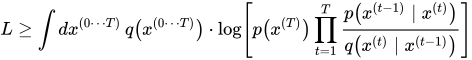 (11)
- 对于论文所采用的扩散轨迹,该下界可以进一步化简为
 , 熵项与 KL 散度项都可以解析计算。该下界的推导方式,与变分贝叶斯方法中对数似然下界的推导是平行的
 (12)
- 训练过程可以表述为:寻找一组反向马尔可夫转移,使得该对数似然下界最大。对复杂概率分布的估计问题,被转化为对一组函数的回归问题:在高斯扩散情形下,需要学习确定一系列高斯分布均值与协方差的函数;在 Bernoulli 试验情形下,则需要学习确定状态翻转概率的函数
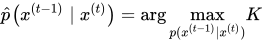 (13)
5️⃣ 扩散速率的设定:在前向轨迹中,扩散速率的选取对训练模型的性能具有重要影响。在 AIS 中,中间分布调度方式的选择会显著影响对对数配分函数的估计精度;在热力学中,从一个平衡分布过渡到另一个平衡分布所采用的调度方式,则决定自由能损失的大小
- 对于高斯扩散,通过对
 进行梯度上升来学习前向扩散调度
 。其中,第一步的方差
 被固定为一个较小常数,以避免过拟合。为显式表示
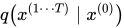 对
 的依赖关系,作者采用冻结噪声技巧,将噪声视为额外的辅助变量,并在计算对参数的偏导数时保持该噪声固定
- 对于二项扩散,由于离散状态空间的存在,无法像连续情形那样利用冻结噪声进行梯度上升。令前向扩散调度满足在每一步扩散中都擦除原始信号的一个固定比例
 ,从而得到扩散速率
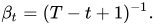
6️⃣ 反向过程的熵(Entropy of Reverse Process):由于前向过程是已知的,因此可以对反向轨迹中每一步的熵给出上界与下界。这些熵界可以进一步用于约束所学习得到的反向转移分布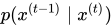 。具体而言,反向轨迹中某一步条件熵满足如下不等式
 (14)
🦄 Log Likelihood Lower Bound
1️⃣ 作者首先将模型的训练目标表示为关于整条前向轨迹分布 的期望形式,并在此基础上推导一个可优化的对数似然下界
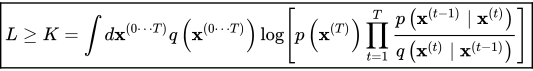 (15)
2️⃣ 的熵项。首先,可以将的贡献单独拆分出来,并将其改写为一个熵项
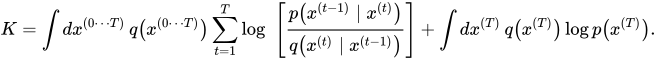 (16)
- 又由于在本文构造的扩散核下,分布
 相对于
 的交叉熵在所有时间步上都保持为常数,并且该常数恰好等于
 的熵,因此有
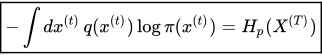 (17)
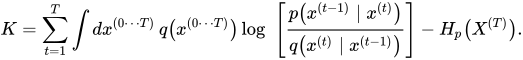 (18)
3️⃣ 消除 处的边界效应,作者将反向轨迹的最后一步直接设定为与对应的前向扩散步骤相同,即
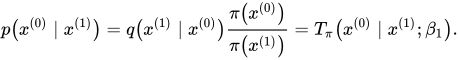 (19)
- 在这一设定下,和式中第一步
 的贡献可以被消去,从而得到
 (20)
4️⃣ 改写为关于后验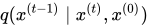 的形式。由于前向轨迹是一个马尔可夫过程,因此上式可以改写为
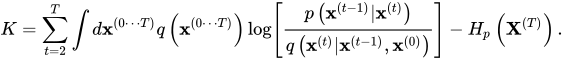 (21)
- 进一步利用 Bayes 定理,可将其改写为关于前向轨迹后验与边缘分布的形式
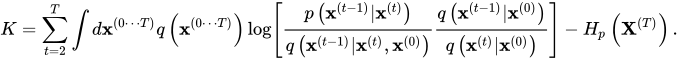 (22)
5️⃣ 改写为 KL 散度与熵项。由条件熵项的望远镜求和,可进一步化简为
 (23)
- 最后将对数概率比改写为 KL 散度,即得到正文中的最终形式
 (24)
🦨 Noise Conditional Score Network
背景:生成建模是机器学习中的基础问题,广泛应用于图像生成、语音与音乐合成、半监督学习、异常检测、模仿学习以及强化学习等任务
- 生成模型的主流研究主要由两类方法推动:一类是基于似然的方法,通过最大化对数似然或其代理目标来逼近真实数据分布;另一类是生成对抗网络,通过对抗训练缩小模型分布与真实分布之间的差异
- 基于似然的方法往往依赖可归一化的特殊结构,或者需要借助 ELBO、对比散度等替代目标进行训练
- GAN 虽然在样本质量上表现突出,但训练过程不稳定,同时其目标函数本身也不适合用作严格、统一的模型比较标准。因此,如何寻找一种既不依赖对抗训练、又不受显式似然结构强约束的新型生成建模方式,成为一个重要问题
动机:基于上述背景,提出一个不同于传统似然建模与 GAN 的思路,不直接学习数据分布本身,而是学习数据对数密度的梯度,即 score 向量场
- 其基本设想是,若能够准确估计数据分布在各点处朝向高密度区域的方向,便可以利用这一方向场,通过 Langevin dynamics 将随机初始化的样本逐步推向真实数据分布,从而完成生成。但这一思路在高维真实数据上面临两个核心障碍
- 第一,在流形假设下,真实数据通常集中在低维流形附近,这使得环境空间中的 score 可能不再良定义,从而导致直接的 score matching 难以得到稳定、合理的估计
- 第二,在远离数据流形的低密度区域,由于训练样本稀疏,score 难以被准确学习,而采样过程恰恰常常需要从这些低密度区域出发,因此会进一步导致 Langevin dynamics 混合缓慢、跨模态(modes) 能力不足
方法:为解决上述困难,作者提出一种基于多噪声尺度 score 学习与退火式 Langevin dynamics 的生成框架
- 其核心做法是:不直接对原始数据分布学习 score,而是先对数据施加不同强度的高斯噪声扰动,使扰动后的分布具有更好的支撑性质,并在低密度区域提供更充分的训练信号。随后,训练一个噪声条件化的 score 网络,联合学习不同噪声级别下数据分布对应的 score 向量场
- 添加随机噪声可以确保生成的分布不会塌陷到低维流形上,大噪声水平会在原始数据的低密度区域产生样本,从而改善评分估计
- 在采样阶段,进一步提出退火式 Langevin dynamics。具体而言,生成过程不再只依赖单一噪声水平下的 score,而是从较大噪声级别开始进行采样,使样本先在平滑、易探索的分布上移动;再逐步降低噪声水平,使采样轨迹逐渐从粗糙的分布逼近到原始数据分布,最终贴近真实数据流形
- 主要优点:其训练目标具有良好的可处理性与通用性,几乎适用于任意参数化的 score 网络,而不依赖特殊结构设计或额外约束;同时,训练过程中无需对抗训练、无需训练期 MCMC 采样,也无需其他近似技巧,因而实现更为直接、稳定且易于优化。除此之外,该目标还能够作为统一的定量评价标准,用于在同一数据集上比较不同模型的性能
🦉 Score-Based Generative Modeling
设数据集由来自未知真实数据分布 的独立同分布样本
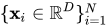 构成。将概率密度
 的 score 定义为
 。所谓 score network,即
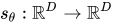 是一个由参数
 表示的神经网络,其目标是逼近真实数据分布的 score
生成建模的目标在于:利用给定数据集学习一个能够从中生成新样本的模型。基于 score 的生成建模框架主要由两个核心组成部分构成:score matching 与 Langevin dynamics
🪙 借助 score matching,不必先显式学习数据分布,而是直接训练一个 score network  去估计
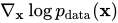
- 本文直接参数化 score network,而不将能量模型的梯度作为 score network,以避免高阶梯度的额外计算开销,并最小化以下目标
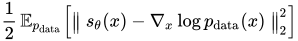 (1)
- 忽略与参数无关的常数项后,该目标等价于
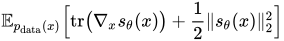 (2)其中,
 表示
 关于输入
 的 Jacobian 矩阵。在一定正则条件下,最优解满足
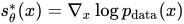 。训练不需要显式的
 ,只需要能对
 做自动微分
🪙 Denoising score matching 是 score matching 的一种变体,它能够完全避免计算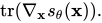
- 利用给定的噪声分布
 对数据点进行扰动,扰动后的数据分布为
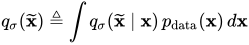 (3)对该分布应用 score matching,以估计其 score,等价的目标函数为
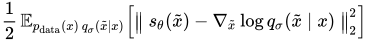 (4)
- 该目标的最优解为
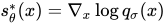 。然而,
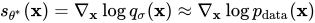 这一近似仅在噪声足够小时才成立,即只有当
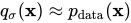 时,扰动分布的 score 才能够近似原始数据分布的 score
🪙 Sliced score matching 利用随机投影近似 Jacobian 迹项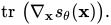 训练目标为
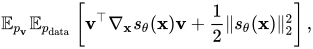 (5)
- 其中,
 表示随机向量
 的简单分布,例如多元标准高斯分布。Jacobian 迹项被替换为随机方向上的二次型
 ,可借助前向模式自动微分高效计算。与 denoising score matching 估计扰动后数据分布的 score 不同,sliced score matching 直接针对原始未扰动数据分布进行 score 估计;但由于其依赖前向模式自动微分,因此计算开销更高,约为前者的四倍
🪙 Langevin dynamics 能够仅依赖概率密度的 score 函数来生成样本。给定固定步长 ,以及一个来自先验分布
 的初始值
 ,Langevin 方法按如下递推式进行更新
 (6)
- 收敛性与校正:在遍历性等正则条件下,当
 且
 ,并保证链充分混合时,
 的分布趋于
 ;若
 且
 ,Metropolis–Hastings 校正可消除固定步长带来的平稳分布偏差,但有限步仍可能存在混合误差;实践中常在小步长、大步数时省略该校正
- 为从真实数据分布中生成样本,只需先训练一个 score network,使其满足
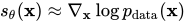 ,再用近似替代真实 score,配合 Langevin dynamics 进行采样即可
🦥 Challenges Of Score-Based Generative Modeling
数据分布的 score 是在环境空间中对对数密度求梯度,但如果数据只支撑在低维流形上,那么这个梯度在环境空间里往往不再良定义。原始的 score matching 目标只有在数据分布支撑覆盖整个空间时才能给出一致的 score 估计,而当数据分布仅位于低维流形上时,估计会变得不一致
低密度区域中的数据稀缺,会同时破坏 score 估计与 Langevin dynamics 采样,因此即使 score-based generative modeling 在高密度区域内表现良好,也难以直接在全局上恢复真实数据分布
- 在 score matching 的训练中,期望是由有限样本近似的;当某一区域的数据概率极低时,训练样本几乎不会覆盖这些位置,于是网络缺乏足够监督信号去准确学习该区域的 score,导致 score 估计只在数据模态附近较为可靠,而在低密度区域明显失真
- Langevin dynamics 的采样依赖 score 引导样本在空间中移动;当不同数据模态之间被低密度区域隔开时,采样过程虽然理论上仍可能收敛到目标分布,但实际往往需要极小步长和大量迭代才能完成有效混合,否则就难以正确恢复不同模态之间的相对权重,甚至无法在可接受时间内逼近真实分布
- 即使使用真实 score,普通 Langevin dynamics 在多模态分布上的采样仍可能无法正确恢复各模态的相对权重,而 annealed Langevin dynamics 能显著改善这一问题
🪺 Noise Conditional Score Networks: Learning And Inference
对数据加入高斯噪声可以同时缓解困难
- 一方面,噪声使扰动分布获得全空间支撑,从而绕开低维流形导致的 score 不适定问题;另一方面,较大的噪声会填补原始分布中的低密度区域,为 score matching 提供更充分的训练信号
- 进一步地,若使用多个噪声层级,就能够得到一串从平滑分布逐步过渡到真实数据分布的中间分布,这不仅有助于学习不同噪声水平下的 score,也能够在采样阶段通过从大噪声到小噪声的退火式 Langevin dynamics 改善多模态分布上的混合能力
通过以下两个方面改进基于 score 的生成建模
- 其一,利用不同强度的噪声对数据进行扰动;其二,通过训练一个单一的条件 score 网络,同时估计所有噪声水平对应的 score
- 训练完成后,在利用 Langevin dynamics 生成样本时,首先采用对应于较大噪声水平的 score,并随着采样推进逐步降低噪声水平。这样可以将大噪声层级所带来的全局探索优势,平滑地传递到低噪声层级,而在低噪声层级下,扰动数据已经与原始数据几乎难以区分
1️⃣ 噪声条件 score network 怎么定义
- 取按几何级数递减的正噪声标准差
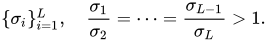 对每个噪声水平
 ,扰动数据分布定义为
 (7)最大噪声
 要足够大,以缓解流形假设和低密度区域问题;最小噪声
 要足够小,以保证扰动分布仍然尽可能接近原始数据分布
- 在此基础上,作者提出训练一个条件 score 网络
 ,使其在每个噪声水平下都满足
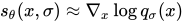 ,网络学习的不是单一分布的 score,而是所有扰动分布的 score 的统一近似。因为网络以噪声水平
 作为条件输入,所以作者将其称为 Noise Conditional Score Network
- 由于该网络的输出与输入图像同形状,本质上属于密集预测问题,因此在图像任务中采用 U-Net、空洞卷积、instance normalization 以及条件归一化等结构设计,以提升多尺度 score 估计的能力
2️⃣ 把 NCSN 的训练正式写成多噪声层级下的去噪 score matching 联合优化问题,并通过 实现不同噪声水平之间的平衡训练
- 首先,作者指出 sliced score matching 和 denoising score matching 都可以训练 NCSN,但最终选择 DSM,因为其计算更快,且适合学习扰动数据分布的 score。具体而言,采用高斯扰动分布
 其条件 score 为
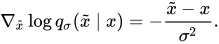 (8)据此,对固定噪声水平,得到对应的 DSM 训练目标
 (9)
- 其次,将各噪声层级的 DSM 损失加权平均,得到联合训练目标
 (10)用一个共享参数的条件网络,同时学习所有噪声水平下扰动分布的 score。在网络容量足够的条件下,整体目标最优当且仅当网络在每个
 上都满足
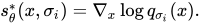 为平衡不同噪声层级的损失量级,选取权重
 这样可以使不同噪声水平上的加权损失保持相近量级,从而改善联合训练的稳定性与均衡性
3️⃣ NCSN 在训练完成后如何进行采样生成,其核心方法是 annealed Langevin dynamics
- 具体而言,给定训练好的条件 score 网络
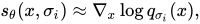 采样从先验
 出发,在每个噪声层级上执行 Langevin 更新
 (11)其中,步长取
 大噪声阶段在平滑分布上进行全局探索与跨模态混合,小噪声阶段逐步细化样本,使其接近真实数据分布,从而改善多模态分布的恢复与各模态之间的相对权重
- 步长与噪声方差成正比,以平衡不同噪声层级的信噪比。将 Langevin 更新中信号与噪声的期望能量之比定义为
 (12)其中,D 为数据维数。标准高斯噪声的期望平方范数为 D,因此
 (13)论文观察到,当 score 网络训练得接近最优时,近似有
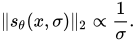
4️⃣ 刻画平滑后扰动分布的 score 学习目标,首先考虑显式地匹配非参数估计分布 的 score,得到显式 score matching 目标
 。进一步地,在引入干净样本
 与扰动样本
 的联合分布后,可以构造去噪 score matching 目标
 ,其核心思想是利用条件扰动核
 的 score 作为可计算的监督信号。尽管二者的形式不同,但在理论上二者是等价的,即对模型参数
 的优化具有相同的效果
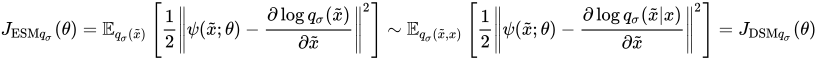 (14)
- 采样阶段所使用的 score 实际上是
 的 score,而非原始数据分布
 的 score。虽然训练时采用条件扰动核
 的 score 作为监督信号,但依据 denoising score matching 理论,网络最优时所逼近的是边缘分布 score:
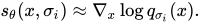 仅当足够小时,由于
 逐渐接近
 ,才有