Omni-Modal
🦉 OpenBMB MiniCPM-o 4.5
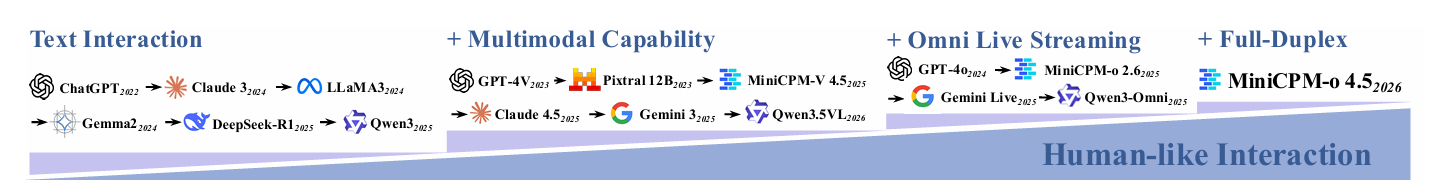
多模态大语言模型的发展,使人工智能系统能够围绕图像、语音、视频和文本开展更为丰富的交互,并逐步接近自然的人机交流形式
- 迈向类人交互的主要障碍已不再仅是模态覆盖范围或响应延迟,而在于底层交互范式
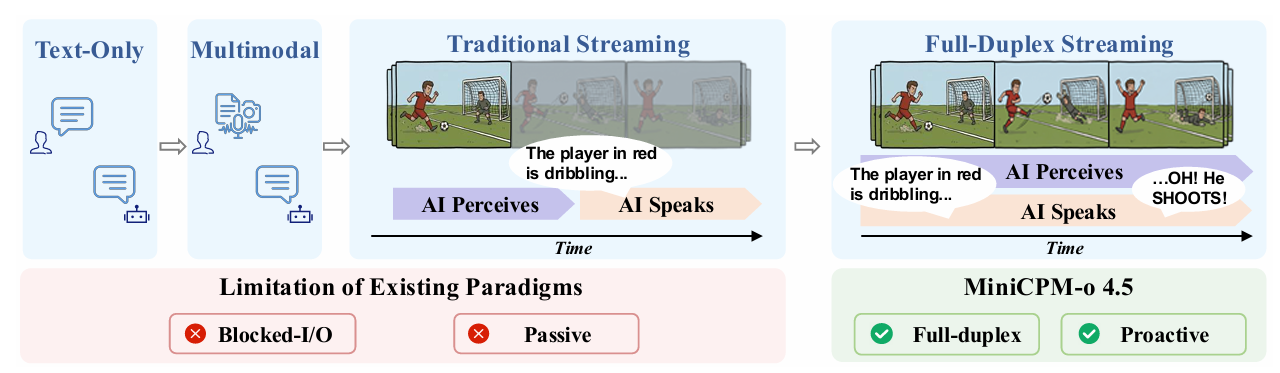
- 现有模型通常将感知与响应限制在交替进行的阶段中,导致模型在生成过程中难以持续整合新到达的信息,并据此及时调整输出
- 模型行为仍主要由用户请求驱动,缺乏依据动态多模态环境主动发起交互的能力
解决这一问题,需要从轮次式、被动式响应转向连续且主动的交互
- 感知与响应应在时间和 token 层面保持持续耦合,使聆听、观察、说话和文本生成能够并行进行,而非被组织为串行流水线
- 模型行为应更多地由上下文驱动,而非单纯依赖用户触发。更接近人类的交互系统应能够根据持续变化的环境主动采取适当行为
基于上述目标,本文提出 MiniCPM-o 4.5。该模型能够实时并行地进行视觉感知、声音监听和语音输出,并依据对现场场景的持续理解,主动执行提醒或评论等行为。其核心技术 Omni-Flow 是一种统一的流式建模框架,通过共享时间轴对多模态输入与输出进行对齐。该框架将交互建模为连续的全双工过程,使感知与响应并行展开,并允许主动行为在同一交互闭环中由当前上下文自然触发
- 为充分利用全模态训练数据,MiniCPM-o 4.5 采用具有 token 级连续连接的端到端架构,并引入时间对齐的交错式语音生成策略,使输出语音与同步变化的环境上下文保持紧密对应。模型同时兼容传统轮次式交互,可在全双工流式模式和常规使用模式之间灵活切换
- MiniCPM-o 4.5 总参数量约为 9B。实验结果表明,其视觉语言能力接近 Gemini 2.5 Flash,并在同等规模的开源模型中达到领先水平;其全模态理解和语音生成能力优于 Qwen3-Omni-30B-A3B,同时具有更高的计算效率。依托端到端连续连接,模型还可以接收同时包含文本和参考音频的多模态系统提示,从而支持声音克隆等高级语音生成能力
🦎 End-to-End Omni-Modal Architecture
MiniCPM-o 4.5 采用端到端全模态架构,既支持 Omni-Flow 框架下的全双工交互,也兼容传统的轮次式推理。模型主要由三个部分构成
- 能够以流式方式处理视觉和音频输入的多模态编码器
- 负责全模态理解与文本生成的大语言模型主干
- 语音解码模块,包括用于自回归生成离散语音 token 的交错式语音 token 解码器,以及将语音 token 转换为音频波形的流式 Flow-Matching 解码器
从多模态编码器、LLM 主干到语音 token 解码器,模型中的全部可训练组件总参数量约为 9B,并在 token 层面保持可微连接。这种设计使梯度能够在各模块之间端到端传播,从而支持训练过程中不同模态之间的联合优化
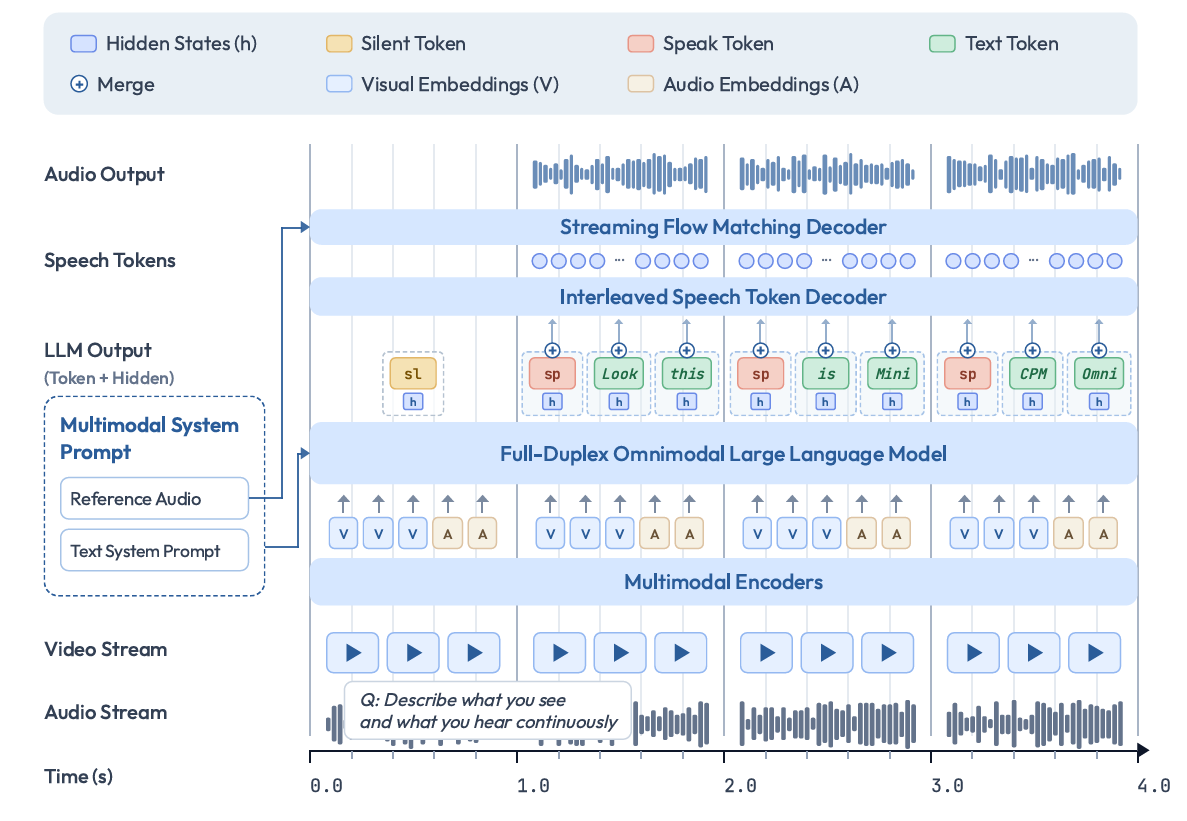
在视觉编码方面,MiniCPM-o 4.5 采用 LLaVA-UHD 的图像切分策略,以处理任意宽高比的高分辨率图像,并通过 Resampler 模块提高视觉 token 的压缩效率。在全双工流式模式下,模型采用的最大图像分辨率为 448×448;在其他模式下,最大分辨率可达到 2240×2240
- 每幅图像首先被划分为若干图像切片,每个切片随后由参数量约为 0.4B 的 SigLIP ViT 编码为 1024 个视觉 token,再通过 Resampler 模块压缩为 64 个 token。由此可实现 16 倍的 token 压缩率,高于现有方法中常见的 4 倍压缩率,从而显著提升视觉信息处理效率
音频编码:MiniCPM-o 4.5 采用参数量约为 0.3B 的 Whisper Medium 编码器,以基于分块的流式方式对输入音频进行编码,每秒产生 50 个特征 token。随后,模型通过两层 MLP 投影器进行 5 倍时间维压缩,将音频序列进一步压缩为每秒 10 个音频 token,并输入 LLM 主干,从而降低音频输入所占用的 token 预算
文本解码:LLM 主干采用 Qwen3-8B,负责生成文本输出以及供语音生成使用的隐藏状态。由于该语言模型仅在文本域中生成 token,因此在实时全双工交互过程中,每秒仅需执行约 3~4 次解码,与人类自然语速大致相当。MiniCPM-o 4.5 将语音 token 的生成任务交由后续的轻量级语音解码器完成
语音 Token 生成:MiniCPM-o 4.5 利用 LLM 主干的上下文理解能力,为语音生成提供高层语义和韵律信息
- 对于输入轻量级 Llama 语音 token 解码器的每个文本 token,模型首先通过 MLP 对其对应的 LLM 隐藏状态进行维度变换,再将该隐藏状态与语音解码器中的文本表示相加,用于后续 S3 语音 token 的生成
- 由于韵律相关决策已预先编码在 LLM 主干的隐藏状态中,参数量约为 0.3B 的轻量级语音解码器可以将更多建模能力集中于语音 token 的生成。此外,输入文本 token 与输出语音 token 按照时间对齐的方式交错排列,使生成语音能够与当前环境上下文保持紧密同步
波形合成:流式 Flow-Matching 解码器依据多模态系统提示中的参考音频,将生成的 S3 语音 token 转换为连续的音频波形
⚙️ Omni-Flow
在现有交互范式中,感知与响应通常被限制在交替进行的阶段内,从而产生输入输出阻塞和被动响应问题。为使模型能够同时进行环境感知与语音表达,本文提出 Omni-Flow 框架,通过共享时间轴协调全模态输入流与输出流
- 受时分复用技术启发,Omni-Flow 将连续交互划分为持续时间为
 的细粒度时间窗口。在每个时间窗口内,模型一方面接收并整合最新到达的环境信号,另一方面生成下一步输出,从而将传统的轮次式交互转化为一系列局部时间范围内的连续更新过程。当时间窗口足够小时,感知与响应在时间上形成紧密耦合,进而自然逼近全双工交互
时间对齐流:将交互过程划分为三条在时间上对齐的数据流
- env-visual:承载来自环境的实时视觉观测
- env-audio:承载当前声学场景,包括可能出现的用户语音
- out-stream:表示助手生成的文本与语音输出
- 用户请求不再被单独建模为一种特殊的对话输入,而是被视为环境状态的一部分,并随其他声音信息一起通过 env-audio 流持续输入模型。模型也不必等待用户发出明确指令后才开始响应,其输出流会随着视觉和音频信息的不断更新而同步调整。模型始终处于对多模态环境的持续感知之中。它不仅需要决定输出什么,还需要根据当前情境自主判断是否应当响应,以及在何时作出响应
统一序列化:基于上述三类数据流,Omni-Flow 将其组织为可由标准因果语言模型处理的统一序列
- 对于第
 个时间块,来自 env-visual 和 env-audio 的输入分别被编码为视觉 token 序列
 和音频 token 序列
 ,而 out-stream 在该时间块内的更新则表示为输出 token 序列
 。当模型在当前时间块内无需产生输出时,仅包含一个特殊的
[listen]token - 模型将同一时间块内对齐的 token 组合为
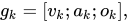 并通过依次拼接各时间块对应的
 ,将整个交互过程序列化为单一序列。在每个时间块内,模型首先处理最新到达的视觉和音频信息,随后生成输出 token,从而确保每次输出都以最近的环境观测为条件
- 减小时间块长度
 可以提高模型更新感知状态的频率,使其输出与动态环境保持更紧密的同步。由于模型会在每个时间窗口内自主判断是否需要输出,该框架能够自然支持主动交互,同时降低对外部语音活动检测模块的依赖
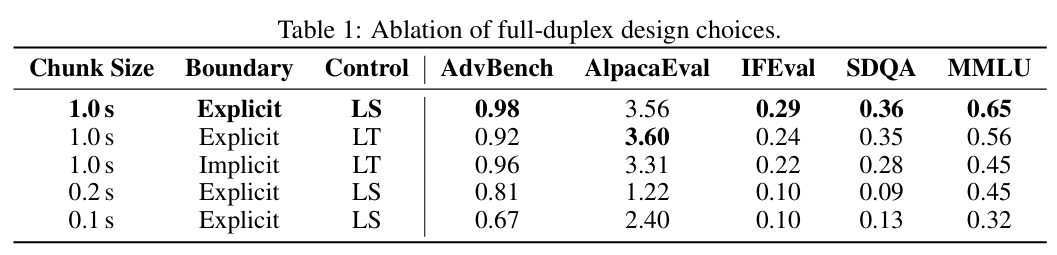
时间粒度、边界显式性和控制方式:时间粒度表示单个时间块的持续时长,实验设置包括 1.0 秒、0.2 秒和 0.1 秒。边界显式性表示是否使用特殊 token 明确分隔相邻时间块。控制方式则决定模型如何判断是否开口,包括 Listen-Speak(LS)和 Listen-Text(LT)两种形式
- 时间粒度体现响应延迟与建模能力之间的核心权衡。缩短时间块能够提高模型对环境变化的响应速度,但也会压缩每个时间块内可用于交互控制和内容生成的建模空间。当时间块过短时,模型无法获得足够的上下文信息,难以作出稳定决策并生成连贯输出,因而会导致性能显著下降
- 显式标记时间块边界能够持续带来性能提升。这说明,对模型而言,区分最新接收的感知输入与新生成的输出并非简单任务;通过特殊 token 显式表达这一结构,可以降低模型的学习负担
- 将交互控制与内容生成分离能够获得更稳定的建模效果。LS 方案整体优于 LT 方案,表明“是否开口”与“具体说什么”应当作为两个相对独立的决策过程。若将二者耦合在一次预测中,会增加全双工交互的学习难度
面向及时语音生成的时间对齐交错策略:Omni-Flow 将模型输出表示为一条随输入信息持续演化的数据流。然而,如何使语音输出始终与最新感知到的环境上下文保持时间同步,仍是一个重要挑战。其根本原因在于文本生成时间与语音播放时长之间存在不匹配:若模型在 秒内生成的文本需要远超过
 秒才能完成语音播报,语音流便会逐渐落后于模型当前的环境状态
- 现有流式语音生成方法通常采用两类策略。第一类方法先生成较长的一段文本,再根据该文本合成语音;第二类方法则按照固定的文本 token 与语音 token 比例,对二者进行交错生成。尽管这两类方法均可获得较高的语音质量,但它们并未显式建立语音内容与交互时间轴之间的对应关系
- 前一种方法会使文本生成进度大幅领先于语音播放进度;后一种方法则隐含地假设文本 token 数量与语音时长之间存在近似固定的对应关系。在全双工交互中,这两种策略都可能使模型持续播报较早生成的内容,导致语音输出无法及时反映当前环境的变化
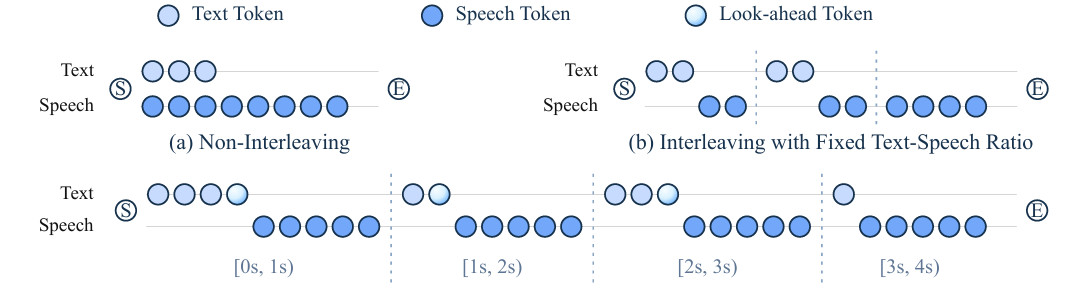
时间对齐交错策略(Time-Aligned Interleaving,TAIL)。TAIL 是一种基于时间块的语音生成方法,可在每一步动态控制文本生成量。它并不将每个时间块独立匹配到固定的语音时长,而是综合考虑整个交互过程中累积的语音播放进度
- 第个时间块中,模型动态调整当前生成的文本数量,使新增内容完成语音播放后,语音流的整体进度尽可能接近当前时间边界
 若此前的时间块已经产生一定的播放延迟,模型便可以在当前时间块中减少文本生成量,为语音流追赶实时进度留出空间。通过这种方式,TAIL 能够使语音响应始终接近模型的最新状态,避免文本生成过度领先于实际语音播放
- 监督数据由全双工流式训练数据构建。首先记录每个文本 token 对应的起始时间与结束时间。对于起始时间位于区间
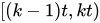 内的文本 token,将其及对应的语音 token 一并划分到第
 个 Omni-Flow 时间块中。该监督形式使模型能够学习一种依赖历史播放状态的交错生成模式,即每个时间块中生成的文本 token 数量可以根据此前累积的时间对齐情况动态变化
- 前瞻式语音生成:语音生成通常还需要有限的后续文本信息。TAIL 进一步引入受限前瞻机制。第个时间块中最后若干文本 token 对应的语音 token 不会立即生成,而是延迟到第
 个时间块;其余文本内容则仍在第个时间块内完成语音生成。这样既能为发音和韵律建模提供必要的局部未来上下文,又不会使文本流显著领先于语音播放进度。因此,TAIL 在保持 Omni-Flow 时间对齐结构的同时,实现连续、及时且具有较好发音与韵律质量的流式语音生成
🦾 Training
构建全模态模型面临的关键挑战之一,是在实现高效、平滑的跨模态泛化的同时,保留各单一模态原有的基础能力。为此,作者设计一套分阶段训练方案,在 MiniCPM-V 4.5 预训练检查点的基础上,以稳定、渐进的方式将语音能力整合到多模态系统中
训练首先通过语音预训练建立基础的音频理解与语音生成能力;随后进行联合预训练,以学习统一的跨模态表示;在此基础上,通过监督微调增强模型在文本、语音、图像和视频上的指令遵循与高质量交互能力;最后引入强化学习,进一步提升推理能力并抑制模型幻觉
语音预训练:MiniCPM-o 4.5 以预训练的 Whisper 编码器和 MiniCPM-V 4.5 预训练检查点进行初始化,同时随机初始化新增的语音相关模块,包括音频投影器、LLM 到语音空间的投影器以及语音解码器
- 该阶段冻结所有预训练组件,仅更新新增模块的参数。训练目标主要包括两方面:一是将 Whisper 输出的音频特征对齐到 LLM 的隐藏表示空间;二是训练语音解码器,使其能够将 LLM 主干的隐藏状态转换为同时包含语义和韵律信息的语音 token
联合预训练:在第二阶段,模型解冻全部参数,并在视觉语言、语音和全模态数据构成的均衡混合数据集上进行联合预训练。为提高优化过程的稳定性,不同模态组合的数据被分配到不同的数据并行 rank 上,从而确保每个训练步骤中的数据比例保持固定
- 训练数据除传统的轮次式交互样本外,还包含主动交互与全双工交互数据。文本 token、语音信号与视觉信号被统一对齐到共享时间轴上。整个模型采用统一的下一 token 预测目标进行训练,从而在保留基础视觉理解能力的同时,获得实时全模态交互能力
联合监督微调:联合监督微调阶段用于激活模型的全模态能力,并强化其指令遵循能力。该阶段分为两个步骤:首先使用大规模指令数据进行训练,使模型广泛适应不同任务;随后使用高质量人工标注数据进行进一步微调,以细化模型的交互行为和响应质量
- 为使模型在推理阶段能够灵活权衡效果与计算效率,训练过程中还对全模态数据采用不同的图像分辨率和视频帧率进行增强。具体而言,最大帧分辨率被随机设置为 0.2~0.4 百万像素,视频帧率则从 1~5 FPS 的范围内均匀采样
强化学习:在监督微调之后,MiniCPM-o 4.5 进一步采用强化学习进行优化。首先使用 GRPO 提升模型的推理能力和指令遵循能力。奖励信号主要包括答案准确率,以及格式奖励等辅助奖励。对于准确率奖励,作者将基于规则的答案验证与轻量级 Judge 模型相结合,以提高对正确答案的识别召回率。为提升 token 使用效率,作者在 Kimi-K1.5 长度奖励的基础上设计一种平滑长度奖励
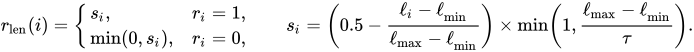 (1)
 表示第
 个回答是否正确;
 表示该回答的长度;
 和
 分别表示同一提示下所有候选回答的最短和最长长度
- 对于正确回答,奖励会根据其相对长度进行调整,鼓励模型减少不必要的冗余输出。对于错误回答,采用
 可避免模型仅因回答较短而获得正奖励。参数
 用于在候选回答长度差异较小时降低长度奖励的强度,防止长度因素对训练产生过度影响
- 除上述奖励外,训练还引入通用奖励模型,以提升整体回答质量并抑制非预期的语言混杂现象。为提高训练收敛的稳定性,前 480 个训练步骤不使用长度奖励,待准确性优化初步稳定后再加入该奖励。
- 最后采用 RLAIF-V 降低视觉场景中的模型幻觉。实验发现,在图像—文本数据上学习到的幻觉抑制能力可以有效迁移到全模态全双工交互中,从而减少模型在流式交互场景中的视觉幻觉
🦉 Qwen3.5-Omni Technical Report
人类与现实世界的交互天然具有全模态性与智能体性:这一过程不仅需要综合处理视觉、听觉和语言信息,还需要通过文本、语音以及面向目标的工具调用行为生成响应,从而实现与其他个体之间的信息交换,并体现智能能力
- 大模型在文本理解与推理、视觉理解以及音频处理等方面取得快速进展。在此基础上,能够对多种模态进行联合处理与生成的原生全模态系统逐渐受到广泛关注
- 现有模型大多仍局限于被动的感知—响应范式,在可扩展智能体行为、实时交互、自主工具调用以及跨模态推理等方面能力有限,而这些能力正是模型实现实际部署所必需的基础条件
Qwen3.5-Omni,即 Qwen 最新一代完全全模态大语言模型。该模型支持对文本、图像、音频及音视频内容的统一理解
- Qwen3.5-Omni 基于海量文本、视觉数据以及超过 1 亿小时的音视频数据进行原生全模态预训练,其设计目标是构建一个原生全模态智能体模型
- 模型不仅能够跨模态感知与推理,还能够进一步执行实际行动,包括自主调用 WebSearch、执行复杂的 FunctionCall、生成语音输出,并参与实时流式交互
- Qwen3.5-Omni 系列包含 Plus 和 Flash 两种版本,二者均为指令微调模型,并支持最长 256K tokens 的长上下文输入
Qwen3.5-Omni 延续 Qwen2.5-Omni 提出的 Thinker–Talker 架构,并在 Qwen3-Omni 的基础上引入五项关键技术升级
- Thinker 与 Talker 均采用混合注意力专家混合模型设计,从而显著提升推理效率
- 模型支持最长 256K tokens 的长上下文建模,可处理超过 10 小时的音频内容,以及超过 400 秒、分辨率为 720P、采样率为 1 FPS 的音视频内容
- 在语音生成方面,模型采用多码本编解码表示,能够实现单帧级、即时语音合成
- Talker 引入 ARIA,该技术能够在流式解码过程中动态对齐文本单元与语音单元,从而显著提升生成语音的自然度与鲁棒性
- 模型大幅扩展多语言训练范围,语音识别覆盖 113 种语言及方言,语音合成则覆盖 36 种语言
Qwen3.5-Omni 相较于 Qwen3-Omni 获得三类主要新能力
- 模型支持可控音视频描述生成,能够生成细致、结构化且可控的字幕与描述,并可进一步输出剧本级的细粒度内容,包括自动场景分割、时间戳标注,以及对人物及其与音频内容之间关系的详细刻画
- 模型具备全面的实时交互能力,包括通过原生轮次切换意图识别实现语义级打断,端到端控制语音音量、语速和情感表达,以及基于用户提供样本进行音色克隆
- 模型具备原生全模态智能体能力,可自主执行 WebSearch、调用复杂 FunctionCall,并展现出 Audio-Visual Vibe Coding 这一涌现能力,即模型能够直接根据音视频指令生成可执行代码,从而无需外部编排系统即可对实时查询作出响应
🐱 Architecture
Qwen3.5-Omni 在模型可扩展性、跨模态对齐以及实时交互能力方面引入多项关键改进
- 整体主干网络采用混合专家模型设计,在提升模型扩展能力的同时,更好地平衡全模态理解与生成任务中的模型容量和计算效率
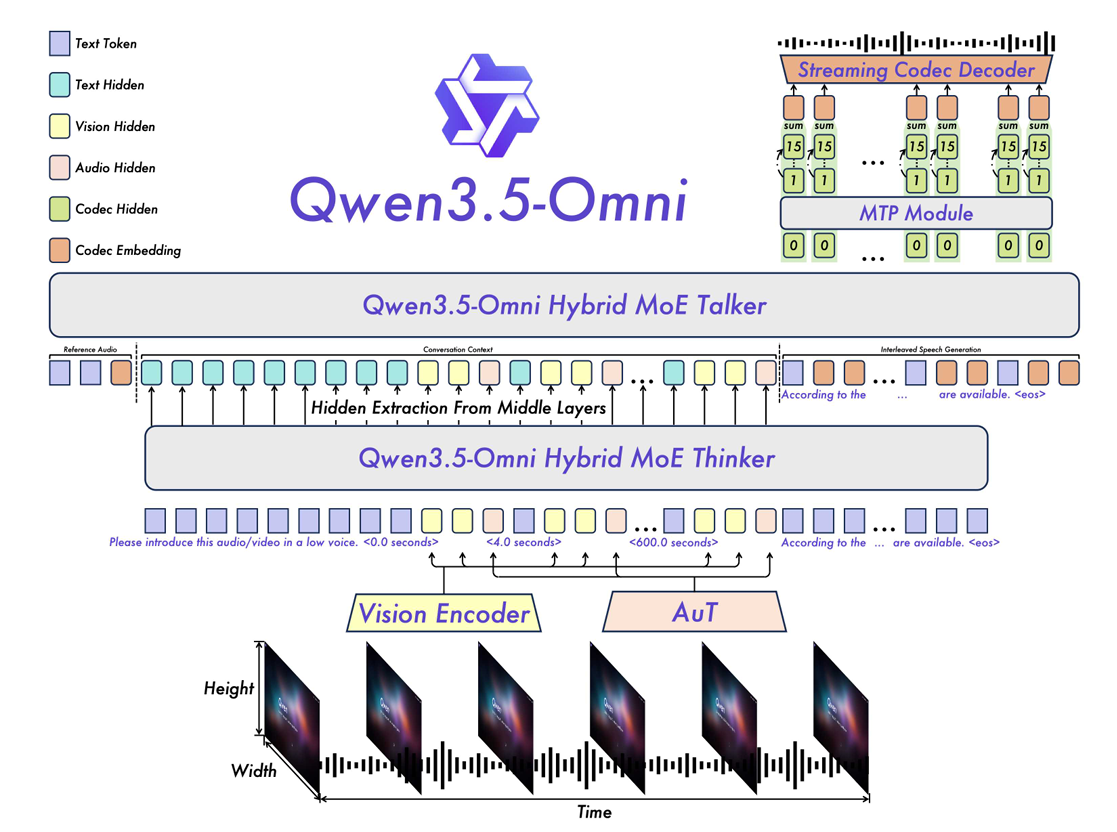
- Thinker 分别通过视觉编码器和 AuT 编码器接收视觉信号与音频信号。音频和视频输入以交错形式组织,并在统一的多模态建模过程中显式插入时间戳,以增强模型的时序感知能力,尤其适用于长视频及长音视频上下文。得益于这一设计,Thinker 能够处理超长输入,支持最长 256K tokens 的上下文、超过 10 小时的音频,或长达 400 秒、分辨率为 720P、采样率为 1 FPS 的视频内容
- Talker 负责上下文相关的语音生成,其生成过程同时以多模态输入和 Thinker 输出的文本结果为条件。Qwen3.5-Omni 沿用基于残差向量量化的语音表示方法,从而显著提升语音生成阶段的推理效率。
- 为支持实时交互,Qwen3.5-Omni 在 Thinker 中采用基于数据块的流式输入处理机制,同时为 Talker 引入流式生成架构,从而实现低延迟的端到端全模态对话
- 不同于 Qwen3-Omni 中采用的双轨 Talker 输入设计,Qwen3.5-Omni 的 Talker 引入 ARIA,在交错文本单元与语音单元之前对二者进行动态对齐。能够缓解文本与语音 token 化速率不匹配所引发的生成不稳定问题,从而减少漏词、错误发音以及数字表达歧义等现象
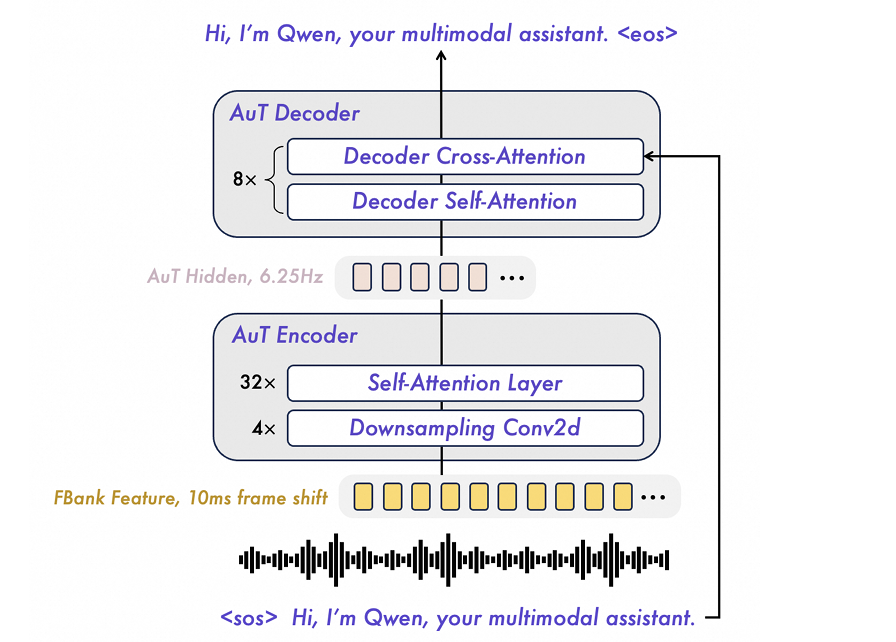
AuT 采用基于注意力机制的编码器—解码器架构,其音频编码器基于 Transformer 构建,并从零开始训练。Qwen3.5-Omni 音频编码器的训练使用由 Qwen3-ASR 生成的约 4000 万小时音频—文本配对数据
- 音频的滤波器组特征首先经过 4 个二维卷积模块进行总计 16 倍下采样,随后输入自注意力层进行建模,最终得到 token 速率为 6.25 Hz 的音频表征
- Qwen3.5-Omni 进一步引入覆盖 20 余种语言的多语种训练数据,其中中文、英文和其他语种数据的比例为 3.5∶3.5∶3
- 训练过程中采用动态注意力窗口机制,以兼顾实时场景下采用 prefill 缓存的推理性能与离线音频理解任务的性能
Thinker 将文本、音频、图像以及无音频视频输入统一转换为一系列共享表征
- 文本输入采用 Qwen3.5 分词器。该分词器基于字节级字节对编码,词表规模由 15 万扩展至 25 万,从而使大多数语言的编解码效率提升约 10%–60%
- 对于音频输入,包括从视频中分离得到的音轨,首先将波形重采样至 16 kHz,随后采用 25 ms 窗长和 10 ms 帧移,将其转换为 128 通道的 Mel 频谱图。音频编码器采用 AuT,并基于 4000 万小时音频数据从头训练;其每个输出帧约对应原始音频中的 160 ms 信号
- 对于视觉输入,采用 Qwen3.5 的视觉编码器统一处理图像与视频。该编码器在图像和视频混合数据上进行训练,因此同时具备较强的图像理解与视频理解能力。为在尽可能保留视频信息的同时维持与音频流的时间对齐,采用动态帧率对视频进行采样
Qwen3.5-Omni 依据各模态的时间位置 ID 对这些表征进行对齐,而这些时间位置 ID 均被显式锚定至绝对时间。该设计使模型能够灵活处理任意时长的流式输入
- 沿用 Qwen3-Omni 的设计,采用 TM-RoPE 为模型引入时间感知能力,以实现音视频同步。若直接通过时间位置 ID 编码绝对时间,对于包含音频的长视频输入,视觉 patch 的位置索引会变得过于稀疏,从而削弱模型对长程时序关系的建模能力。此外,这种设计通常需要在不同帧率下构建大规模且分布均匀的训练样本,进一步增加数据构建成本
- 为解决上述问题,在每个视频或音视频时序 patch 之前加入显式时间戳,并以秒为单位的格式化文本字符串表示,使模型能够以更加自然的方式学习时间码表征。对于音频序列,还会以随机间隔插入时间戳,以进一步增强不同模态之间的时间对齐能力。尽管该策略会略微增加上下文长度,但能够显著提升模型时间感知的精确性与鲁棒性,尤其有利于模型向长上下文多模态输入进行外推
- 在多模态音视频流中,音频每 160 ms 分配一个时间位置 ID。视频则被表示为按时间顺序排列的帧序列,其时间位置 ID 单调递增,并根据各帧的真实时间戳动态调整,以确保每个时间位置 ID 始终对应 160 ms 的统一时间分辨率。视频帧的高度和宽度位置 ID 与静态图像采用相同的分配方式
- 为避免多模态联合处理时出现位置索引冲突,不同模态的位置编号采用连续衔接的方式:后一模态的位置编号从前一模态最大位置 ID 加 1 开始
Talker 直接对 Qwen3.5-Omni-Audio-Tokenizer 生成的 RVQ token 进行建模
- 为刻画残差码本中的信息,Talker 引入多 token 预测模块,从而能够对细粒度声学细节进行建模与控制。结合用于波形重建的因果卷积网络,Talker 能够以较低的推理延迟和有限的计算开销实现高保真语音合成
- 在多轮语音对话中,Talker 以 Thinker 提供的丰富上下文信息作为条件,包括历史文本 token、多模态表征以及当前轮次中流式生成的文本。借助这些条件信息,Talker 可以根据不断演化的对话上下文,动态调节韵律、音量和情感等声学属性
- 在架构设计上,与 Qwen3-Omni 主要存在两方面差异
- 为 Talker 引入独立的系统提示词,用于指定目标音色及相关语音特征,从而支持零样本音色克隆与可控语音生成。相较于传统的说话人嵌入,该系统提示词能够编码更为丰富的多模态条件信息,包括文本描述和音频编解码序列,因此可以对最终语音的声学表现进行更加细粒度的控制
- 提出 ARIA,将传统的双通道生成范式统一为单通道生成形式。ARIA 不依赖基于强制对齐(MFA)获得的文本—语音对应关系,也不采用固定的交错速率,而是引入一种自适应速率约束:对于生成序列的任意前缀,其中累计生成的语音 token 数与文本 token 数之比,均不得超过当前样本整体的语音—文本 token 比例
- ARIA 将 Qwen3-Omni 中彼此独立的文本与语音双通道生成方式,重新表述为文本 token 与语音 token 统一交错的单流生成形式。通过对文本和语音的生成顺序施加单调交错约束,ARIA 减少不同生成通道之间的同步开销,提高解码阶段的 token 调度效率,同时也更契合流式交互天然具有的增量式生成过程
分块预填充与混合专家架构
- Qwen3.5-Omni 音频编码器和视觉编码器均可沿时间维度逐块输出表征,从而避免在完整音视频输入处理结束后才启动后续推理。该机制能够显著缩短 Thinker 和 Talker 的首 token 延迟
- 在模型架构方面,Qwen3.5-Omni 的 Thinker 与 Talker 均基于 Qwen3.5 提出的 Hybrid MoE 架构重新构建。除混合专家模型本身具备的计算效率优势外,该架构还引入 Gated DeltaNet(GDN) 模块,尤其适用于长音视频序列的高效建模。借助 GDN,模型在长上下文推理过程中能够显著降低 KV Cache 的读写开销,从而提升生成吞吐量,并支持更高的在线服务并发度
🦊 Pretraining
第一阶段冻结大语言模型参数,重点训练视觉编码器和音频编码器,并利用大规模音频—文本与图像—文本配对数据,建立模态编码器与大语言模型语义空间之间的对齐关系。第二阶段解冻全部模型参数,在序列长度为 32,768 tokens 的条件下,引入更加多样的多模态数据进行联合训练,以实现更加全面的跨模态学习。第三阶段将训练序列长度扩展至 262,144 tokens,以增强模型对复杂长序列数据的理解能力
- 编码器对齐阶段:预训练初始阶段,大语言模型部分采用 Qwen3.5 的参数进行初始化,视觉编码器继承自 Qwen3.5,音频编码器则由 AuT 初始化。在冻结大语言模型参数的条件下,视觉编码器和音频编码器分别进行训练。对于两类编码器,均先训练其对应的适配器,随后再训练编码器本体
- 通用预训练阶段:第二阶段采用约 4 万亿 tokens 的大规模训练数据,其中各模态数据量分别为:文本 0.92 万亿 tokens、音频 1.99 万亿 tokens、图像 0.95 万亿 tokens、视频 0.14 万亿 tokens,以及音视频联合数据 0.29 万亿 tokens。在该阶段,通过引入更加丰富的多模态数据与任务,进一步提升模型对听觉、视觉、文本及音视频联合信息的理解与交互能力
- 长上下文训练阶段:在预训练的最后阶段,将最大序列长度由 32,768 tokens 扩展至 262,144 tokens,同时提高长音频和长视频样本在训练数据中的占比
🐼 Post-training
Thinker 的后训练采用三阶段策略,旨在确保模型在各模态上的能力不发生退化,提升其在音频查询条件下的响应质量,并进一步优化整体交互体验。训练语料统一组织为 ChatML 格式,涵盖纯文本、视觉、音频以及混合模态对话数据
- 专家模型蒸馏阶段:基于 Qwen3.5 预训练基座模型,分别通过监督微调与强化学习训练文本、视觉、音频等领域的专家教师模型,并利用教师模型生成领域专属数据,将分散于不同模态和任务中的专业能力统一蒸馏至单一全模态模型中
- 同策略蒸馏阶段:针对音频查询响应质量弱于文本查询的问题,将模型在文本条件下生成的高质量响应作为对应音频查询的蒸馏目标,使音频条件下的生成行为逐步向文本条件下的生成能力对齐,从而提升音频输入场景中的流畅性、推理质量与任务完成能力,并增强跨模态响应的一致性
- 交互对齐强化学习阶段:面向真实多轮交互中的语言切换、角色不一致及长上下文指令遵循退化等问题,构建多轮交互轨迹,并围绕语言一致性、角色稳定性和持续指令遵循等目标设计奖励信号,以优化模型在长期对话中的稳定性、一致性与实际可用性
Talker 采用四阶段训练流程,使 Qwen3.5-Omni 能够在生成文本响应的同时,输出自然、连贯且符合上下文语境的语音。所有训练数据均采用 ChatML 格式进行组织,以保证与 Thinker 的数据结构一致,并为音色克隆任务提供统一的数据表示基础
- 通用训练阶段:基于超过 2000 万小时的多语言语音数据及其多模态上下文进行预训练,使 Talker 获得基础语音生成能力,并通过指令式语音生成等任务增强上下文推理与副语言信息建模能力。
- 长上下文训练阶段:对训练数据进行质量分层,并在高质量语料上实施持续预训练,同时将上下文长度扩展至 64K tokens,以降低噪声数据引发的幻觉,并提升长上下文条件下语音生成的自然度、连贯性与语境一致性
- 强化学习阶段:基于人工构建的多语言偏好数据,采用 DPO、规则奖励与 GSPO 进一步优化模型,使生成语音在自然度、任务完成度及人类偏好一致性方面得到提升,同时增强训练稳定性。
- 说话人微调阶段:在基座模型上进行轻量级说话人适配,使模型能够更准确地复现目标说话人的音色、韵律和表达特征,并进一步提升语音输出的自然度、表现力与可控性