Diffusion Language Models
🌊 Large Language Diffusion Models
大语言模型完全处于生成式建模的框架之内。大语言模型旨在通过最大似然估计来优化模型分布 ,从而刻画真实但未知的语言分布
 ;等价地,这一过程也可以表述为最小化这两个分布之间的 KL 散度
- 当前占主导地位的方法采用自回归建模,即通常所称的下一 token 预测范式,来定义模型分布
- 其中,
 是长度为
 的序列,
 表示第
 个 token 。这一范式已被证明极为有效,并成为当前大语言模型的基础。然而,尽管它得到广泛应用,一个根本性问题仍未得到解答:自回归范式是否是实现大语言模型核心能力——例如可扩展性、上下文学习和指令遵循的唯一路径
作者认为,此前被忽视的关键认识在于:从根本上支撑大语言模型基本特性的,是生成式建模原则,而不是自回归形式
- 可扩展性主要源于 Transformer、模型规模、数据规模,以及由生成式建模原则所带来的费舍尔一致性之间的相互作用,而并非自回归模型独有的结果
- 扩散 Transformer 在视觉数据上的成功支持这一观点。在结构一致的语言任务上,指令遵循和上下文学习能力似乎是所有条件生成模型的内在属性,而非自回归模型独有的优势。尽管自回归模型可以被解释为一种无损数据压缩器,但任何具有足够表达能力的概率模型都可以实现类似的能力
- 然而,大语言模型的某些固有限制,可以直接归因于其自回归性质。例如,从左到右的生成过程限制它们处理逆向推理任务的能力,这凸显当前模型在泛化能力方面的一种典型缺陷
基于上述认识,提出 LLaDA,以探究大语言模型所展现的能力,能否从自回归模型之外的生成式建模原则中涌现,从而回答前述根本性问题
- 不同于传统自回归模型,LLaDA 采用掩蔽扩散模型(Masked Diffusion Model,MDM),其中包含一个前向数据掩蔽过程,并通过训练掩蔽 token 预测器来近似对应的逆向过程。这一设计使 LLaDA 能够构建具有双向依赖关系的模型分布,并优化其对数似然的变分下界,从而为理解上述大语言模型的核心能力,提供一个具有理论依据且此前尚未探索的视角
- 采用包括数据准备、预训练、监督微调和评估在内的标准流程,将 LLaDA 扩展至语言扩散模型此前未达到的 8B 参数规模
- 具体而言,LLaDA 8B 在 2.3 万亿个 token 上从零开始预训练,消耗 13 万 H800 GPU 小时,随后使用 450 万对样本进行监督微调
📡 Large Language Diffusion with mAsking
不同于自回归模型,LLaDA 通过一个前向过程和一个逆向过程来定义模型分布 。前向过程逐步、独立地掩蔽
 中的 token ,直至在
 时整个序列完全被掩蔽。当
 时,序列
 处于部分掩蔽状态,每个 token 以概率
 被掩蔽,或以概率
 保持未掩蔽状态。逆向过程则随着从 1 变化至 0,通过迭代预测被掩蔽的 token 来恢复数据分布
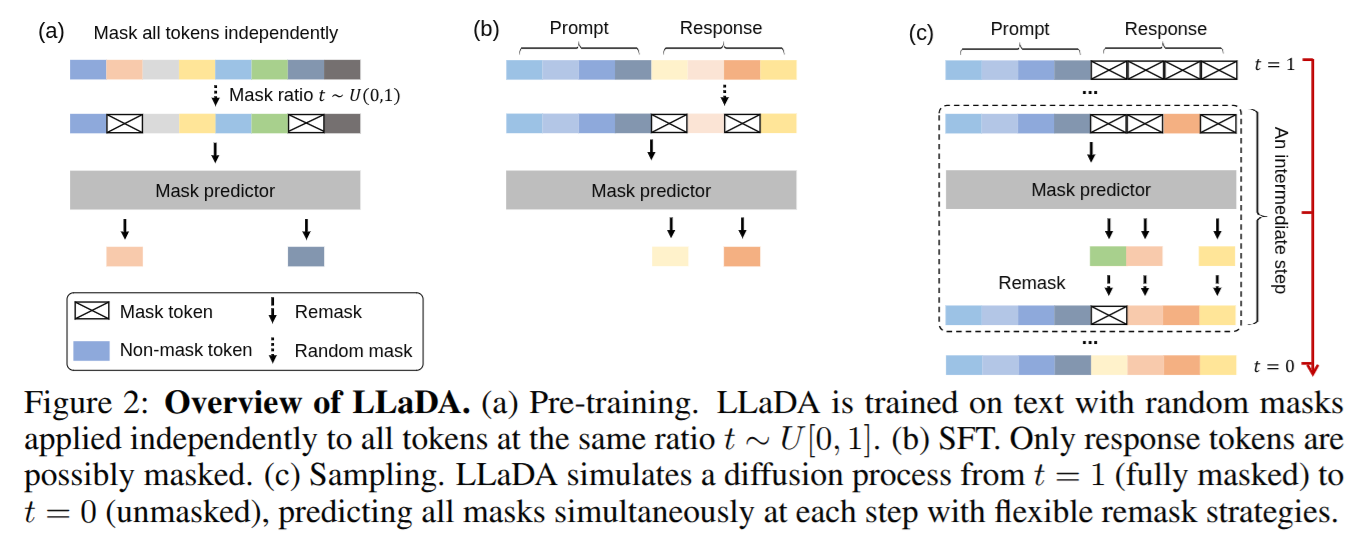
LLaDA 的核心是一个掩蔽 token 预测器,即参数化模型 。它以为输入,同时预测所有被掩蔽的 token ,其中掩码 token 记为
 。训练时,仅在被掩蔽的 token 位置上计算交叉熵损失
- 其中,为训练样本,为从
 上均匀采样的连续随机变量,从前向过程中采样得到,为序列长度。指示函数
 确保仅在被掩蔽的 token 位置上计算损失
- 训练完成后,可以模拟由掩蔽 token 预测器参数化的逆向过程,并将该过程在
 时诱导的边缘分布定义为模型分布。已有研究证明,式(3)中的损失函数是模型分布负对数似然的上界,因此,它为生成式建模提供具有理论依据的优化目标
- LLaDA 使用在 0 到 1 之间随机变化的掩蔽比例,而 BERT 使用固定的掩蔽比例。这一细微差异具有重要影响,尤其是在大规模建模情形下:如式(4)所示,LLaDA 是一种具有理论依据的生成模型,具有像大语言模型一样自然进行上下文学习和指令遵循的潜力
- 生成式建模视角意味着它在大规模数据和模型下具有较强的可扩展性。正是最大似然估计的理论基础,促使将离散扩散模型扩展至大规模语言建模
与现有大语言模型类似,LLaDA 使用 Transformer 作为掩蔽 token 预测器。LLaDA 不使用因果注意力掩码,因为其建模形式允许模型在预测时访问完整输入
- 训练两种不同规模的 LLaDA,参数量分别为 1B 和 8B。论文中的双向掩码预测无法直接沿用自回归解码的 KV 缓存机制,因此为简化实现,使用标准多头注意力,而非分组查询注意力。注意力层因此具有更多参数,相应缩小前馈网络的维度,以保持相近的模型规模。由于采用针对训练数据适配的分词器,词表大小也有所不同
- LLaDA 在包含 2.3 万亿个 token 的数据集上进行预训练,数据处理流程与现有大语言模型高度一致,未引入任何特殊技术。数据来自在线语料,使用人工设计的规则和基于大语言模型的方法过滤低质量内容。除通用文本外,数据集还包含高质量的代码、数学和多语言数据。预训练采用固定的 4096 token 序列长度,总计算开销为 13 万 H800 GPU 小时,与相同模型规模和数据规模下的自回归模型相近
- 对于训练序列,随机采样
 ,以相同的概率独立掩蔽每个 token ,得到,并通过蒙特卡洛方法估计式(3),用于随机梯度下降训练。此外,遵循 Nie et al. 的方法,为增强 LLaDA 处理变长数据的能力,将 1% 的预训练数据设置为随机长度,该长度从
 范围内均匀采样
使用成对数据 进行监督微调,以增强 LLaDA 的指令遵循能力,其中
 表示提示,
 表示响应。该过程需要建模条件分布
 ,而不是预训练阶段的
- 其实现方式与预训练类似。保持提示不变,并像处理一样,独立掩蔽响应中的 token 。随后,将提示与掩蔽后的响应
 一并输入预训练的掩蔽 token 预测器,计算 SFT 损失
- 该方法与预训练完全兼容。本质上,与的拼接可以视为未掩蔽的预训练数据,而与的拼接则对应掩蔽后的版本。这一过程与预训练相同,唯一的区别是所有被掩蔽的 token 都位于部分
- LLaDA 8B 在包含 450 万对样本的数据集上进行 SFT。与预训练过程一致,数据准备和训练均遵循现有大语言模型所采用的 SFT 流程,未引入任何额外技术来优化 LLaDA 的性能。该数据集覆盖代码、数学和指令遵循等多个领域。对于每个小批量中较短的样本对,在末尾追加
|EOS|token ,以确保所有样本长度一致。训练时,将|EOS|视为普通 token ;采样时则将其移除,从而使 LLaDA 能够自动控制响应长度
作为生成模型,LLaDA 能够以扩散方式采样生成新文本,并评估候选文本的似然,而不是采用从左到右的自回归方式
- 逆向生成过程:给定提示,从一个完全被掩蔽的响应开始,通过离散化逆向过程,从模型分布中采样。总采样步数是一个超参数,这使 LLaDA 能够自然地在效率与样本质量之间进行权衡。默认情况下,采用均匀间隔的时间步。此外,生成长度也被视为一个超参数,用于指定采样过程开始时完全被掩蔽的序列长度。生成完成后,丢弃
|EOS|token 之后的所有 token
- 在从时间
![t\in(0,1]](assets/math/9062d1349e81fd95a5670c53f1c06a5a.svg) 到
 的一个中间步骤中,将和一并输入掩蔽 token 预测器,同时预测所有被掩蔽的 token 。随后,在期望意义上,将这些预测 token 中比例为
 的部分重新掩蔽,得到
 ,其重新掩蔽概率对应前向过程所诱导的逆向转移
- 原则上,重新掩蔽策略应当完全随机。然而,受大语言模型采样中退火技巧的启发,采用低置信度重新掩蔽策略:根据模型预测,将预测 token 中置信度最低、占比为的部分重新掩蔽
- LLaDA 支持灵活的采样方式。具体而言,在完成上述预训练或 SFT 后,它可以直接支持自回归采样和块扩散采样,无需任何进一步的修改或训练。不过,扩散采样,即逆向生成过程,能够获得最佳性能,因此被作为本文的默认采样方式
- 对于条件似然评估,可以自然地利用式(5)中的上界。然而下述等价形式具有更低的方差,且更加稳定
- 其中,为的序列长度,
 从集合
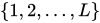 中均匀采样;
 则通过从中均匀、无放回地采样个 token 并将其掩蔽而得到
🧮 Training and Evaluation Algorithms
预训练与监督微调均通过随机掩码构造预测任务,区别在于监督微调始终保留提示,仅对响应施加掩码
表示前文的独立掩码过程,每个位置以概率 变为 ,以概率 保留原 token - 算法 1 与算法 2 分别按输入长度
和响应长度 对损失归一化;预训练中有 1% 的样本使用从 均匀采样的序列长度
条件似然评估通过重复掩码估计与式(6)对应的对数似然下界,并以此为候选响应评分
- 固定提示
与响应 ,每次先均匀采样掩码数量 ,再无放回地选择掩码位置; 为响应长度, 为蒙特卡洛估计次数
🎲 Remasking Algorithms
两种重掩码策略均并行预测当前掩码位置,保持已经确定的 token 不变,并逐步减少掩码数量
为响应长度, 为采样步数,时间从 逐步递减至 0。附录算法采用逐位置贪心预测,二者的区别在于重掩码位置的选择:随机策略以概率 重新掩蔽预测结果,低置信度策略则优先保留高置信度预测
低置信度重掩码按目标保留数量筛选预测,使置信度较低的位置在后续步骤中继续更新
为位置 上预测 token 的概率, 表示时间 应保留的 token 数量,因此需要重新掩蔽 个位置。原附录将二者混写,下面据作者实现校正计数,并限定从当前掩码位置中选择 返回置信度最低的 个位置索引,置信度相同时固定择序; 时返回空集
📡 Block Diffusion: Interpolating Between Autoregressive and Diffusion Language Models
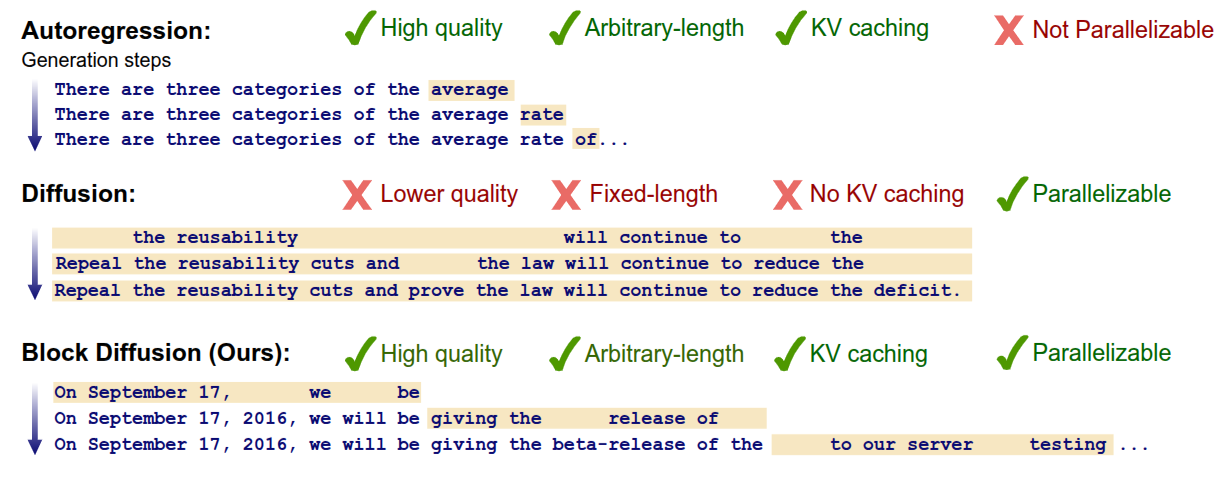
与自回归模型相比,扩散模型具有加速生成过程、提高模型输出可控性的潜力。目前,离散扩散模型至少面临三项局限
- 首先,在聊天系统等应用中,模型必须能够生成任意长度的输出序列,例如对用户问题的回答。然而,近期大多数扩散架构只能生成固定长度的向量
- 其次,离散扩散在生成过程中使用双向上下文,因此无法通过 KV 缓存复用此前的计算结果,导致推理效率较低
- 最后,以困惑度等标准指标衡量时,离散扩散模型的质量仍落后于自回归方法,进一步限制其适用性
本文提出块离散去噪扩散语言模型,在解决上述局限方面取得进展。这类模型在离散扩散模型与自回归模型之间进行插值
- 具体而言,块扩散模型亦称半自回归模型,它在由离散随机变量组成的块之间定义自回归概率分布;在给定先前各块的条件下,当前块的条件概率则由离散去噪扩散模型刻画
- 构建有效的 BD3-LMs 面临两个挑战。首先,仅通过神经网络的一次标准前向传播,无法高效计算块扩散模型的训练目标,因此需要开发专门的算法。其次,扩散目标的梯度方差较高,阻碍模型训练,导致 BD3-LMs 即使在块大小为 1 时,表现仍不及自回归模型,而此时两类模型本应等价
- 推导梯度方差的估计量,并表明,梯度方差是造成自回归模型与扩散模型之间困惑度差距的一个关键因素。随后,提出专门设计的噪声过程,以最小化梯度方差,并在缩小这一困惑度差距方面取得进展
与在嵌入空间中执行高斯扩散的其他半自回归形式相比,BD3-LMs 支持可计算的似然估计,并且能够在生成步数减少一个数量级的情况下,生成具有更优生成困惑度的样本。综上,本文的主要贡献如下:
- 提出块离散扩散语言模型,在 token 块之间采用自回归建模,而每个块的条件分布则基于离散扩散。与先前扩散模型不同,块扩散支持变长生成和 KV 缓存
- 提出针对块扩散模型的专用训练算法,能够高效利用输入模型的整个批次中的全部 token 。发现梯度方差是限制扩散模型性能的一个因素,并提出专门设计的数据驱动噪声调度,以降低梯度方差
💻 Background: Language Modeling Paradigms
将具有 个类别的标量离散随机变量,表示为空间
 中的独热列向量,其中
 表示概率单纯形
- 第个类别对应特殊的
[MASK]token ,其独热向量记为
- 用
 表示由
 个 token 构成的序列,对于所有位置
 ,均有
 ;用
 表示所有此类序列构成的集合。
 表示概率向量为
 的类别分布
自回归模型:考虑从数据分布 中抽取的、由个 token 构成的序列
 。自回归模型定义如下形式的因子分解分布
- 其中,每个条件分布
 均由神经网络直接参数化。因此,自回归模型可以通过下一 token 预测进行高效训练。然而,由于存在顺序依赖关系,自回归模型生成个 token 需要执行个步骤
离散去噪扩散概率模型:扩散模型通过拟合模型 ,来逆转前向扰动过程

- 该过程从干净数据
 出发,对于
 ,定义潜变量
 ,表示的噪声程度逐渐增大的版本。将这一过程离散化为
 个步骤后,定义
 和

- D3PM 框架将定义为独立作用于每个 token
 的马尔可夫前向过程,即
 ,其中,
 为扩散矩阵。
 可以刻画多种变换,包括掩蔽、随机 token 替换,以及相关词语替换。理想的扩散模型
 是过程的逆过程。D3PM 框架将定义为
- 其中,基础去噪模型
 在给定含噪序列
 的条件下,预测干净 token 。扩散模型通过变分推断进行训练。令
 表示 Kullback–Leibler 散度,则负证据下界为
🌊 Block Diffusion Language Modeling
研究一类块离散去噪扩散语言模型。这类模型通过在 token 块之间定义自回归分布,并在每个块内部执行扩散,在自回归模型与扩散模型之间进行插值
- 提出用于最大似然估计的块扩散目标,以及高效的训练和采样算法。表明,当块大小为 1 时,尽管扩散目标在期望意义上等价于自回归似然,但其方差仍然较高。将较高的训练方差识别为扩散模型的一项局限,并提出数据驱动的噪声调度,以降低训练过程中梯度更新的方差
块扩散分布与模型架构:在 token 块之间进行自回归建模,并在每个块内部执行扩散
- 将序列中的 token 划分为
 个长度为
 的块,其中
 ,并假设为整数。对于
 ,将位置从
 到
 的 token 块
 记为
 。模型的对数似然按块分解为
- 每个条件分布
 均通过在包含个 token 的块上执行离散扩散来建模。定义一个与式(2)类似、但仅作用于第
 个块的逆向扩散过程
- 将式(3)中的负证据下界(NELBO)分别应用于式(4)的各项,即可得到一个具有理论依据的学习目标
- 其中,每个
 都是将式(3)应用于
 所得到的实例。由于模型以
 为条件,在
 中显式标明其对和
 的依赖。将这些项的总和记为
 ,它本身也是一个有效的负证据下界
模型架构:使用单个神经网络 ,对这个基础去噪模型
 进行参数化。神经网络不仅输出概率,还输出用于高效训练的中间计算结果。这使能够以节省内存的方式,并行计算全部个块的损失
- 使用带有块因果注意力掩码的 Transformer 来参数化。该 Transformer 处理个 token ,其中,第个块中的 token 可以关注第 1 至第个块中的 token 。训练得到的
 根据含噪块
 和干净的历史块,输出第个块中个 token 的去噪预测
- 在自回归生成中,通常会缓存此前已生成 token 的键和值,以避免每一步都重新计算。类似地,用
 和
 表示第个块的键和值,并使支持将它们作为输入和输出。的完整输入输出接口为
- 其中,
 是对干净块的预测,和是前向传播过程中产生的键值缓存;
 和
 则是在对执行的前向传播时缓存的键和值。因此,以为输入,与以、为输入是等价的
高效训练与采样算法:理想情况下,希望仅通过的一次前向传播,就计算出损失。然而,对进行去噪,需要以这一含噪输入执行一次前向传播;而对后续块进行去噪,则需要在该块的干净版本上运行。因此,每个块都必须至少经过模型两次
- 训练:基于这一观察,提出满足上述最低计算需求的训练算法。具体而言,首先对完整序列执行一次前向传播,预先计算键和值
 、
 ,即
 。随后,使用
 计算所有块的去噪预测。每个 token 经过两次
- 向量化训练:一种朴素实现是循环次,分别调用来计算 logits。将含噪数据与干净数据拼接为
 ,通过一次前向传播计算。其中,含噪数据
 由对每个块分别施加噪声水平
 得到。为设计注意力掩码,使含噪 token 能够关注同一块中的其他含噪 token ,以及所有先前块中的干净 token
import torch
def block_diff_mask(b, h, q_idx, kv_idx, block_size, n):
    x0_flag_q = (q_idx >= n)
    x0_flag_kv = (kv_idx >= n)
    block_q = torch.where(x0_flag_q == 1, (q_idx - n) // block_size, q_idx // block_size)
    block_kv = torch.where(x0_flag_kv == 1, (kv_idx - n) // block_size, kv_idx // block_size)
    block_diagonal = (block_q == block_kv) & (x0_flag_q == x0_flag_kv)
    offset_block_causal = (block_q > block_kv) & (x0_flag_q == 0) & (x0_flag_kv == 1)
    block_causal = (block_q >= block_kv) & (x0_flag_q == 1) & (x0_flag_kv == 1)
    return block_diagonal | offset_block_causal | block_causal
from torch.nn.attention.flex_attention import flex_attention, create_block_mask
from functools import partial
my_block_diff_mask = partial(block_diff_mask, n=seq_len, block_size=block_size)
block_mask = create_block_mask(
    my_block_diff_mask, None, None, seq_len * 2, seq_len * 2, device=device
)
@torch.compile(fullgraph=True, mode="max-autotune-no-cudagraphs")
def single_pass_block_diff_attn(q, k, v, block_mask):
    return flex_attention(q, k, v, block_mask=block_mask)
- 采样:以前面已经采样得到的块为条件,每次采样一个块。可以采用任意采样过程
 ,从条件分布
 中采样。其中,通过与预先计算的键和值、执行交叉注意力,实现上下文条件化。与自回归模型类似,缓存键和值可以避免在采样新块时重新计算这些结果,从而节省计算。值得注意的是,块扩散解码算法能够采样生成任意长度的序列,而扩散模型通常受限于固定长度生成。此外,块扩散采样器支持在每个块内部并行生成,而自回归采样器只能逐 token 生成
🧮 Training and Sampling Algorithms
🌿 Understanding Likelihood Gaps Between Diffusion & AR Models
当前最有效的扩散语言模型采用掩蔽加噪过程,在这一过程中, token 被逐步替换为特殊的掩码 token 。本节介绍掩蔽式 BD3-LMs,这是一类基于掩蔽扩散语言建模框架的特殊块扩散模型
- 更形式化地,对于位置上的 token ,采用逐 token 加噪过程
 ,其中,
 是掩码 token 的独热编码,
 是关于
 严格递减的函数,且满足
 、

- 采用线性调度, token 在时间被掩蔽的概率为
 。采用 Sahoo et al.(2024a)、Shi et al.(2024)和 Ou et al.(2025)提出的简化目标
- 其中,
 表示将式(3)通过
 推广至连续时间后,
 的瞬时变化率。当
 、采用 SUBS 约束且不显式输入时间步时,负证据下界是紧的;对于更大的块,尤其当
 时,通常仍存在变分间隙;不同块大小对应不同模型,不能仅由 NELBO 形式推出跨模型的严格单调关系
单 token 生成:在且去噪网络不显式输入时间步、满足 SUBS 约束时,块扩散目标,即式(8),在期望意义上等价于自回归负对数似然,即式(1)。然而,当在 LM1B 数据集上分别训练块大小为 1 的块扩散模型和自回归模型时,发现二者之间仍存在两个困惑度点的差距
- 尽管这两个目标在期望意义上等价,剩余的困惑度差距源于较高的训练方差。自回归模型使用全部个 token 的交叉熵进行训练,而块大小为 1 的块扩散模型仅对被掩蔽的 token 计算交叉熵,即满足
 的 token ,其中,
 。因此,使用扩散目标进行训练时,用于估计损失梯度的 token 数量减少一半,这导致其训练方差高于自回归模型
- 为消除这一似然差距,在训练块大小为 1 的 BD3-LM 时,将前向过程设计为完全掩蔽 token ,即
 。在这一调度下,扩散目标变为与自回归目标等价
高方差训练导致的扩散模型差距:基于对单 token 生成的实证观察,提出一个梯度方差估计量,并利用它最小化块大小 时扩散模型训练的方差
- 尽管 NELBO 对噪声调度的选择具有不变性,但这一不变性并不适用于训练过程中使用的蒙特卡洛损失估计量。因此,该估计量及其梯度的方差均依赖于噪声调度
- 首先,给出批量大小为
 时的 NELBO 估计量。将一批序列记为
 ,其中,各个
 独立同分布地采样自。由此得到如下批量 NELBO 估计量,其中,
 表示为第
 条序列的第个块采样的时间步
- 对于
 个批次
 ,其中
 ,梯度估计量的方差可估计为
🍀 Low-Variance Noise Schedules for BD3-LMs
避免极端的掩蔽比例:目标是找到能够最小化梯度估计量方差的噪声调度,从而使训练尽可能高效。在掩蔽式建模中,希望随机掩蔽不同数量的 token ,使模型学会消除不同程度的噪声,这对于采样过程至关重要
- 如果仅掩蔽极少量 token ,重建这些 token 就会非常容易,无法提供有价值的学习信号
- 如果将全部 token 掩蔽,最优的重建结果则是数据分布中各个 token 的边缘分布,这同样容易学习,也无法提供有价值的学习信号。这些极端的掩蔽比例会产生质量较差、方差较高的梯度。因此,希望通过一类简单而有效的新型调度,学习如何截除这些极端情况
用于低方差梯度的截断调度:提出一类截断(clipped)噪声调度,从均匀分布 中采样掩蔽比例,其中

- 训练时先在单位区间采样时间变量,再将它映射到指定的掩蔽比例区间:
 ,令
 。因此,关于采样变量线性变化,且

面向不同块大小的数据驱动截断调度:由于最优掩蔽比例可能随块大小而变化,在训练过程中自适应地学习噪声调度
- Kingma et al. 利用其平方形式的扩散损失,分离出方差项并对其进行最小化。然而,这一策略无法直接应用于式(10)中的方差估计量,因为不仅希望降低随机时间步带来的方差,还希望降低随机批次带来的方差
- 因此,转而优化参数
 和
 ,以直接最小化训练方差。为限制这一优化过程的计算负担,使用扩散 ELBO 估计量的方差,作为梯度估计量方差的代理指标,并据此优化和。在训练过程中定期进行网格搜索,以找到最优的和
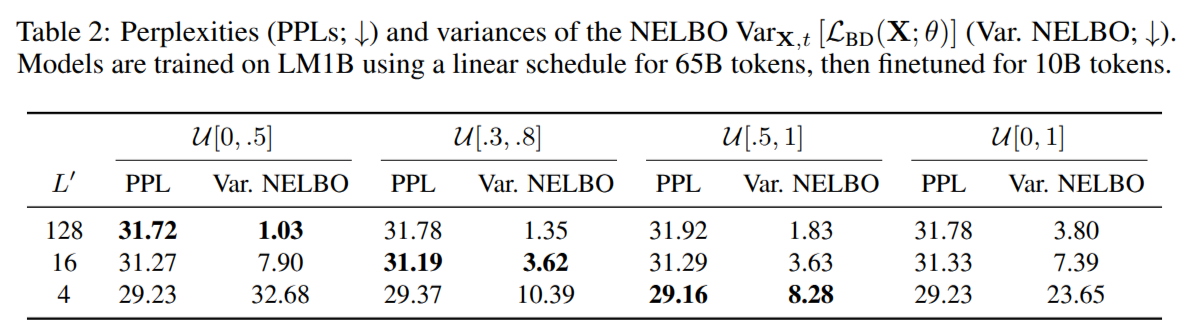
- 扩散 NELBO 的方差与测试困惑度具有相关性。在一系列截断噪声比例分布下,发现,对于每个块大小
 ,均存在一个唯一的分布,能够同时最小化 NELBO 的方差和测试困惑度
🧮 Proofs
Block Diffusion 将来自数据分布
- 为简化记号,将序列记为
。以 表示 Kullback–Leibler 散度, 、 分别表示 和 ,其中 。附录 A 给出的推导为
掩码块扩散以掩码扩散语言模型为基础,采用 Austin 等提出的掩码过程;前向过程通过扩散矩阵逐 token 加噪,逆向后验由相应的前向概率得到
- 对状态
定义扩散矩阵 。噪声调度 随 严格递减,满足 、 。以 表示掩码索引,扩散矩阵为
- 前向边缘分布对应的扩散矩阵
为下式,其中
- 在 D3PM 框架下,前向加噪过程独立作用于每个 token
,并通过扩散矩阵 定义为
- 利用前向边缘分布的扩散矩阵,可以得到逆向后验
。其中, 表示两个向量的 Hadamard 积
掩码扩散的 NELBO 可以通过 SUBS 参数化简化:将掩码类别的预测概率设为零,并直接保留已经解掩码的 token,最终得到交叉熵项的加权平均
- 以下沿用 Sahoo 等、Shi 等和 Ou 等的推导,先简化式(A.1)中的扩散损失
。由于扩散过程中的状态只有 ,SUBS 对去噪模型施加两项约束:干净序列不含掩码,因此令 ;若 ,真实后验满足 ,因此令 - 由此,只需近似
。令 表示第 个块中第 个位置的 token,扩散损失为
- 上式中的
是第 个块的离散时间扩散损失,第三步采用 Sahoo 等附录 B.1 的结果。令扩散步数 ,以获得更紧的似然近似;此时原文使用 ,得到
- 在连续时间情形下,Sahoo 等附录 A.2.4 表明,
,重建损失因此化为零
- 先验损失
也化为零,因为 保证 且 。最终,目标简化为交叉熵项的加权平均
- 上述 NELBO 不随噪声调度
的选择而改变,相关推导见 Sahoo 等附录 E.1.1
当块大小为
- 采用
、 ,再展开关于前向分布的期望,可得
- 去噪模型采用 SUBS 参数化。由于已经解掩码的 token 直接从输入复制到输出,
。再利用 ,式(A.10)化为
NELBO 的紧性部分比较不同块大小下的目标,原文给出的结论为:对
- 先考虑
,此时恢复自回归负对数似然。原文式(22)写为
- 当块大小为
时,原文式(23)为
- 原文先比较
与 ,再通过归纳推广到所有 。令 表示第 个块中第 个位置的 token,原文式(24)的推导为
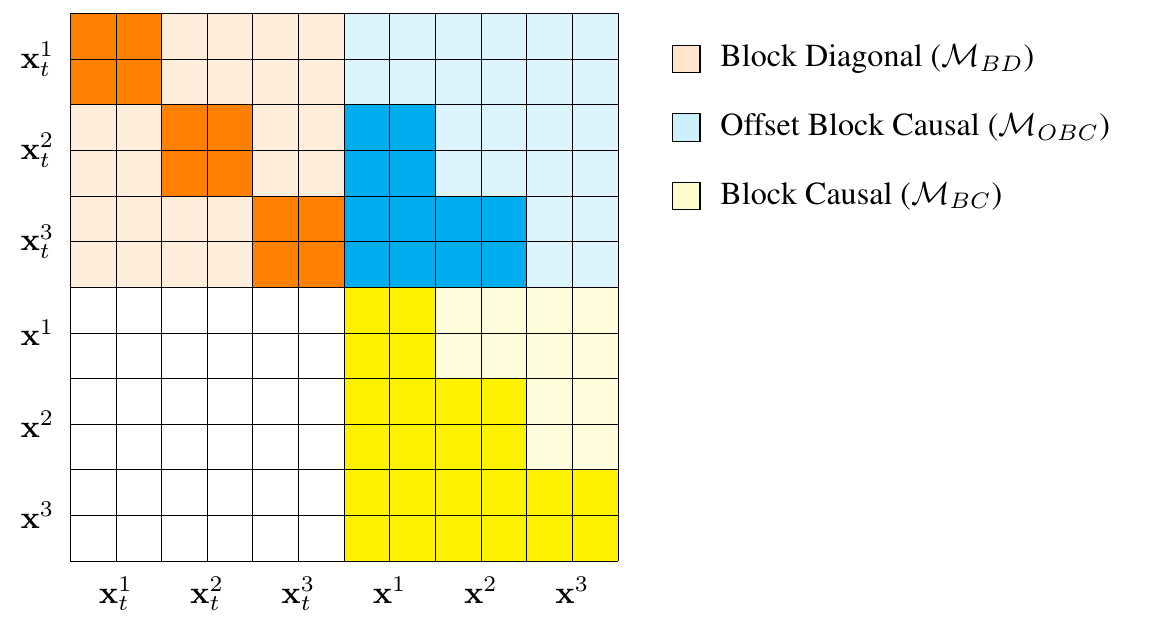
专门设计的注意力掩码将含噪序列与干净序列拼接,使 Transformer 在一次前向传播中同时建模全部块的条件概率
- 对所有
建模,需要同时处理含噪序列 和条件上下文 。将两条序列拼接为 并输入 Transformer,便可同时处理二者,无需调用去噪网络 次 - 拼接序列包含
个 token,采用自定义注意力掩码 更新其表示。完整掩码由四个 子矩阵构成
与 用于更新 的表示, 用于更新 的表示。块对角掩码 对应含噪块 内的自注意力
- 偏移块因果掩码
对应对条件上下文 的交叉注意力
- 块因果掩码
用于更新 ,允许访问当前块及更早的块
- 图 3 展示序列长度
、块大小 时的注意力掩码示例