Policy Optimization III
🔮 Monolithic Preference Optimization without Reference Model
指令微调训练模型遵循以自然语言描述的任务指令,使其能够较好地泛化至此前未见过的任务。然而,尽管模型具备遵循指令的能力,仍可能生成有害或不符合伦理规范的内容
- 为使这些模型进一步与人类价值观对齐,需要利用成对偏好数据进行额外训练,例如采用基于人类反馈的强化学习或直接偏好优化
- 现有偏好对齐方法通常采用多阶段训练流程,需要额外的参考模型以及独立的监督微调预热阶段,从而带来额外的资源开销
作者提出一种新的对齐方法——优势比偏好优化(Odds Ratio Preference Optimization,ORPO)。该方法在 SFT 过程中引入惩罚项,引导模型避免学习不期望的生成风格。相较于既有方法,ORPO 具有以下改进
- 既不需要参考模型,也不需要独立的 SFT 阶段;实际训练中的计算量不足既有方法的一半
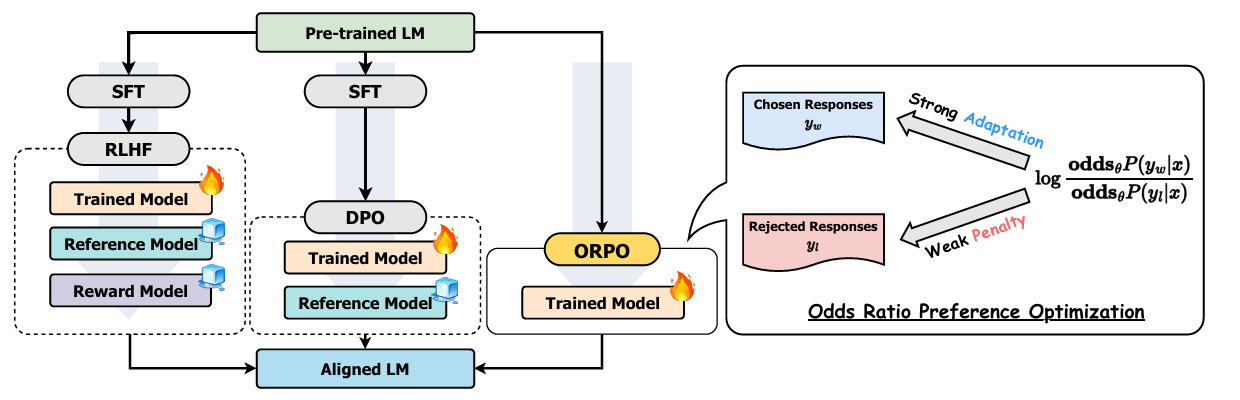
🐉 Odds Ratio Preference Optimization
ORPO 在传统监督微调损失,即负对数似然损失中,引入基于优势比的惩罚项,以区分偏好回答与非偏好回答的生成风格
给定语言模型 和输入序列
 ,模型生成输出序列
 的平均对数似然计算如下
根据偏好回答与非偏好回答这两类结果的似然,使用几率对偏好进行建模。这一设计旨在刻画偏好的二元性,而优势比正适用于此类情形
- 记
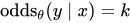 。这里的
 是沿回答的 token 概率的几何平均值,
 是据此构造的几率分数。因此,偏好回答
 相对于非偏好回答
 的优势比定义为
RLHF 方法通常利用 SFT 来确保当前策略能够稳定更新,并将 SFT 模型用作参考策略。即使在不采用强化学习的对齐方法中,SFT 对于使模型收敛至预期结果至关重要。具体而言,SFT 使用交叉熵损失,在模型对参考答案预测的 logits 较低时对其施加惩罚
- 其中,
 为布尔值,用于指示词表
 中的第
 个 token 是否为标签 token;
 表示第个 token 的概率;
 为回答长度。在每个监督位置,所有词表 logits 都通过 softmax 归一化参与梯度计算;即使某个非标签 token 对应的为 0,其 logit 仍会收到概率项贡献的梯度
- 尽管交叉熵通常能够有效实现领域适配,但它不会显式比较同一输入下的偏好回答与非偏好回答。由于回答之间共享 token 和模型参数,在强化偏好回答时,非偏好回答的似然也可能上升
惩罚不期望的生成内容。在损失中加入非似然惩罚,已被证明能够有效减少模型中不期望的退化生成行为。例如,为避免重复生成,可以针对先前上下文中的不期望 token 集合 ,在损失中加入
 项,从而惩罚模型对近期出现的 token 赋予较高概率的行为
- 受到 SFT 会为非偏好 token 赋予较高概率这一现象,以及通过附加惩罚项抑制不期望生成行为的有效性的启发,作者设计一种一体化偏好对齐方法。该方法能够针对每个查询动态惩罚非偏好回答,而无需人工构造应被拒绝的 token 集合
对于三元组 ,ORPO 的目标函数由两个部分组成:监督微调损失
 ;优势比损失

- 最大化参考 token 的生成似然,则用于最大化偏好回答相对于非偏好回答的生成优势比
- 通过使用
 对项进行加权,可以使预训练语言模型适应目标领域中的特定子集,同时抑制其生成非偏好回答集合中的内容
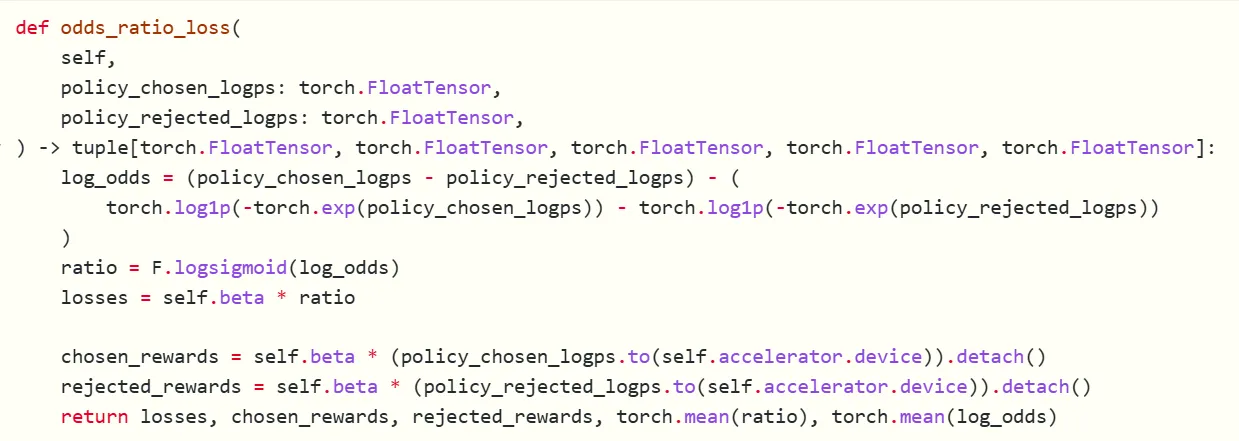 TRL · ORPOTrainer.odds_ratio_loss(偏好项,合并时从 NLL 中减去) · GitHub
梯度分析:最小化时,负梯度给出下降方向,可写为两个部分的乘积
 对模型的错误预测施加惩罚,而
 则对偏好回答与非偏好回答进行对比
- 当偏好回答的几率相对于非偏好回答更高时,将趋近于 0。发挥着惩罚项的作用:当模型更倾向于生成非偏好回答时,它会加快参数更新
- 表示偏好回答与非偏好回答对应梯度之间的加权对比。具体而言,当某一侧的似然
 较高时,分母中的
 会放大该侧的梯度。对于偏好回答,随着其似然增大,这一机制将加快模型向偏好回答分布的适配
🧚 KTO Model Alignment as Prospect Theoretic Optimization
利用人类反馈对生成模型进行对齐,已被成功用于提升生成内容的有用性、事实准确性和伦理合规性等方面的表现
- RLHF 和 DPO 等对齐方法已被反复证明优于仅进行监督微调。然而,尽管人类反馈可以采取多种形式,例如针对给定输入,对输出表示认可或不认可,现有讨论却往往仅关注偏好形式的反馈,例如对于输入,输出之间存在偏好关系

- 尽管偏好数据在实践中相对稀缺且采集成本较高,目前被证明效果最好的对齐方法——RLHF和 DPO,都依赖此类数据
作者从前景理论的视角重新审视模型对齐。前景理论解释人类在面对不确定事件时,为何会作出不以期望值最大化为目标的决策。该理论以形式化方式刻画人类如何以存在偏差但具有明确规律的方式感知随机变量
- 相对于某个参考点,人类对损失的敏感程度高于对收益的敏感程度,这一特性被称为损失厌恶(loss aversion)
- DPO 和 PPO-Clip 等常用对齐方法隐式地建模其中的一些偏差,从而能够从所用数据之外的角度解释这些方法的有效性。在此基础上,提出一类更一般的损失函数,称为人类感知损失(human-aware losses,HALOs)
- 尽管无法一概断言 HALOs 必然优于非 HALO 损失,在现有方法中,符合 HALO 定义的方法通常比不符合该定义的方法表现更好
为采用更具理论依据的方法,作者利用 Kahneman 和 Tversky 提出的人类效用模型,推导出一种 HALO。该效用模型最初用于描述人类如何针对不确定的金钱收益结果作出决策
- 将这一方法称为卡尼曼—特沃斯基优化(Kahneman-Tversky Optimization,KTO)。与当前大多数方法最大化偏好的对数似然不同,KTO 直接最大化生成结果的效用。KTO 仅需要一个二元信号,用于指示给定输入下的某个输出是否符合期望
- KTO 的设计初衷是:即使模型只能从较弱的监督信号中学习,也可以通过实际应用中能够获取的更大规模数据来弥补
🎨 A Prospect Theoretic View of Alignment
前景理论视角下的模型对齐:前景理论解释人类在面对不确定事件时,为何会作出不以期望值最大化为目标的决策。在前景理论中,人类效用取决于价值函数和权重函数
- 价值函数
 将结果
 相对于某个参考点
 的变化映射为其感知价值,即主观价值。例如,这类函数能够刻画以下现象:相比于同等幅度的相对收益,人类通常对相对损失更加敏感
- 权重函数
 是容量函数的导数,该容量函数将累积概率映射为感知到的累积概率。记
 为赋予结果的权重
- 随机变量
 的效用是其各个可能结果的函数:
 Tversky 和 Kahneman 通过向受试者提供涉及金钱的赌博方案,并询问其确定性等价额,提出以下人类价值函数形式
 控制函数的曲率,反映风险厌恶程度;控制函数的陡峭程度,反映损失厌恶程度。价值函数的主要特征包括:存在一个用于确定相对收益或损失的参考点;在相对收益区间内具有凹性,即随着结果远离参考点,敏感性逐渐降低;以及具有损失厌恶特性,即对损失更加敏感
HALOs 是能够体现 Tversky 和 Kahneman 所提出的人类决策模型的一类损失函数。设 表示待对齐模型
 的可训练参数,
 为参考模型,
 为归一化因子,
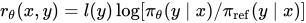 为隐含奖励
- 对于函数
 ,若存在定义在
 上的参考点分布
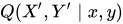 ,以及一个处处单调不减、在
 上为凹函数的价值函数
 ,使得
 是下述量的线性函数,则称为人类感知损失
 以 nat 为单位,表示从转变为时,经过
 归一化的条件自信息量的减少量。定义来源于大语言模型预训练和微调所采用的下一 token 预测目标。随着逐步完成对齐,符合期望的输出所对应的越来越趋向正值,而不符合期望的输出所对应的越来越趋向负值
- HALO 中的参考点是从人类视角出发的期望奖励,其中,描述被视为基线的样本。要求价值函数在收益区间内为凹函数,但不要求它在损失区间内一定为凸函数。这与经典的 Kahneman–Tversky 价值函数有所不同,因为少数个体在收益和损失两种情形下都表现出风险厌恶,从而使价值函数在整个定义域上均呈凹性
🍎 Kahneman-Tversky Optimization
作者基于 Kahneman–Tversky 人类效用模型推导出一种 HALO,从而直接优化生成结果的效用,而非最大化偏好的对数似然
- 由于幂指数的作用,式(1)中的经典 Kahneman–Tversky 价值函数在优化过程中存在数值不稳定问题。因此,作者使用逻辑斯蒂函数替代该函数
- 为控制风险厌恶程度,引入超参数
 ,并将其作为价值函数的一部分。
 越大,价值函数越快趋于饱和,这意味着人类在收益情形下更加厌恶风险,同时在损失情形下更加倾向于风险寻求
- 将原始 Kahneman–Tversky 价值函数中的损失厌恶系数替换为权重函数

- 默认情况下,
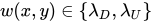 ,其中,
 和
 分别是用于控制符合期望与不符合期望样本对应损失的超参数
不再仅使用一个非偏好生成结果作为参考点,而是假设人类会相对于所有可能的输入—输出对来判断 的质量。将分解为数据集输入上的均匀先验,以及条件分布
 ,并令后者为。参考点可简化为 KL 散度
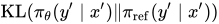 关于
 的期望
- 当符合期望时,令
 ;当不符合期望时,令
 。默认的 KTO 损失为
- 其中,隐含奖励为
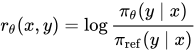 ,参考点为
- 价值函数为
- 为提高训练稳定性,不通过进行反向传播;它的作用仅在于控制损失的饱和行为
- KTO 根据隐含奖励相对参考点的差值调整更新:提高符合期望回答的相对奖励,降低不符合期望回答的相对奖励。参考点在每次反向传播中视为常数,并随后续批次重新估计;sigmoid 的饱和程度决定各样本的梯度大小
在实践中,直接按照上述定义估计并不可行,因为从中采样的速度较慢,而且人类也无法感知所诱导的完整分布
- 如果根据人类实际持有的信念来计算期望奖励,就会得到 KL 项的有偏估计。人类存在可得性启发式,会对自己已经提供过反馈的输出赋予过高的权重,而不论这些输出是否构成输入的良好续写。为更好地模拟人类感知到的参考点,构造组一一错配的样本对
 ,其中,
 与
 来自同一个大小为的离线数据批次,批大小至少为 2,每个输入仅匹配一个其他样本的回答,并满足
 。据此,将估计为
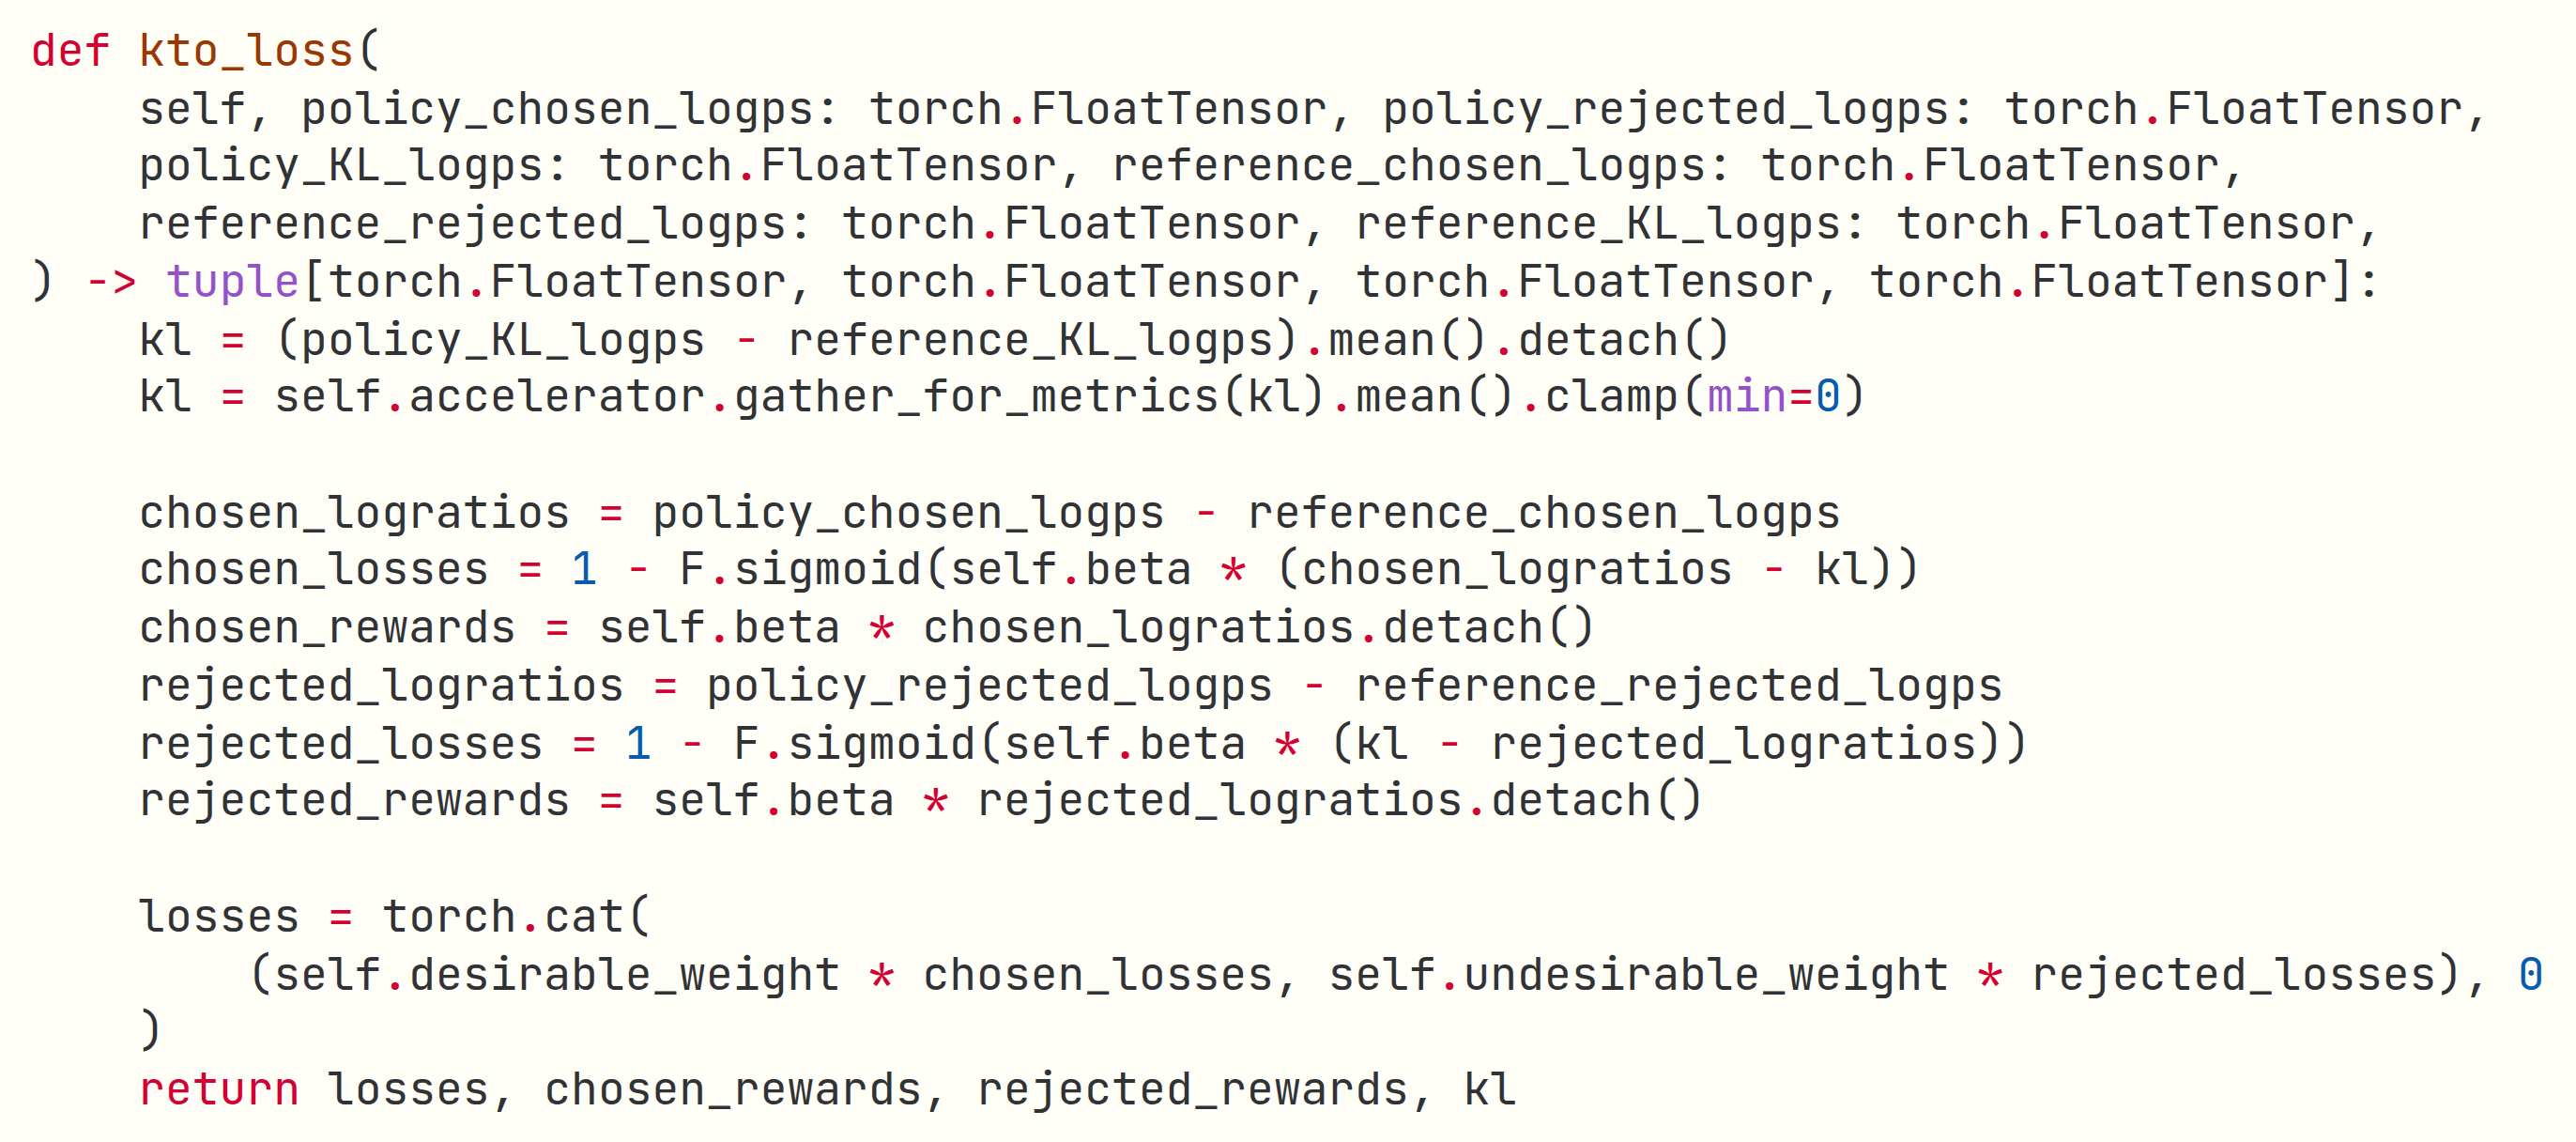 TRL · KTOTrainer.kto_loss(标准 KTO 分支) · GitHub
🍃 SimPO: Simple Preference Optimization with a Reference-Free Reward
基于人类反馈的强化学习是一种广泛采用的语言模型微调方法,旨在实现有效的模型对齐。尽管经典的 RLHF 方法已取得显著成效,但其多阶段训练流程也带来优化上的挑战:首先需要训练奖励模型,随后再优化策略模型,以最大化该奖励
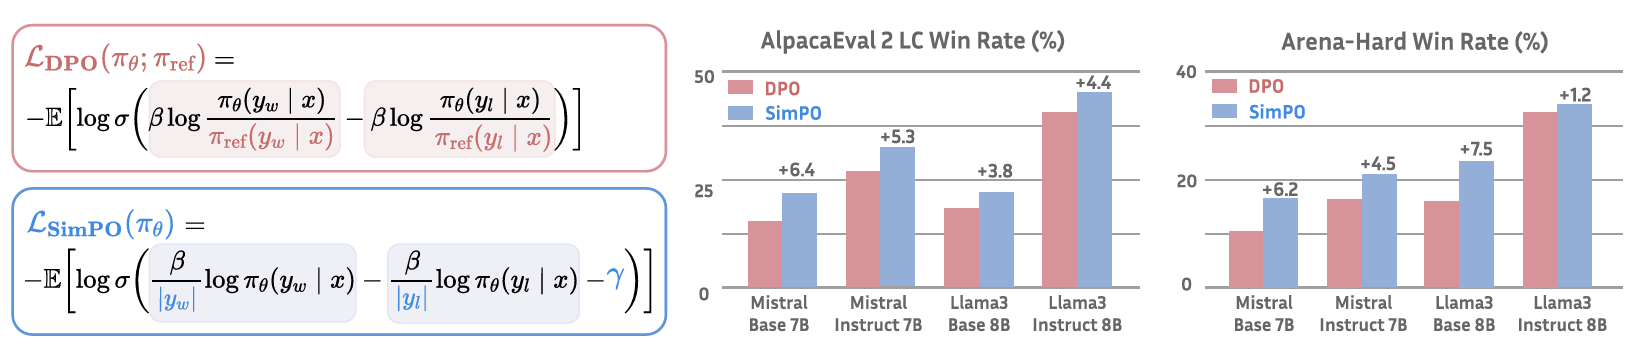
- 研究者开始探索更为简洁的离线算法,直接偏好优化便是其中之一。DPO 对 RLHF 中的奖励函数进行重参数化,直接利用偏好数据学习策略模型,从而无需显式的奖励模型
- 在 DPO 中,隐式奖励通过同一回答在当前策略模型与监督微调模型下的似然比的对数来构造。然而,这种奖励形式并未与用于指导生成过程的指标直接保持一致;后者可近似表示为策略模型生成回答的平均对数似然。作者推测,这种训练与推理之间的不一致可能导致次优性能
本文提出 SimPO,一种简单而有效的离线偏好优化算法。该算法的核心在于,使偏好优化目标中的奖励函数与生成阶段所使用的指标保持一致。SimPO 包含两个主要组成部分:长度归一化奖励,即利用策略模型计算回答中所有 token 的平均对数概率;目标奖励间隔,用于鼓励偏好回答与非偏好回答之间的奖励差值超过该间隔
- SimPO 无需参考模型,相较于 DPO 等方法更加轻量且易于实现
- 相较于 SFT 或 DPO,SimPO 的性能提升未伴随回答长度显著增加,表明其较少利用长度偏置
🍀 SimPO: Simple Preference Optimization
DPO 是最广泛使用的偏好优化方法之一。DPO 无需学习显式的奖励模型,而是利用包含最优策略的闭式表达式,对奖励函数 进行重参数化
- 其中,
 为策略模型,为参考策略,通常采用监督微调模型,
 为配分函数。将这一奖励形式代入 Bradley–Terry(BT)排序目标,即
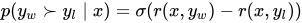 ,DPO 便可通过策略模型而非奖励模型来表示偏好数据的概率,从而得到以下优化目标
- 其中,
 表示偏好数据集
 中的成对偏好样本,由提示、偏好回答和非偏好回答构成
隐式奖励存在以下不足:训练过程中需要参考模型,从而引入额外的内存开销和计算成本;训练阶段所优化的奖励与推理阶段所优化的对数似然并不一致,而推理阶段并不涉及参考模型
- 在 DPO 中,对于任意三元组,满足奖励排序
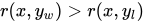 ,并不必然意味着满足似然排序
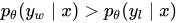
按序列长度归一化奖励,可减轻对数概率累加引入的长度偏置。一种解决方案是将所有 token 的对数概率之和作为奖励,但这种方式存在长度偏置
- 较长的序列往往具有更低的对数概率。当比更长时,将对数概率之和作为奖励进行优化,会迫使模型人为抬高较长序列的概率,以确保获得高于的奖励。这种过度补偿会增加生成退化的风险。为解决这一问题,考虑将平均对数似然作为隐式奖励
- 这一指标通常用于对束搜索中的候选序列以及语言模型多项选择任务中的候选选项进行排序。考虑使用
 替代 DPO 的奖励形式,使其与指导生成过程的似然指标保持一致,由此得到经过长度归一化的奖励
- 其中,是控制奖励差值缩放幅度的常数。按照回答长度对奖励进行归一化至关重要:从奖励形式中移除长度归一化项,会导致模型倾向于生成更长但质量更低的序列。这一奖励形式无需参考模型,因此相较于依赖参考模型的算法,具有更高的内存使用效率和计算效率
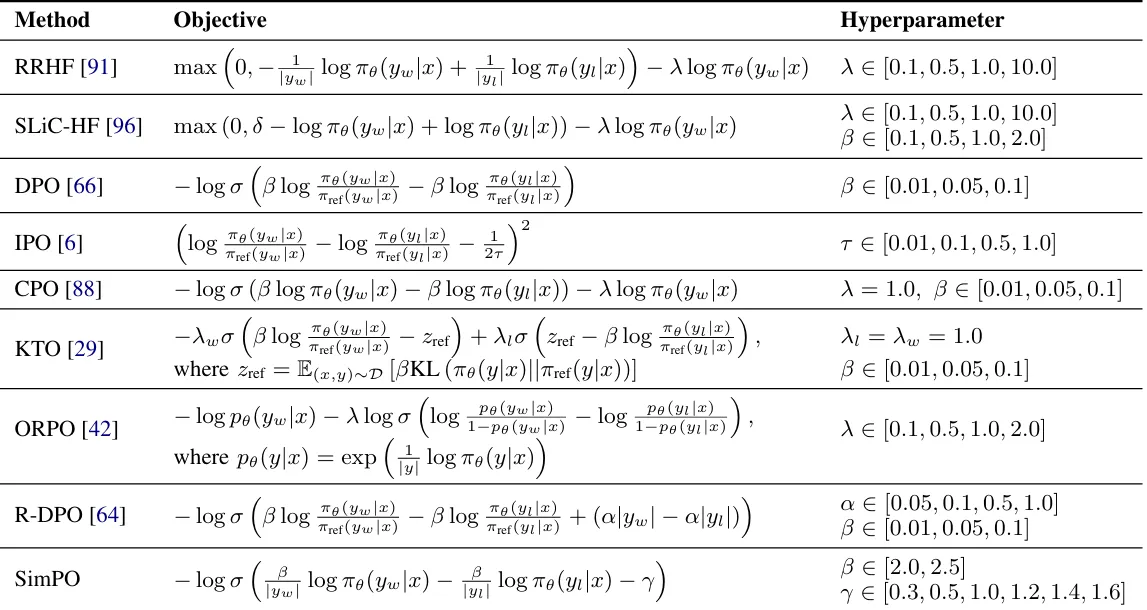
目标奖励间隔:在 Bradley–Terry 目标中引入 ,鼓励偏好回答的奖励
 至少比非偏好回答的奖励
 高出

- 两个类别之间的间隔会影响分类器的泛化能力。在采用随机模型初始化的标准训练设置中,增大目标间隔通常能够改善泛化性能
- 在偏好优化中,这两个类别分别对应同一输入下的偏好回答和非偏好回答。随着目标间隔增大,生成质量最初会有所提升,但当间隔过大时,生成质量反而会下降
SimPO 采用一种与生成指标直接保持一致的隐式奖励形式,从而无需参考模型。此外,SimPO 还引入目标奖励间隔,以帮助区分偏好回答与非偏好回答
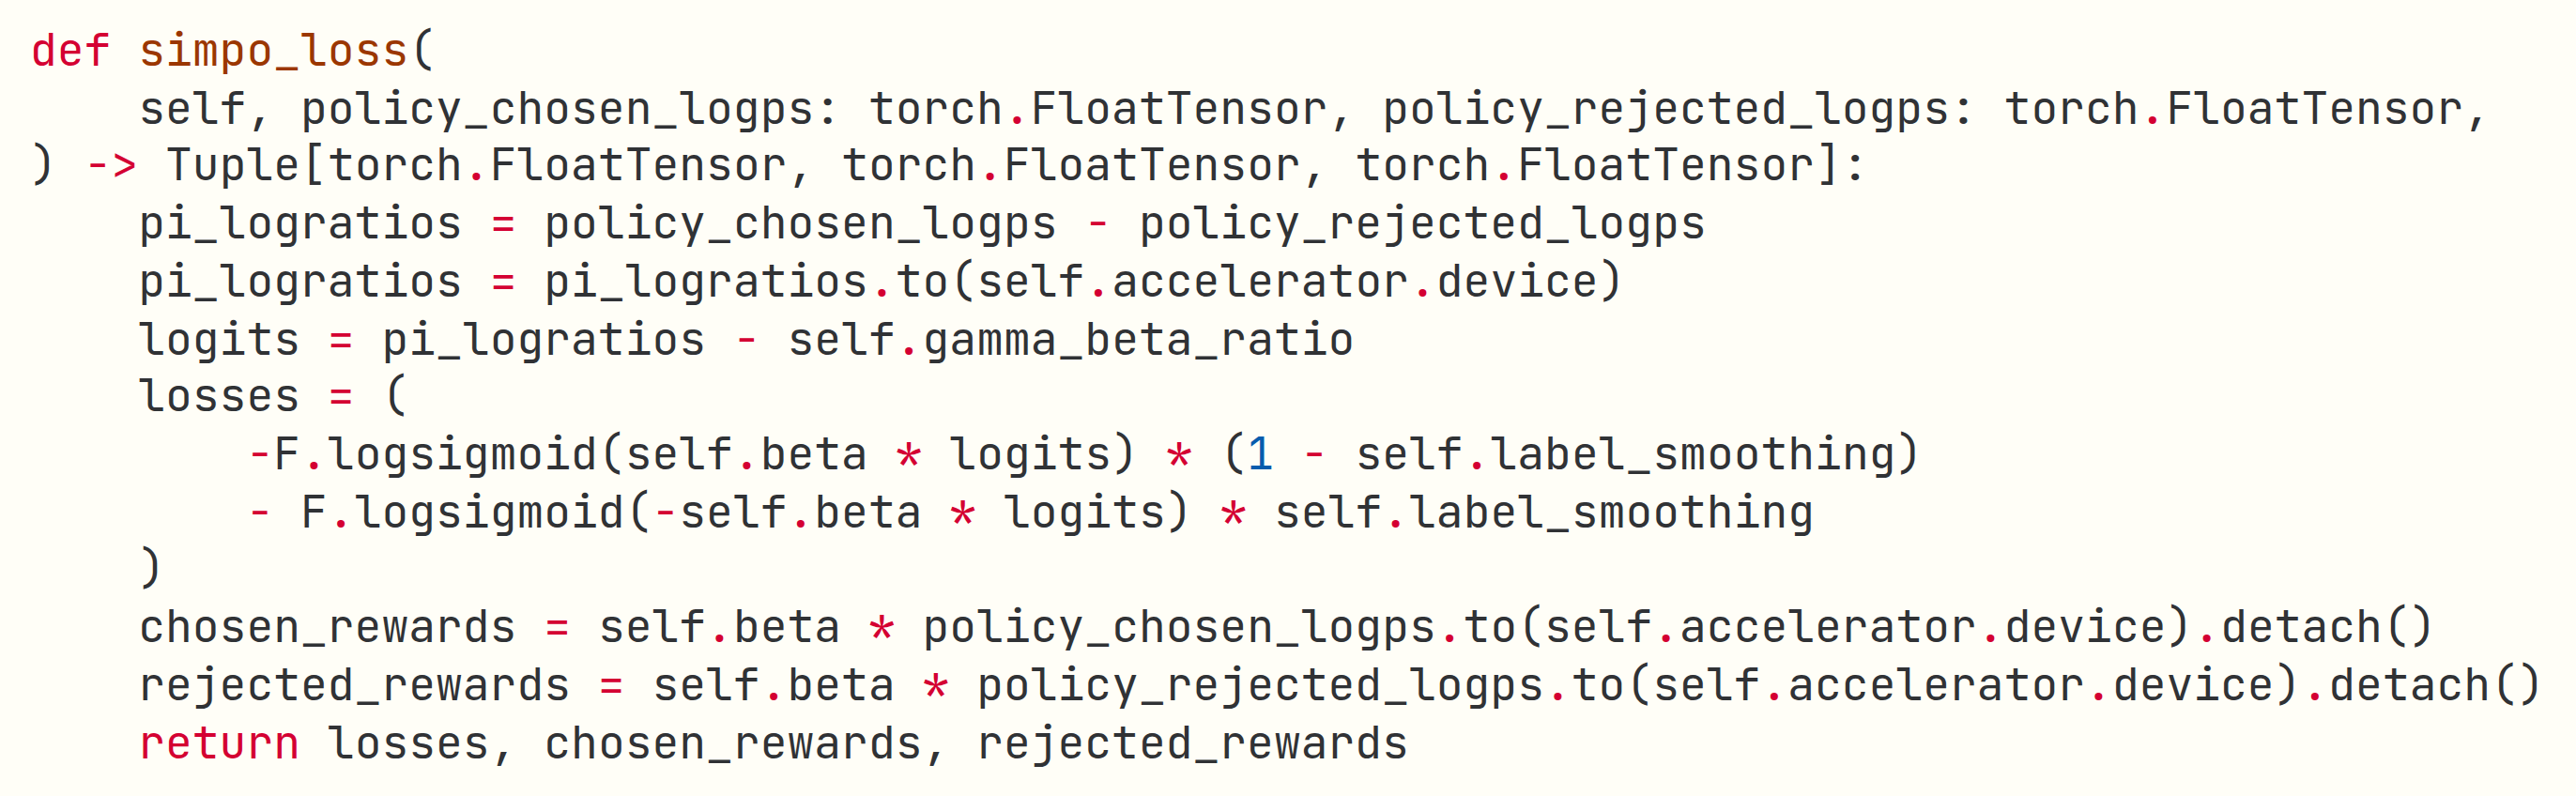 SimPO · SimPOTrainer.simpo_loss(sigmoid,label_smoothing=0,gamma_beta_ratio=γ/β) · GitHub