Policy Optimization IV
🕊️ DAPO: An Open-Source LLM Reinforcement Learning System at Scale
以 OpenAI 的 o1 和 DeepSeek 的 R1 为代表的测试时扩展(test-time scaling),正在推动大语言模型的深刻范式变革。测试时扩展支持更长的思维链推理,并激发复杂的推理行为,使模型在 AIME 和 Codeforces 等数学竞赛与编程任务中表现出更强的能力。推动这一变革的核心技术是大规模强化学习,它能够激发自我验证和迭代改进等复杂推理行为
朴素的 GRPO 基线存在熵坍塌、奖励噪声和训练不稳定等若干关键问题。作者提出解耦裁剪与动态采样策略优化算法,并引入四项关键技术,以提升强化学习在长思维链场景中的表现
- 提高裁剪上界(Clip-Higher):提升系统的生成多样性,避免熵坍塌
- 动态采样(Dynamic Sampling):提高训练效率和稳定性
- Token 级策略梯度损失(Token-Level Policy Gradient Loss):在长思维链强化学习场景中发挥关键作用
- 超长回答奖励塑形(Overlong Reward Shaping):减少奖励噪声,稳定训练过程
🌈 Preliminary
PPO 引入用于策略优化的裁剪代理目标,通过裁剪抑制过大的策略更新,以稳定训练并提高样本效率。PPO 通过最大化以下目标来更新策略
- 其中,
 是来自数据分布
 的问答对,
 为重要性采样比率的裁剪范围,
 为时间步
 处的优势估计值。给定价值函数
 和奖励函数
 , 通过广义优势估计计算
GRPO 不再需要价值函数,而是以组内相对方式估计优势。对于给定的问答对,行为策略 采样生成一组包含
 个回答的集合
 。随后,通过对组内奖励
 进行标准化,计算第
 个回答的优势
- 与 PPO 类似,GRPO 采用裁剪目标,并直接加入 KL 惩罚项
- GRPO 在样本级别计算优化目标。具体而言,GRPO 首先计算每条生成序列内部的平均损失,再对不同样本的损失取平均
KL 惩罚项用于约束在线策略与冻结的参考策略之间的偏离程度。在 RLHF 场景中,强化学习的目标是对齐模型行为,同时避免模型过度偏离初始模型。然而,在训练长思维链推理模型时,模型分布可能显著偏离初始模型,因此 DAPO 移除 KL 惩罚项
使用奖励模型通常会面临奖励投机问题:直接将可验证任务中最终答案的正确性作为结果奖励
🍎 Decouple Clip and Dynamic sAmpling Policy Optimization
解耦裁剪与动态采样策略优化算法:对于每个与答案 配对的问题
 ,DAPO 采样生成一组输出,并通过以下目标优化策略
在最初采用朴素 PPO 或 GRPO 的实验中,作者观察到熵坍塌现象:随着训练推进,策略的熵迅速下降。某些组内采样得到的回答趋于高度一致。这表明模型的探索受到限制,策略过早趋于确定性,从而可能阻碍训练规模的扩展
- 提出 Clip-Higher 策略。PPO-Clip 对重要性采样比率进行裁剪,以抑制过大的策略更新并增强训练稳定性
- 裁剪上界可能限制策略的探索:提高利用型 token 的概率相对容易,而低概率探索型 token 的概率提升却受到过于严格的约束
- 按照 Clip-Higher 策略,将裁剪范围的下界参数与上界参数解耦,分别记为
 和
 ,保持
 不变,提高

当某些提示对应的准确率达到 时,现有强化学习算法会面临梯度减弱的问题。以 GRPO 为例,如果某个提示的所有输出均正确,并获得相同的奖励,那么该组的优势就会为零。零优势会产生零策略梯度,从而减小批次梯度的幅度,并提高其对噪声的敏感性,最终降低样本效率
- 意味着每个批次中的有效提示数量不断减少,可能导致更大的梯度方差,并削弱模型训练的梯度信号
- 提出过采样,并过滤准确率为和
 的提示。这样既能确保批次中的所有提示都提供有效梯度,也能保持提示数量一致。每个批次的采样成本是动态变化的。在进行训练之前持续采样,直到整个批次被准确率既不为、也不为的样本填满
- 这一策略并不一定会降低训练效率,因为当强化学习系统采用同步执行方式,且生成阶段未采用流水线时,生成耗时通常由长尾样本的生成过程所主导
原始 GRPO 算法采用样本级损失计算方式:首先对每个样本内部各 token 的损失取平均,再对不同样本的损失进行聚合。在这种方式下,每个样本在最终损失计算中具有相同的权重。这种损失归约方式在长思维链强化学习场景中会带来若干挑战
- 由于所有样本在损失计算中被赋予相同的权重,较长回答中的 token 对总体损失的贡献可能被不成比例地降低,从而产生不利影响
- 首先,对于高质量的长样本,这种效应可能妨碍模型学习其中与推理相关的模式。其次,过长的样本往往包含乱码和重复词语等低质量模式。因此,样本级损失计算无法有效惩罚长样本中的这些不良模式,进而导致熵和回答长度的不合理增长
- 为解决上述局限,在长思维链强化学习场景中引入 Token 级策略梯度损失
- 在这一设置下,相较于较短序列,较长序列能够对整体梯度更新产生更大的影响。此外,从单个 token 的角度来看,如果某种生成模式会导致奖励增加或减少,那么无论它出现在多长的回答中,都会受到同等程度的强化或抑制
在强化学习训练中,通常会设置最大生成长度,并据此截断超长样本。对截断样本进行不恰当的奖励塑形可能引入奖励噪声,并严重干扰训练过程
- 默认情况下,会对截断样本赋予惩罚性奖励。然而,这种做法可能向训练过程引入噪声,因为一个合理的推理过程可能仅仅由于长度过长而受到惩罚。这类惩罚可能使模型对自身推理过程的有效性产生混淆
- 为研究这种奖励噪声的影响,首先采用超长样本过滤策略,屏蔽截断样本的损失。这一方法能够显著稳定训练并提升性能
- 进一步提出软性超长惩罚。这是一种长度感知的奖励塑形机制:当回答长度超过
 时开始线性增加惩罚,到达
 时惩罚为 −1;超过该长度时保持为 −1。该惩罚叠加到基于规则的正确性奖励上,引导模型避免生成过长回答
🦦 Group Sequence Policy Optimization
强化学习已成为推动语言模型规模化发展的关键范式。通过大规模强化学习,语言模型能够开展更深入、更长的推理过程,从而获得解决竞赛级数学与编程等复杂问题的能力
- 要通过增加计算投入成功扩展强化学习,首要前提是维持稳定且稳健的训练动态。以 GRPO 为代表的当前先进强化学习算法,在训练超大规模语言模型时存在严重的稳定性问题,往往导致灾难性且不可逆的模型崩溃。这种不稳定性阻碍通过持续强化学习训练进一步拓展语言模型能力边界的进程
- GRPO 的不稳定性源于其算法设计中对重要性采样权重的根本性误用及其失效。这会引入高方差的训练噪声;随着回答长度增加,这些噪声逐渐累积,并被裁剪机制进一步放大,最终导致模型崩溃
为解决这些核心局限,提出组序列策略优化,一种用于训练大语言模型的新型强化学习算法。GSPO 的关键创新在于,基于序列似然,以具有理论依据的方式定义重要性比率,使其符合重要性采样的基本原理
- GSPO 将同一查询下多个回答的归一化奖励作为优势,确保序列级奖励与优化之间的一致性
- GSPO 从机制上解决大型混合专家模型强化学习训练中的稳定性问题,无需复杂的稳定化策略,并展现出简化强化学习基础设施的潜力
随着模型规模、稀疏性以及回答长度的增加,强化学习训练需要采用较大的采样批次规模,以最大化硬件利用率。为提高样本效率,通常会将一个大批次的采样数据划分为多个小批次,用于梯度更新。这一过程不可避免地引入离策略学习设定:回答 采样自旧策略,而非正在优化的当前策略

- 解释 PPO 和 GRPO 中裁剪机制的必要性:该机制用于防止偏离当前策略过大的样本参与梯度估计
- GRPO 存在一个更为根本的问题:其优化目标是不适定的。在面向长回答任务训练大型模型时,这一问题尤为突出,并会导致灾难性的模型崩溃
GRPO 优化目标的不适定性源于对重要性采样权重的误用。重要性采样的基本原理是对从行为分布 中抽取的样本进行重新加权,以估计函数
 在目标分布
 下的期望
- 这一过程依赖于对来自行为分布的多个样本取平均,才能使重要性权重
 有效校正分布失配
- 相比之下,GRPO 在每个 token 位置应用重要性权重
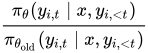 。由于这一权重仅基于从每个下一 token 分布
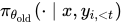 中抽取的单个样本
 ,因此无法发挥预期的分布校正作用
- 相反,它会向训练梯度中引入高方差噪声。这些噪声沿长序列不断累积,并被裁剪机制进一步放大
Token 级重要性权重的失效指向一项核心原则:优化目标的粒度应与奖励的粒度保持一致。由于奖励赋予的是整个序列,在 token 级别进行离策略校正便存在问题。这促使放弃 token 级优化目标,转而探索直接在序列级别应用重要性权重并执行优化
🐌 Group Sequence Policy Optimization
尽管 GRPO 中的 token 级重要性权重存在问题,但在语言生成场景中,序列级重要性权重 具有明确的理论含义
- 它反映从
 中采样得到的回答相对于
 的偏离程度。这与序列级奖励自然保持一致,也能够为裁剪机制提供有意义的判据
- 基于这一观察,提出组序列策略优化(Group Sequence Policy Optimization,GSPO)算法。下文的期望均对
 和
 计算,GSPO 采用以下序列级优化目标
- 并基于序列似然定义重要性比率

- 因此,GSPO 对整个回答进行裁剪,而非对单个 token 进行裁剪,以将偏离当前策略过大的样本排除在梯度估计之外。这同时与序列级奖励和序列级优化保持一致。需要说明的是,在中采用长度归一化,以降低方差,并将控制在统一的数值范围内
- 否则,少数 token 的似然变化就可能导致序列级重要性比率剧烈波动,而不同长度回答的重要性比率也将需要不同的裁剪范围。此外,由于重要性比率的定义不同,GSPO 与先前算法的裁剪范围通常存在数量级上的差异
梯度分析:省略裁剪后,GSPO 目标的梯度为
- 作为对比,令
 ,GRPO 在
 时的梯度为
GSPO 与 GRPO 的根本区别在于如何对各 token 的对数似然梯度进行加权
- GRPO 中,各 token 按照各自的重要性权重 进行加权。当
 时,未被裁剪截断的权重可在
![(0,1+\varepsilon]](assets/math/5502bebd3a1a92826b05dcb325558479.svg) 内变化;当
 时,可在
 内变化。这些不相等的权重影响不可忽略,并可能随着训练推进不断累积,产生难以预测的后果
- 相比之下,GSPO 对同一回答中的所有 token 赋予相同权重,从而消除 GRPO 中的这一不稳定因素
在多轮强化学习等场景中,可能希望以比序列级更细的粒度调整优势。引入 GSPO 的 token 级目标函数变体 GSPO-token,以支持按 token 分别设置优势
 表示仅保留数值、同时停止梯度传播,对应于 PyTorch 中的
detach操作。省略裁剪后,GSPO-token 的梯度为
- 注意,
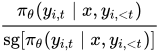 在数值上等于,因此
 与 在数值上相等。当同一回答内所有 token 的优势均满足
 时,GSPO-token 与 GSPO 在优化目标、裁剪条件和理论梯度上具有数值一致性,而 GSPO-token 在逐 token 调整优势方面具有更高的灵活性
🦨 Soft Adaptive Policy Optimization
在各类强化学习方法中,基于组的策略优化已成为一种切实可行的训练方案:针对每个查询采样多个响应,在组内对序列级奖励进行归一化,并利用当前策略与行为策略之间的重要性比率对策略更新进行加权
- 这一训练范式面临的核心挑战是 token 级重要性比率的高方差,尤其是在混合专家模型中,路由异质性与较长的响应可能进一步放大 token 间的偏差。这种高方差会增加更新不稳定的风险
- GRPO 采用的硬裁剪机制通过将固定区间之外的梯度置零来限制较大的偏离。尽管硬裁剪能够有效抑制过大的更新步幅,但它难以在稳定性与有效学习之间取得理想的权衡:过于严格的裁剪会限制可用于梯度计算的有效样本数量,而较为宽松的裁剪则会引入来自离策略样本的噪声梯度
为解决基于组的策略优化中硬裁剪机制的脆弱性,提出软自适应策略优化
- 一种平滑且具有自适应能力的策略梯度方法,使用温度控制的软门控替代硬裁剪。SAPO 使用一个以重要性比率为输入、以同策略点为中心的有界 S 形函数,对 token 级更新进行加权。由此形成一个连续的信赖域:在接近同策略状态时,保留梯度以鼓励有效更新与探索;随着比率逐渐偏离,梯度被平滑衰减而非直接截断,从而在减少优化噪声的同时,保留中等程度偏离所对应的学习信号
- 为进一步增强大词表场景下的鲁棒性,SAPO 对正、负优势 token 采用非对称温度,使负优势 token 的梯度衰减得更快。这一设计反映两类更新在稳定性方面的差异:负向更新往往会提高许多不合适 token 的 logits,因此比正向更新更容易引入不稳定性
从概念上看,SAPO 旨在兼具序列级一致性与 token 级自适应性
- 在温和且实践中常见的条件下,即同策略更新步长较小、序列内 token 对数比率的离散程度较低时,token 级门控的平均值会集中于一个平滑的序列级门控,从而使优化过程与序列级奖励保持一致,这与 GSPO 等基于序列的方法具有相同的基本思路
- 当 token 的异质性或异常 token 导致上述条件不再成立时,SAPO 会选择性地降低这些 token 的权重,同时保留同一序列中接近同策略状态的 token 所提供的有效梯度。这种选择性衰减能够减轻硬裁剪造成的信号损失,在保持更新稳定的同时提高采样效率
🐳 Soft Adaptive Policy Optimization
传统强化学习研究中已有对平滑门控函数的探索。在 SAPO 中,将这一思想引入面向大语言模型的基于组的强化学习范式,并在此基础上加入两个对大规模语言模型训练至关重要的组成部分:能够自然形成序列级一致性的 token 级软信赖域;基于正、负优势 token 更新行为差异的非对称温度设计
- 其中,
为 token 级重要性比率,同一回答共享组内归一化优势 。期望对查询 与回答组 计算
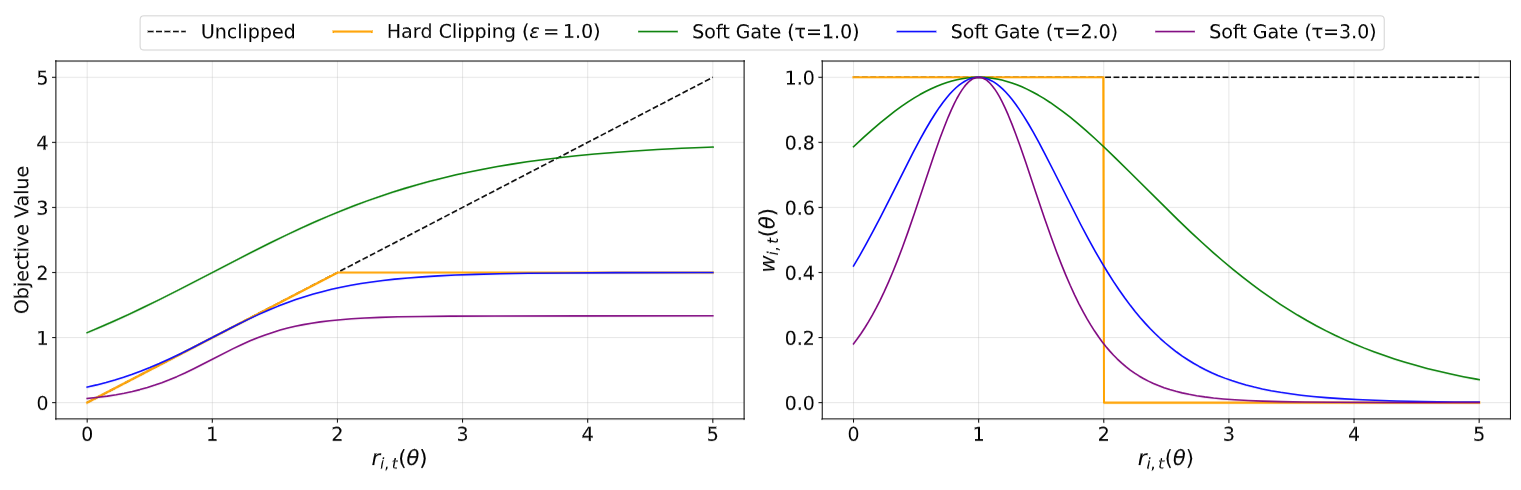
- 权重
 在
 时达到峰值,并随着
 偏离而以近似指数的形式平滑衰减,从而形成软信赖域,同时防止梯度消失和过大的更新。特别地,当时,无论
 取何值,软门控下的梯度均与未裁剪目标
 的梯度相同,从而保持同策略更新行为。这也解释为何在
 中引入
 这一因子
与 GSPO 和 GRPO 相比,SAPO 兼具序列级一致性与 token 级自适应性
- 在温和的假设下,即同策略更新步长较小、序列内 token 对数比率的离散程度较低时,token 级门控的平均值会集中于一个平滑的序列级门控
 。因此,SAPO 可归约为类似 GSPO 的序列级形式,但具有连续的信赖域
- 关键在于,当少数离策略 token 将
 推至 GSPO 的硬裁剪区间之外时,GSPO 会同时抑制该序列中大量接近同策略状态的 token 的梯度,从而降低样本效率。相比之下,SAPO 仅降低引起偏离的 token 的权重,同时使接近同策略状态的 token 继续发挥作用,从而保留有效梯度
- 相较于 GRPO,SAPO 避免将固定区间之外的梯度置零的 token 级硬裁剪,而是对更新进行平滑缩放,从而在保留有效学习信号与防止不稳定的策略偏移之间取得更好的平衡
超参数 控制衰减速率:其取值越大,衰减越快。尽管负优势 token 对探索和防止过拟合至关重要,但它们通常比正优势 token 引入更强的不稳定性
- 通过分析 token 级梯度如何经由 logits 传播来论证这一点。令
 表示 logits,其中词表大小为
 ;令
 表示一个 token,并通过 softmax 运算计算输出概率,即
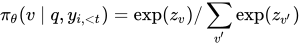
- 正优势会提高被采样 token 的 logit,并降低所有未被采样 token 的 logits;负优势的作用则相反,会提高大量未被采样 token 的 logits
- 大语言模型的强化学习微调中,动作空间是一个庞大的词表,通常包含数十万个 token,而给定状态下理想动作的数量却很少。因此,负向梯度会扩散至大量无关 token,虽然能够提供一定的正则化作用,但也会引发不稳定性,尤其是在离策略场景下
- 基于这一考虑,对正、负优势 token 使用不同的温度,并设置
 ,使负优势 token 的梯度衰减得更快,从而提高训练稳定性与性能
🍎 Gating Functions: SAPO, GRPO and GSPO
统一代理目标:用同一形式比较三种算法的门控函数
- 其中,
 是由具体算法决定的门控函数。进一步将经过长度归一化的序列级比率定义为 token 级比率的几何平均
算法对应的门控函数 :下文采用同一回答共享的优势,温度记为 
- GSPO 的在同一序列内不随 token 变化,而 SAPO 和 GRPO 的则依赖于具体 token
SAPO/GRPO 的梯度形式:对式(6)求导,并利用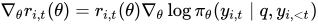 ,可得
SAPO 与 GSPO:从 token 门控到序列门控
- SAPO 的 token 级软门控:利用
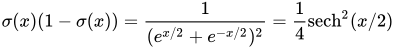 ,可得
采用以下两个假设
- (A1)小步长:
 。因此
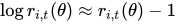
- (A2)序列内离散程度较低:令
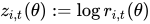 ,
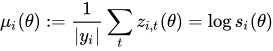 ,则对大多数序列而言,方差
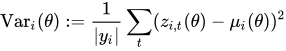 较小
在假设(A1)下,软门控可近似写为
平均 token 门控  序列门控:将平滑函数
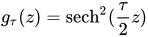 在
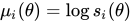 处作二阶泰勒展开,可得
- 其中,
 位于
 与
 之间。对各 token 取平均后,线性项相消
- 对于
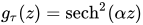 ,其中
 ,直接计算可得
- 因此,平均 token 门控可以由序列门控较好地近似,并满足如下统一误差界
- 从式(11)出发,并应用假设(A1)中的,可得
- 因此,在假设(A1)—(A2)下,SAPO 近似呈现与 GSPO 相似的序列级更新结构,其平滑门控为
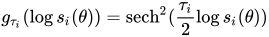
SAPO 与 GRPO:平滑门控和硬门控:对于 GRPO,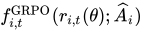 在未被裁剪的区间随比率线性变化,裁剪后为常数,因此其导数是分段常数
- 因此,GRPO 采用一个二值信赖域:位于域内的 token 获得与未裁剪目标相同的梯度,而位于域外的 token 的梯度为零
- 与 GRPO 相比,SAPO 使用平滑核函数
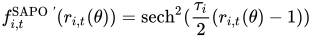 替代式中的硬指示函数,从而避免梯度消失,并使更新过程更加稳定。当策略比率的变化较小时,梯度保持较强的响应能力,允许较大的参数更新;随着偏离程度增大,梯度平滑收缩,从而使调整更加保守
- 相比之下,GRPO 的 token 级硬裁剪形成一种全有或全无的门控,往往导致脆弱且不稳定的优化行为
强化学习算法的主要区别在于如何处理偏离的离策略 token。从 token 级视角来看,SAPO 提供一种平滑的降权机制;从序列级视角来看,SAPO 抑制序列中极端离策略 token 的梯度,从而构建更有效的训练序列。GRPO 和 GSPO 依赖硬裁剪,其在优化过程中的自适应性不及 SAPO