Positional Encoding
🎥 RoFormer: Enhanced Transformer with Rotary Position Embedding
当前预训练语言模型的自注意力架构本身并不感知位置信息。基于这一认识,研究者提出多种方法,将位置信息引入模型的学习过程
- 一类方法采用绝对位置编码,将通过预定义函数生成的位置编码或通过训练学习的位置编码加到上下文表示中
- 另一类方法则关注相对位置编码,通常将相对位置信息编码到注意力机制中
- Liu et al. 提出从神经常微分方程的角度对位置编码的依赖关系进行建模,Wang et al. 则提出在复数空间中对位置信息进行建模。尽管这些方法取得良好效果,但它们通常以加法形式将位置信息引入上下文表示,因此不适用于线性自注意力架构
旋转位置编码将位置信息引入预训练语言模型的学习过程。利用旋转矩阵编码绝对位置,同时在自注意力的计算形式中显式引入对相对位置的依赖。其核心思想是通过将上下文表示与旋转矩阵相乘来编码相对位置;RoPE 具有多项有益性质,包括序列长度的灵活性、 token 间依赖随相对距离增大而衰减,以及能够为线性自注意力引入相对位置编码
🌿 Rotary Position Embedding
基于 Transformer 的语言建模通常通过自注意力机制利用各个 token 的位置信息。 通常用于实现不同位置 token 之间的信息传递
- 为引入相对位置信息,要求查询向量
 与键向量
 的内积能够由函数
 表示,且该函数仅以词嵌入
 、
 及其相对位置
 作为输入变量。希望内积仅以相对形式编码位置信息
- 最终目标是找到一种等价的编码机制,求得满足上述关系的函数
 和

首先考虑维度为 的简单情形。在这一设定下,利用二维平面上向量的几何性质及其复数表示,可以证明式(1)的一个解为如下形式
-
 表示复数的实部,
 表示
 的共轭复数,
 为预先设定的非零常数。进一步地,可以将
 写成矩阵乘法形式
- 其中,
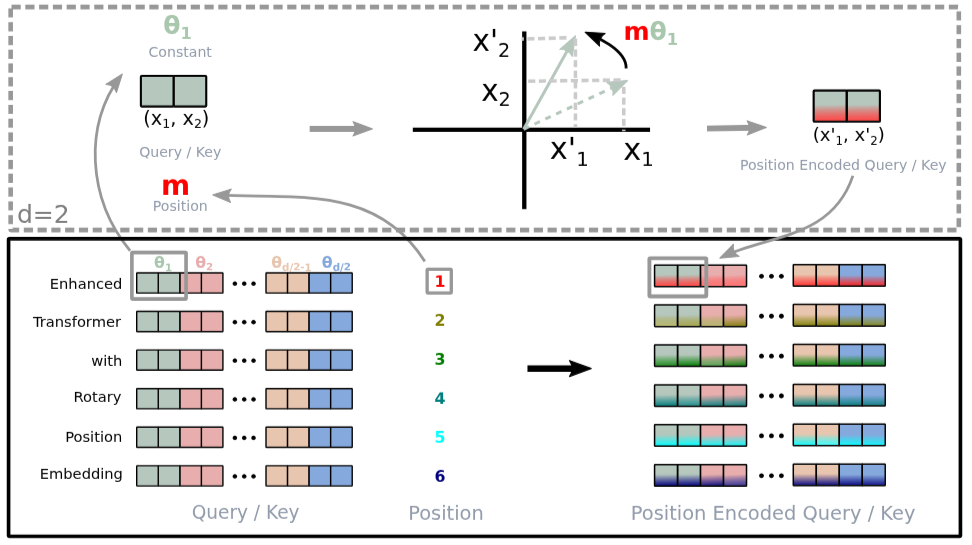
 为的二维坐标表示。具体而言,引入相对位置嵌入的方式十分直接:只需将经过仿射变换的词嵌入向量旋转一个与其位置索引成正比的角度
为将二维情形下的结果推广到任意 ,其中
 为偶数,将维空间划分为
 个子空间,再利用内积的线性性质将其组合起来
- 为旋转矩阵,其预定义参数为
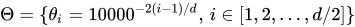 。将 RoPE 应用于标准自注意力机制,可得
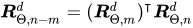
 是正交矩阵,这保证位置信息编码过程的稳定性。此外,由于
 具有稀疏性,直接按照式(6)进行矩阵乘法的计算效率并不高
- 将 RoPE 应用于自注意力时,可以通过旋转矩阵的乘积自然地引入相对位置信息,而无需修改加性位置编码展开式中的各项
RoPE 与线性注意力:自注意力可以改写为更一般的形式
- 原始自注意力采用
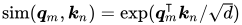 。由于需要为每一对 token 计算查询向量与键向量的内积,原始自注意力具有
 的二次复杂度。线性注意力将式(7)改写为
- 其中,
 和
 通常为非负函数。Katharopoulos et al. 提出采用
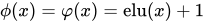 ,并利用矩阵乘法的结合律,先计算键与值之间的乘积。由于 RoPE 通过旋转注入位置信息,并保持隐藏表示的范数不变,因此可以将旋转矩阵与非负函数的输出相乘,从而将 RoPE 与线性注意力结合
旋转矩阵乘法的高效实现:利用式(5)中 的稀疏性,与
 的乘法可以通过如下逐元素乘法高效实现
RoPE 的长程衰减:可以将向量 和
 中的元素两两分组,将式(6)中的内积写成复数乘法形式。下述推导将向量分量与频率统一改为从 0 开始编号
- 其中,
 表示
 的第
 至第
 个元素分别作为实部与虚部组成的复数。记
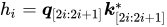 ,
 ,并令
 、
 ,则可以利用 Abel 变换将上述求和改写为
- 当设置
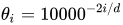 时,
 的值会随着相对距离的增大整体呈衰减趋势,但不保证任意查询与键的内积单调减小
🐦⬛ YaRN: Efficient Context Window Extension of Large Language Models
在执行 NLP 任务时,由训练过程决定的最大序列长度,即上下文窗口,构成预训练大语言模型的主要限制之一。因此,通过少量微调,甚至无需微调,动态扩展上下文窗口的需求日益迫切。围绕这一目标,Transformer 的位置编码成为研究讨论的核心
- 最初的 Transformer 架构采用绝对正弦位置编码,随后改进为可学习的绝对位置编码。此后,相对位置编码方案进一步提升 Transformer 的性能
- 目前,最常用的相对位置编码包括 T5 相对偏置、RoPE、XPos 和 ALiBi
位置编码普遍存在的一项局限是,难以泛化到超出训练阶段所见上下文窗口的序列。尽管 ALiBi 等方法能够实现有限程度的泛化,但尚无方法能够泛化至显著超过预训练长度的序列
- Chen et al. 与同期的 kaiokendev 提出,通过位置插值对 RoPE 进行轻微修改,并结合少量数据微调来扩展上下文长度
- 作为另一种方案,bloc97 考虑高频信息的损失,提出 NTK-aware 插值。此后,研究者又提出两种各有侧重的 NTK-aware 插值改进方法
- Dynamic NTK 插值方法,面向未经微调的预训练模型
- NTK-by-parts 插值方法,在使用少量更长上下文数据进行微调时表现最佳
本文提出 YaRN。这是一种改进的上下文窗口扩展方法,能够高效扩展采用旋转位置编码训练的模型的上下文窗口,在使用不足原始预训练数据量约 0.1% 的数据进行微调后,YaRN 即可在上下文窗口扩展方面达到最先进的性能。同时,通过结合称为动态缩放的推理阶段技术,Dynamic-YaRN 能够在完全无需微调的情况下,将上下文窗口扩展至原来的 2 倍以上
🍄 Background and Related Work
以下以旋转位置编码为基础。考虑一个隐藏层,用 表示该层隐藏神经元的集合。给定向量序列
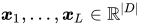 ,注意力层首先将这些向量转换为查询向量和键向量
- 其中,和均视为列向量,因此
 就是欧几里得内积。在 RoPE 中,首先假设
 为偶数,并通过如下对应关系,将嵌入空间及隐藏状态表示为复向量空间
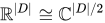
- 此时,内积
 对应于标准厄米内积的实部
 。更具体地,上述同构将交错排列的实部与虚部组合为复数
为将嵌入 、 转换为查询向量和键向量,首先给定如下  -线性算子:
 。令
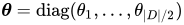 。在复数坐标下,对于任意线性算子
 ,定义
- RoPE 中的函数
 和
 则由下式给出
- 其中,
 ,且
 。通过这种方式,RoPE 为每个复值隐藏神经元关联一个独立的频率
 。这样做的优点在于,查询向量与键向量的点积对位置的依赖仅体现为相对距离
上下文长度插值通常旨在修改式(5)。为统一这些讨论中的表示约定,将修改后的函数 写为如下形式
- 其中,
 是实数之间的映射,而
 则依据函数
 ,以
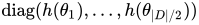 的形式统一作用于对角矩阵
 的各个对角元素
给定预训练阶段的最大上下文长度 ,目标是在进行或不进行微调的情况下,将其扩展为
 。为此,引入缩放因子
 ,定义为

- RoPE 第个隐藏维度对应的波长
 ,定义如下
- 波长表示第个维度的旋转位置嵌入完成一次完整旋转所需跨越的 token 数量
🌿 Yet Another RoPE ExtensioN Method
如果仅从信息编码的角度考察旋转位置编码,Tancik et al. 利用神经切线核理论表明:当输入维度较低,且相应嵌入缺少高频分量时,深度神经网络难以学习高频信息
- token 的位置信息是一维的,而 RoPE 将其扩展为一个
 维复向量嵌入。RoPE 在许多方面与傅里叶特征十分相似,因为 RoPE 可以被定义为傅里叶特征的一种特殊一维形式
- 在位置插值中,由于所有维度均按相同的因子进行拉伸,RoPE 的高频分量会被移除。这种退化会随着缩放因子的增大而加剧;当缩放达到一定程度时,网络将无法恢复。此前采用 PI 进行微调的工作只能将缩放因子提高至大约
 ;进一步扩展时,即使经过微调,大语言模型的输出质量也会开始下降
为缓解这一问题,bloc97 提出 NTK-aware 插值。该方法不再以相同因子缩放 RoPE 的每个维度,而是对高频采用较小幅度的缩放,对低频采用较大幅度的缩放,从而将插值压力分散到多个维度。实现这种变换有多种方式,其中最简单的方法是调整计算 时所使用的底数
- 主要问题是:当希望将上下文窗口扩展至原来的倍时,很难确定应采用的最优底数。NTK-aware 插值的最优底数通常需要通过实验确定,这显著增加获得有效微调模型的难度和成本
RoPE 编码的并不只有相对位置:给定上下文长度,某些维度的波长会超过预训练阶段所见的最大上下文长度,即
- 某些维度的旋转嵌入可能并未均匀分布在整个旋转范围内,也就是说,在完整的训练上下文范围内,这些维度尚未完成一次完整旋转。作者推测,位置对的唯一性意味着这些维度仍然完整保留绝对位置信息。相反,当波长较短时,网络只能从中获取相对位置信息
- 对于仅编码相对位置信息的维度,保持其不变十分重要,因为这些维度对于网络区分相邻 token 的相对顺序至关重要
- 与此同时,对于仅编码绝对位置信息的维度,则应始终采用插值,因为更大的距离会落在训练分布之外
NTK-aware 插值通过调整底数,实际上实现与上述思路相似的效果。据此,可以综合这些观察,构造一种明确且具有针对性的插值方法
- 如果波长
 远小于上下文长度 ,则不进行插值
- 如果波长 等于或大于上下文长度 ,则只进行插值,并避免任何外推;这一点不同于此前的 NTK-aware 方法
- 对于处于两者之间的维度,可以同时包含一定程度的插值与外推,类似于 NTK-aware 插值
引入原始上下文长度与波长之比 会更加方便。该比值表示,在给定的预训练上下文长度内,某个 RoPE 维度完成旋转的次数
- 对于第 个隐藏维度,
 与 的关系为
- 为界定上述不同插值策略的适用范围,额外引入两个参数
 和
 。对于所有满足
 的隐藏维度 ,按缩放因子 进行线性插值,与 PI 完全相同,从而避免任何外推;对于满足
 的维度,则完全不进行插值。定义斜坡函数
 为
NTK-by-parts 插值是基于式(7)对 RoPE 进行的修改,其中采用以下函数
除上述插值技术外,还观察到,在注意力 softmax 之前的 logits 上引入温度  ,会对扩展上下文窗口内的困惑度产生一致的影响,而不依赖于具体的数据样本和 token 位置。具体而言,将注意力权重计算修改为
- 可以采用一种长度缩放技巧,将和同时乘以常数因子
 ,而这只需对复数形式的旋转位置嵌入进行相同幅度的缩放即可实现。通过这种方式,YaRN 无需修改注意力机制的代码,就能有效改变其计算行为
- 温度缩放可并入预先生成并复用的旋转位置嵌入,无需额外增加每次前向传播的缩放运算。将其与 NTK-by-parts 插值结合,即得到 YaRN
🦨 Training-Free Long-Context Scaling of Large Language Models
近期研究表明,通过在长文本序列上进一步训练短上下文模型,可以提升模型的长上下文处理能力
- Llama2 Long 采用长文本数据与原始 Llama2 预训练语料的混合数据进行训练,其优异表现充分验证这一方法的有效性。然而,由于这些训练语料难以获取,且长上下文微调的成本高昂,现有开源模型的性能往往逊于专有模型,同时通常仅提供较小规模的版本
在这些约束下,无需额外训练即可扩展大语言模型上下文的方法尤具吸引力。近期提出的免训练方法,包括 LM-Infinite 和 StreamingLLM,表明在有限上下文窗口上训练的 LLMs 也能够高效处理无限长度的文本
- 这些方法假定 LLMs 无法泛化至超出训练长度的文本,因此通过选择性地保留关键局部信息来处理更长的序列。这类方法能够有效维持较低的困惑度,但会丢失长程依赖关系
为保留全局信息,另一条研究路径是使模型有效外推至超出训练阶段所见长度的序列
- 针对 Llama 系列模型的常用技术,包括位置插值和 NTK-Aware RoPE(NTK),均是对旋转位置编码的改进。与原始 RoPE 相比,这些经过缩放的位置编码所需的微调步数更少,其训练成本还可以通过 YaRN 和 CLEX 等方法进一步降低。在不进行训练的情况下,这些方法通常会导致 PPL 显著升高,尤其当输入长度超过训练长度的两倍时更为明显
本文提出双分块注意力(Dual Chunk Attention,DCA),这是一种用于大语言模型上下文窗口外推的新型免训练框架
- 既不对位置索引进行线性缩小,也不增大 RoPE 中的基频,而是复用预训练模型原有的位置索引及其对应的嵌入,同时重新设计相对位置矩阵的构造方式,以尽可能忠实、准确地表征两个 token 之间的相对位置
- 受高效分块注意力模式的启发,DCA 将长序列的自注意力计算划分为若干小块,每个块的长度均小于预训练上下文窗口的大小
- DCA 包含三个组成部分:(1)块内注意力,用于处理同一块内的 token;(2)块间注意力,用于处理不同块之间的 token;(3)相邻块注意力,用于处理相邻且不同的块之间的 token。这些针对性的处理方式有助于模型有效捕获序列中的长程依赖与短程依赖
外推能力。在语言建模任务上,DCA 为免训练方法带来显著进展。它首次表明,无需训练即可将 LLMs 的上下文窗口从 4k 扩展至超过 32k,同时使 PPL 的增幅保持在可忽略的水平
正交性。DCA 与现有常用的位置编码缩放方法具有正交性,例如 PI 和 NTK。实验表明,原本已支持 32k 上下文窗口的长上下文 LLMs,可以进一步外推至 192k 的上下文长度,同时保持较高的密钥检索准确率和较低的困惑度
🐿️ Dual Chunk Attention
块内注意力模式实际上相当于在块边界处截断左侧上下文,仅保留当前块内的信息,并丢弃此前各块的信息。这种截断通常能够维持较低的困惑度,但会丢失长程信息。为克服这一局限,引入块间注意力,以支持不同块之间的注意力计算,但其对远距离 token 位置的表征精度有所降低。最后,引入相邻块注意力,专门用于两个块相邻的情形,以保留局部性
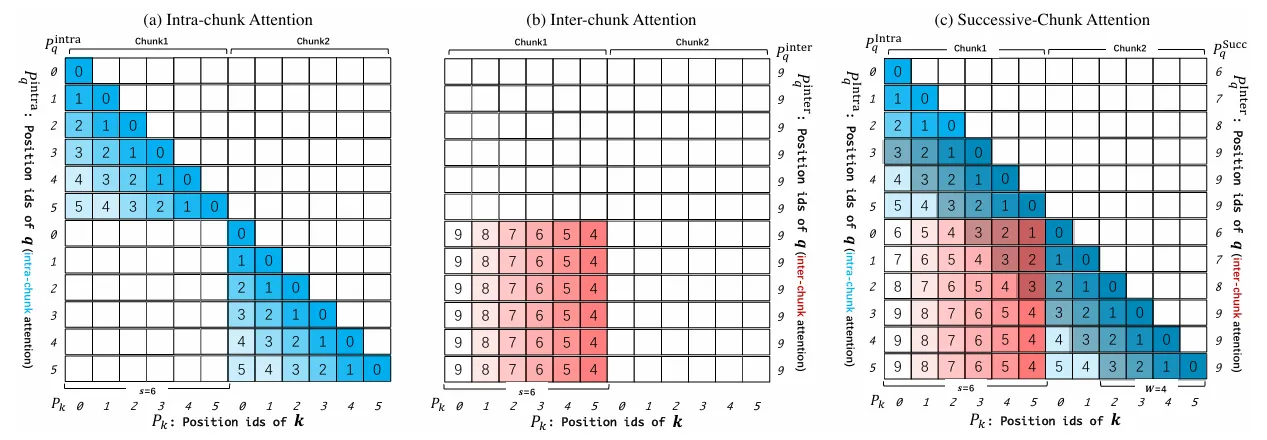
块内注意力用于计算同一块内查询向量与键向量的内积。记  为向量
 在位置
 处应用 RoPE 后的结果
- 对于长度为
 的长序列,将其划分为
 个块,从而确保每个块内的位置索引不超过块大小
- 展示将一个包含 12 个 token、超过预训练长度 10 的序列划分为两个块的过程,其中每个块包含
 个 token。随后,键和查询的位置索引被限制在块大小 6 所对应的范围内。键的位置索引为
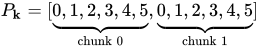 ,且
 ,其中
 表示块内注意力中查询的位置索引。形式化地,在块内注意力中,按如下方式调整查询和键的位置索引
- 对于位于同一块内,即满足
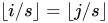 ,且满足
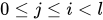 的绝对位置索引
 和
 ,矩阵元素
 定义为查询与键的位置编码之差
- 当时,按照公式(2)计算。随后,第个查询与第个键之间的块内注意力分数计算如下
为聚合其他块中的信息,引入块间注意力
- 在基于 Llama 的大语言模型中,查询的位置索引不小于其所关注的键的位置索引,以体现从左到右的信息流,即当
 时,有
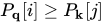
- 若直接使用
 和
 计算不同块之间的注意力,显然会违反这一性质。考虑到 KV cache,保持键的位置索引不变,并为块间注意力寻找一组新的查询位置索引
 ,记为
 。根据公式(1),键的位置索引循环重复,其最大位置索引为
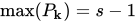
- 为确保查询的位置索引大于此前各块中所有键的位置索引,一种简单策略是为这些远距离查询分配足够大的位置索引,例如预训练阶段的最大位置索引
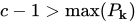 ,其中
 表示预训练上下文长度
- 当
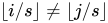 时,对于来自不同块的
 和
 ,相对位置矩阵
 的元素可表示为
相邻块注意力可以视为块间注意力的一种特殊情形,其目的是保持 LLMs 的局部性。局部性是指 LLMs 在预测下一个 token 时往往高度依赖相邻 token。仅使用块间注意力可能无法保持相邻 token 之间精确的相对位置,从而导致性能下降
- 这一问题仅出现在相邻块之间,因此引入新的相邻块注意力来处理这种情况。通过调整
 中每个块的前
 个位置索引,保持个邻近 token 的局部性。给定预训练上下文长度
 、块大小
 ,以及
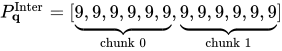 ,若保持大小为
 的局部窗口,则可将位置索引
 设为
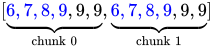 ,用于相邻块之间的注意力计算
- 形式化地,给定块大小、预训练长度和局部窗口大小,有
- 其中,表示局部窗口大小,可直接设为预训练长度与块大小之差

结合块内注意力、块间注意力和相邻块注意力,最终按如下方式计算
DCA 使用 softmax 将缩放后的查询与键内积归一化为注意力权重。DCA 中的内积计算已在公式(8)中给出形式化定义。令  为查询与键向量的维数,使用 softmax 函数对缩放后的内积进行归一化