Chain of Thought
🍀 ReAct: Synergizing Reasoning and Acting in Language Models
人类智能的一个独特特征在于,能够将面向任务的行动与言语推理无缝结合。相关理论认为,言语推理在人类认知中发挥着重要作用,使人能够进行自我调节或策略制定,并维持工作记忆
- 行动与推理之间的紧密协同,使人类能够快速学习新任务,并且即使处于此前未曾遇到的情境中,或面临信息不确定性,也能够进行稳健的决策或推理
近期研究结果表明,在自主系统中结合言语推理与交互式决策具有可行性。一方面,经过适当提示的大语言模型展现出生成多步推理轨迹的涌现能力,能够据此求解算术、常识和符号推理任务中的问题
- 这种思维链推理本质上仍是一个静态黑箱:模型利用自身的内部表征生成思维,缺乏外部世界的信息支撑,因此其根据环境反馈进行推理或更新知识的能力受到限制。这可能导致推理过程中出现事实幻觉和错误传播等问题
- 另一方面,近期研究探索利用预训练语言模型在交互环境中进行规划与行动的方法,重点在于通过语言先验预测行动。这些方法通常将多模态观测转换为文本,利用语言模型生成特定领域的行动或计划,再通过控制器进行选择或执行。然而,这些方法并未利用语言模型围绕高层目标进行抽象推理,也未利用语言模型维持工作记忆以支持行动
ReAct 是一种利用语言模型结合推理与行动的通用范式,用于解决多样化的语言推理与决策任务
- ReAct 通过提示,使大语言模型以交替方式生成与任务相关的言语推理轨迹和行动。这使模型能够通过动态推理来创建、维持并调整指导行动的高层计划,即通过推理指导行动;同时,模型也能够与外部环境交互,将额外信息纳入推理过程,即通过行动辅助推理
- 这是一种基于提示的新范式,通过协同语言模型中的推理与行动来解决一般性任务
- 将 ReAct 扩展到更多任务上的训练与应用,并将其与强化学习等互补范式相结合,有望进一步释放大语言模型的潜力
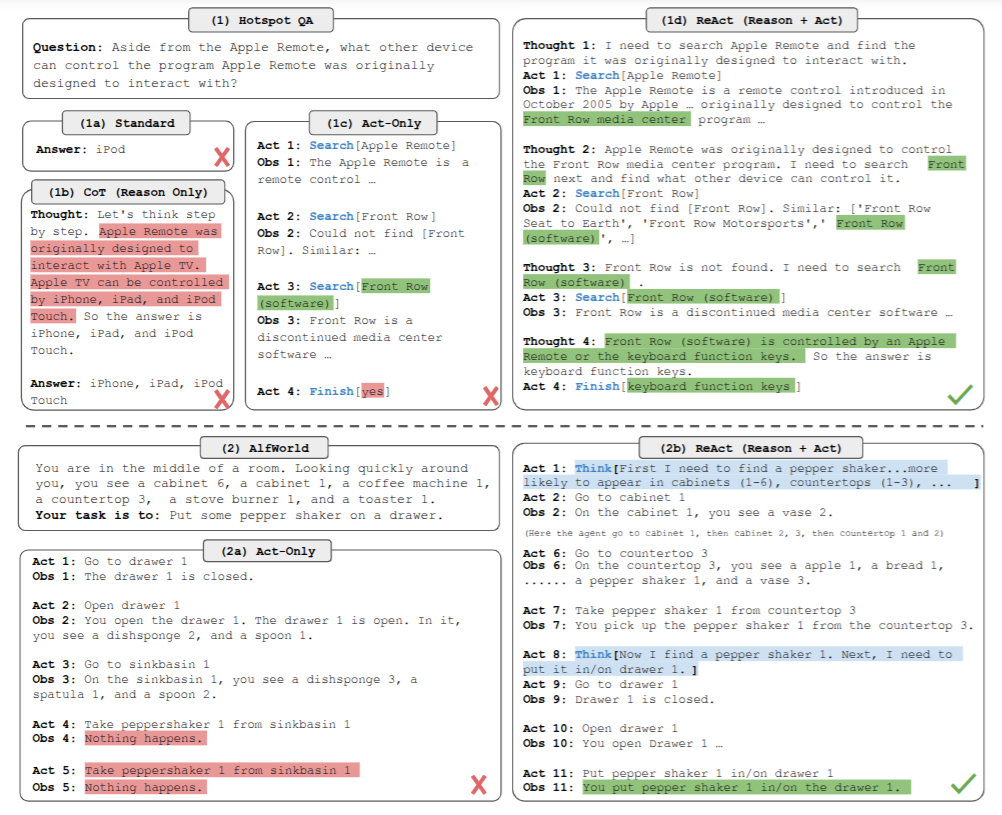
🌟 ReAct: Synergizing Reasoning + Acting
考虑智能体通过与环境交互来解决任务的一般设置。在时间步 ,智能体从环境中接收观测
 ,并按照某个策略
 采取行动
 ,其中
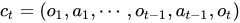 表示智能体的上下文。当映射
 具有较强的隐含性,且需要大量计算时,策略学习便具有挑战性
- ReAct 的核心思想十分简单:将智能体的行动空间扩展为
 ,其中
 表示语言空间。语言空间中的行动
 被称为思维或推理轨迹,它不会影响外部环境,因此也不会产生观测反馈
- 相反,思维
 旨在通过对当前上下文
 进行推理来组织有用的信息,并将上下文更新为
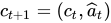 ,以支持后续推理或行动
- 有用的思维可以具有多种形式:分解任务目标并制定行动计划;引入与任务求解相关的常识知识;从观测中提取重要信息;跟踪进展并切换行动计划;处理异常情况并调整行动计划等
对于以推理为主的任务,交替生成思维与行动,使任务求解轨迹由多个思维—行动—观测步骤构成。相比之下,对于可能涉及大量行动的决策任务,思维只需稀疏地出现在轨迹中最相关的位置,因此让语言模型自行决定思维与行动各自出现的时机。由于将决策能力与推理能力整合到同一个大语言模型中,ReAct 具有以下几项独特性质
- ReAct 示例可直接在行动序列中加入自然语言思维。人工标注者只需在所采取的行动基础上,用语言写下自己的思维
- 灵活的思维与行动组织使 ReAct 适用于多种任务。得益于灵活的思维空间,以及思维与行动的灵活组织形式,ReAct 能够适用于行动空间和推理需求各不相同的多种任务,包括但不限于问答、事实核验、文本游戏和网页导航
- 少量上下文示例即可使 ReAct 泛化到新的任务实例。ReAct 仅通过 1~6 个上下文示例进行学习,就能对新的任务实例展现出较强的泛化能力,并在不同领域中持续优于仅进行推理或仅采取行动的基线方法
- 显式思维轨迹便于人类检查并纠正智能体行为。ReAct 能够提供可解释的序贯决策与推理过程,使人类可以方便地检查推理与事实的正确性。此外,人类还可以通过编辑思维内容,在运行过程中控制或纠正智能体的行为
🌳 Tree of Thoughts: Deliberate Problem Solving with Large Language Models
人类在决策时具有两种模式:一种是快速、自动且无意识的模式,即系统 1;另一种是缓慢、审慎且有意识的模式,即系统 2
- 语言模型所进行的简单、联想式的 token 级选择,同样令人联想到系统 1。引入更为审慎的系统 2 规划过程,可能有助于增强语言模型的能力
- 规划过程应当维护并探索当前决策的多种候选方案,而非仅选择其中一种;评估当前状态,并主动进行前瞻或回溯,以作出更具全局性的决策
提出思维树(Tree of Thoughts,ToT)框架,用于借助语言模型进行通用问题求解
- ToT 主动维护一棵思维树,其中每个思维单元都是一段连贯的语言序列,用于表示问题求解过程中的一个中间步骤。借助这种高层语义单元,语言模型能够通过同样以语言形式实现的审慎推理过程,自行评估不同中间思维单元在解决问题方面取得的进展
- 通过语言模型的自我评估与审慎推理来实现搜索启发式,是一种新的方式,因为以往的搜索启发式要么通过编程实现,要么通过学习获得
- 将这种基于语言生成和评估多样化思维的能力,与广度优先搜索或深度优先搜索等搜索算法相结合,从而通过前瞻与回溯,对思维树进行系统性探索
🦉 Tree of Thoughts: Deliberate Problem Solving with LM
真正的问题求解过程,需要反复利用已有信息展开探索,而探索又会揭示更多信息,直至最终发现获得解答的方法。关于人类问题求解的研究表明,人们会在组合问题空间中进行搜索。这一空间可以表示为一棵树,其中节点代表部分解,分支则对应于修改这些部分解的算子
- 选择哪条分支由启发式策略决定,这些策略帮助求解者在问题空间中进行探索,并引导其逐步找到解答
- 这一视角揭示现有语言模型通用问题求解方法的两个关键不足:在局部层面,它们不会在同一思维过程中探索不同的后续路径,即树中的不同分支;在全局层面,它们没有引入规划、前瞻或回溯机制,以帮助评估这些不同选项,而这种由启发式引导的搜索似乎正是人类问题求解的重要特征
思维树这一范式允许语言模型围绕思维单元探索多条推理路径。ToT 将任意问题建模为树上的搜索,其中每个节点对应一个状态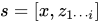 ,其中
 为问题输入,
 为已有的思维序列,二者共同表示一个部分解。ToT 的具体实现需要回答四个问题:(1)如何将中间过程分解为思维步骤;(2)如何从每个状态生成候选思维;(3)如何以启发式方式评估状态;(4)采用何种搜索算法
思维分解依据任务特性划分中间推理步骤。CoT 连续采样思维序列,而不显式规定其分解方式;ToT 则利用问题本身的特性,设计并划分中间思维步骤
思维生成器 :记
 为语言模型。给定树中的状态,考虑以下两种策略,为下一个思维步骤生成
 个候选
- 利用 CoT 提示独立同分布地采样思维。 该策略用于创意写作任务
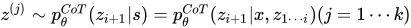 当思维空间较为丰富时,例如每个思维单元都是一个段落,这种方式表现更好,因为独立同分布采样能够带来多样性
- 利用提议提示(propose prompt)依次提出思维。
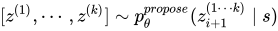 当思维空间受到较强约束时,例如每个思维单元仅为一个单词或一行内容,这种方式表现更好,因为在同一上下文中提出不同思维能够避免重复
get_proposalsGitHub def get_proposals(task, x, y): propose_prompt = task.propose_prompt_wrap(x, y) proposals = gpt(propose_prompt, n=1, stop=None)[0].split('\n') return [y + _ + '\n' for _ in proposals]
状态评估器  :给定搜索前沿的状态集合
 ,状态评估器评估各状态在问题求解方面取得的进展,并将其作为搜索算法的启发式依据,以确定应当继续探索哪些状态,以及按何种顺序进行探索
- 尽管启发式策略是解决搜索问题的常用方法,但它们通常要么通过编程实现,要么通过学习获得。提出第三种选择,即利用语言模型对状态进行审慎推理。在适用的情况下,这种基于审慎推理的启发式策略可以比预先编写的规则更加灵活,并且比通过学习获得的模型具有更高的样本效率。与思维生成器类似,考虑两种状态评估策略,分别对状态进行独立评估或联合评估
- 独立评估各个状态的价值。模型根据状态生成评分
 ,或生成可映射为分值的类别
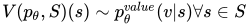
get_valueGitHub def get_value(task, x, y, n_evaluate_sample, cache_value=True): value_prompt = task.value_prompt_wrap(x, y) if cache_value and value_prompt in task.value_cache: return task.value_cache[value_prompt] value_outputs = gpt(value_prompt, n=n_evaluate_sample, stop=None) value = task.value_outputs_unwrap(x, y, value_outputs) if cache_value: task.value_cache[value_prompt] = value return value - 在多个状态之间进行投票。模型比较候选状态后选出
 ,指示函数对选中状态取 1,对其他状态取 0
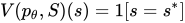
get_votesGitHub def get_votes(task, x, ys, n_evaluate_sample): vote_prompt = task.vote_prompt_wrap(x, ys) vote_outputs = gpt(vote_prompt, n=n_evaluate_sample, stop=None) values = task.vote_outputs_unwrap(vote_outputs, len(ys)) return values
搜索算法在候选思维构成的树上探索推理路径。在 ToT 框架中,可以根据树的结构,以即插即用的方式采用不同的搜索算法
- 广度优先搜索(BFS)。 该算法在每一步维护由
 个最有希望的状态组成的集合
- 深度优先搜索(DFS)。 该算法优先探索最有希望的状态,直至得到最终输出,或者状态评估器认为无法从当前状态
 出发解决问题,即对于给定的价值阈值
 ,有
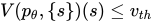 。在后一种情况下,以为根的子树会被剪枝,以减少探索并侧重利用。在这两种情况下,DFS 都会回溯至的父状态,继续进行探索
🛸 Chain-of-Thought Reasoning Without Prompting
大语言模型已在多种复杂推理基准上展现出卓越的性能。这些推理能力通常通过提示技术加以激发,具体包括
- 使用包含中间步骤的示范样例进行少样本提示,或者通过特定指令要求模型展示某些中间步骤,从而实现零样本提示
- 另一种激发大语言模型推理能力的常用策略,是利用大量思维链推理数据进行模型训练或指令微调
- 尽管提示技术行之有效,但它们通常包含针对特定任务的人类先验,从而使语言模型内在推理能力的评估变得困难。理想情况下,一个训练充分的语言模型应当能够独立推理并给出最优回答,而无需在初始回答不令人满意时,由人类调整提示或反复进行修正
本文从另一种视角出发,提出以下问题:大语言模型能否在无需提示的情况下进行有效推理?它们的推理能力又能达到何种程度?
- 作者发现,仅通过改变解码过程,就能够以一种与任务无关的方式,从预训练大语言模型中激发出 CoT 推理
- 对于给定的推理问题,大语言模型沿标准贪心解码路径生成错误答案;然而,通过考察其他 top-k 候选 token,可以发现模型内在的 CoT 路径,例如解码路径 2 和 4,而这些路径能够正确解决该问题。这种解码调整不依赖提示技术,完全以无监督方式进行,也无需对模型进行微调
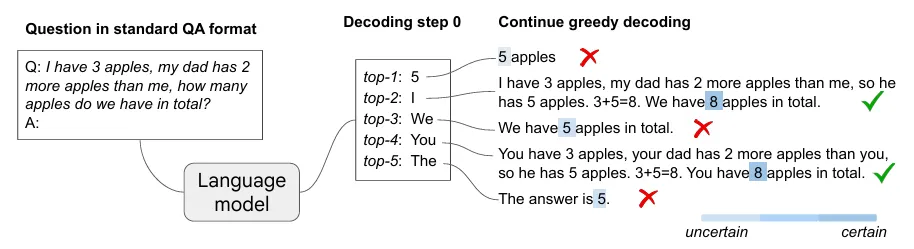
采用标准问答格式组织输入,即 Q: [question]\nA:,不添加思维链示例或逐步推理指令。仅依赖贪心解码路径时,大语言模型往往难以有效推理
- 当考虑 top-k 候选 token 对应的其他路径时,CoT 推理模式会自然地出现在大语言模型的解码轨迹中
- 当解码过程中存在 CoT 推理路径时,模型对最终答案会表现出更高的置信度。利用这一现象,设计一种从 top-k 解码路径中进行筛选的方法,称为 CoT-decoding,选择答案置信度最高的路径作为模型输出
提出一项新的发现:无需使用提示,仅通过简单地调整解码过程,大语言模型便能够进行推理。以往研究主要关注如何改进提示,以激发大语言模型的推理能力;本文首次表明,仅通过简单的解码调整,就能够直接激发推理过程
能够在不引入人类先验的情况下,更好地理解大语言模型的内在推理能力。复杂的提示技术往往引入多种人类先验,使得难以区分模型的表现有多大程度来自人类教学,又有多大程度来自模型自身的独立推理
进一步提出 CoT-decoding,依据答案置信度可靠地选择 CoT 路径。当解码路径中包含 CoT 时,语言模型对最终答案的置信度会提高。利用这一置信度提升现象,提出 CoT-decoding,以选择更可靠的解码路径。该方法在多种推理基准上均显著优于贪心解码
⚓ Chain-of-Thought (CoT) Decoding
预训练语言模型无需提示即可进行推理:考察预训练语言模型是否在不依赖显式提示或人工干预的情况下,具备内在的推理能力
在本文考察的任务中,仅依赖贪心解码路径往往难以展现模型的推理能力。首先,作者观察到,采用贪心解码时,模型的输出往往不包含 CoT 路径,而是直接求解问题
- 这种倾向可能源于模型对问题难度的认知偏差,而这种偏差又与其预训练过程中接触的问题以较简单的问题为主有关
- 模型倾向于立即给出解答。这一观察与已有研究的发现一致:即使对于大语言模型,要求直接作答的提示通常也会导致其在推理任务上的准确率较低
如果考虑其他解码路径,大语言模型便能够进行推理。相比之下,当在第一个解码步骤中探索其他 top-k 候选 token 时,会出现一个有趣的现象:从这些 token 出发继续执行贪心解码,在许多情况下能够自然地呈现出 CoT 推理。大语言模型在预训练后已经具备完成多种任务所需的内在推理能力,但由于贪心解码占据主导地位,这些能力未能显现。通过引入其他解码路径,可以较为容易地发现这些推理路径
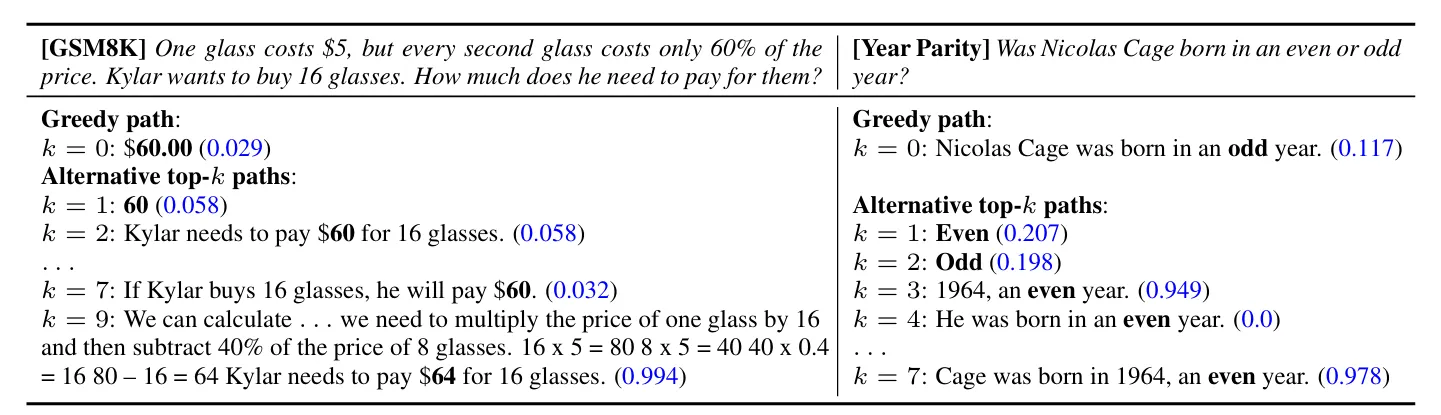
作者观察到,在模型的概率评估中,CoT 路径并不总是排在非 CoT 路径之前。此外,CoT 路径给出的答案往往也不是所有路径中出现次数最多的答案,因此,自一致性等方法在此情形下并不适用
- 通过考察模型的 logits,作者发现,CoT 路径的存在通常会使模型在解码最终答案时具有更高的置信度,具体表现为概率最高与次高的两个 token 之间存在显著的概率差异

- 其中,
 和
 分别表示第条解码路径在第 个解码步骤中,词表内经 softmax 后概率最高和次高的两个 token ;
 表示最终答案包含的 token 数,置信度仅对这些答案 token 的概率差取平均
- 作者将这一方法称为 CoT-decoding,用于从模型生成的解码路径中提取 CoT 路径。如表所示,每条解码路径均以蓝色标注其对应的
 值,答案 token 则以粗体显示。可以明显看出,相较于不包含 CoT 的路径,包含 CoT 的路径具有显著更高的值,表明模型具有更高的置信度
标准问答格式下的采样。CoT-decoding 在第一个解码步骤中探索其他候选 token 。由此自然产生一个问题:采样能否实现类似的效果,从而发现 CoT 推理路径?作者发现,尽管采样在少样本 CoT 提示下表现良好,但在不使用这些提示时,它并未表现出预期的行为
- 在不使用 CoT 提示的情况下,CoT-decoding 的样本效率显著高于自一致性等基于采样的方法
- 采样效果不佳的原因在于,模型的概率分布偏向于直接作答的 token ,因此,与 CoT-decoding 相比,采样得到的首个 token 往往缺乏多样性。相比之下,CoT-decoding 通过在第一个解码步骤中显式促进多样性来发挥作用
在其他解码步骤中进行分支。 另一个自然的问题是,相较于仅在第一个解码步骤中进行分支,能否在后续解码阶段进行分支。在较早阶段进行分支,例如在第一个解码步骤中进行分支,能够显著提高潜在路径的多样性。相反,较晚阶段的分支会受到先前已生成 token 的显著影响,最合适的分支位置仍与具体任务有关
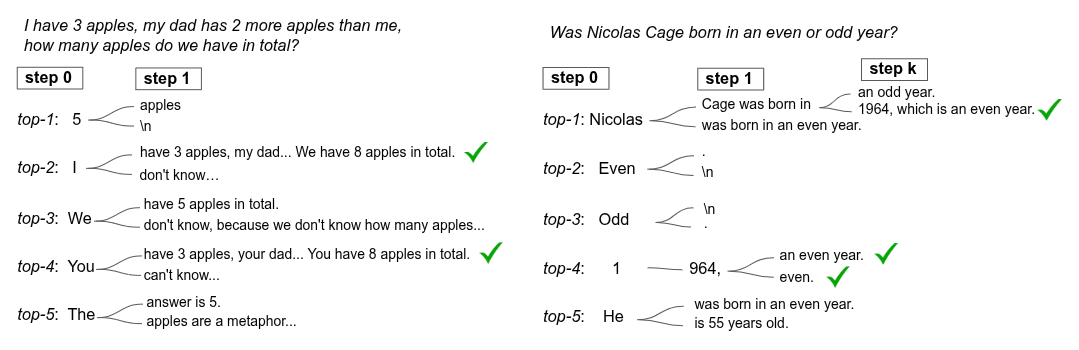
margins 记录各位置 top-1 与 top-2 token 的概率差;locate_answer 按任务规则返回最终答案 token 的下标列表。伪代码中,prompt 为 token ID 列表,next_logits 返回完整词表 logits,is_eos 判断终止 token
def cot_decode(prompt, k=10, max_new_tokens=128):
    first_logits = next_logits(prompt)
    best_tokens, best_score = None, float("-inf")
    for first_token in first_logits.topk(k).indices:
        tokens, margins = [], []
        logits, token = first_logits, first_token
        for step in range(max_new_tokens):
            top2 = logits.float().softmax(dim=-1).topk(2).values
            margins.append((top2[0] - top2[1]).item())
            tokens.append(token.item())
            if is_eos(token) or step + 1 == max_new_tokens:
                break
            logits = next_logits(prompt + tokens)
            token = logits.argmax(dim=-1)
        answer_positions = locate_answer(tokens)
        if not answer_positions:
            continue
        score = sum(margins[t] for t in answer_positions)
        score /= len(answer_positions)
        if score > best_score:
            best_tokens, best_score = tokens, score
    return best_tokens
🚀 Chain of Preference Optimization: Improving Chain-of-Thought Reasoning in LLMs
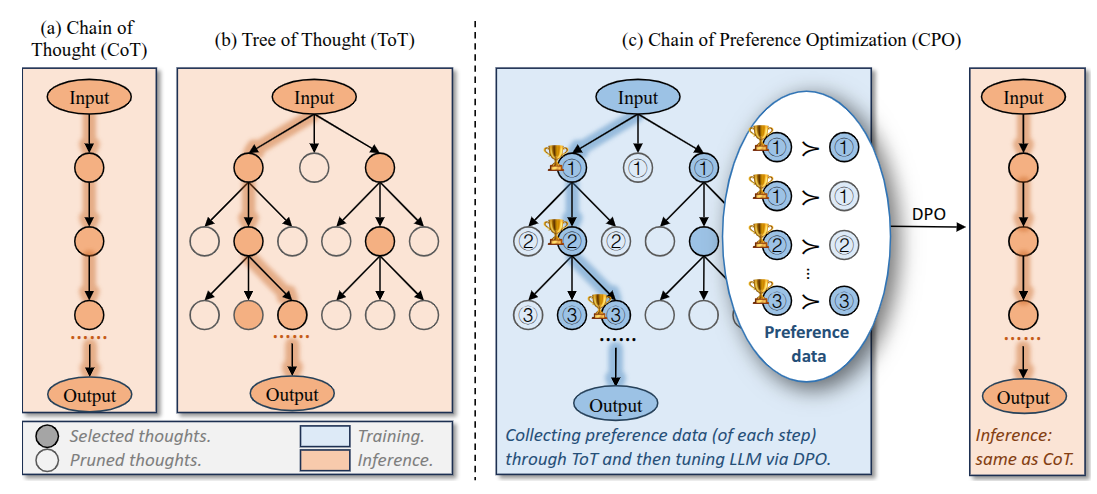
大语言模型的最新研究进展表明,构建推理链对于提升其问题求解能力至关重要。一种具有代表性的方法是思维链,该方法通过提示引导大语言模型生成中间推理步骤,即思维单元,从而构建显式的推理路径
- 尽管这一方法简单直观,但近期研究发现,由于仅关注单条路径,CoT 往往会忽略最优推理路径,并表现出缺乏审慎思考的作答方式
- 为促使模型采用更为审慎且有意识的推理方式,Yao 等人提出思维树。该方法在推理过程的每一步生成多个分支思维单元,并通过自我评估进行剪枝和规划,以搜索推理路径
- 然而,ToT 在提升推理质量的同时,也显著增加计算复杂度,限制其实际应用。这引出一个问题:能否将 ToT 所具备的深层策略性推理能力融入 CoT,在保持效率的同时提升其效果?
一种自然的策略是,将 ToT 为每个样本搜索得到的推理路径作为监督目标,随后微调大语言模型,以提升其 CoT 推理能力。已有多种方法尝试改进这一策略,包括采用蒙特卡洛树搜索等先进的树搜索技术,以及利用外部奖励模型进行剪枝和规划,从而获得更优的推理路径作为监督信号
本文指出上述方法的一项局限:它们忽略树搜索过程中生成的非最优思维单元,而这些思维单元天然蕴含额外的偏好信息
- 具体而言,ToT 在每个推理步骤中都会生成多个候选思维单元,并根据对其质量的评估结果进行剪枝。这一树搜索过程在所有候选中间思维单元之间形成偏好关系:相较于未出现在搜索所得最优推理路径中的思维单元,出现在该路径中的思维单元更受偏好
- 此外,这类信息甚至能够提供比最终找到的最优推理路径更丰富的启示,因为树搜索的每一步都存在非最优推理路径,因而也蕴含相应的偏好关系
链式偏好优化(Chain of Preference Optimization,CPO)受直接偏好优化等相关技术启发,旨在充分利用上述内在偏好信息
- 具体而言,根据 ToT 的搜索树,在每个推理步骤中构建成对的思维偏好数据,随后采用 DPO 算法训练大语言模型,使其与这些偏好对齐
- 思维偏好对的构建遵循上述直觉:在每个推理步骤中,根据思维单元是否包含在 ToT 最终选定的路径中,将其划分为优选思维单元和非优选思维单元。借助这些偏好数据,CPO 使大语言模型能够在推理阶段通过 CoT 解码生成 ToT 所偏好的路径
🍀 Chain of Preference Optimization
ToT 树搜索过程中生成的非最优思维单元能够提供有价值的偏好信息,从而增强大语言模型的推理能力。本方法的一项主要优势在于,仅在训练阶段利用这种监督信号,从而避免较高的推理延迟。方法包含两个组成部分:合成思维偏好链,即以链式形式组织的思维偏好数据,以及基于 CPO 目标进行训练
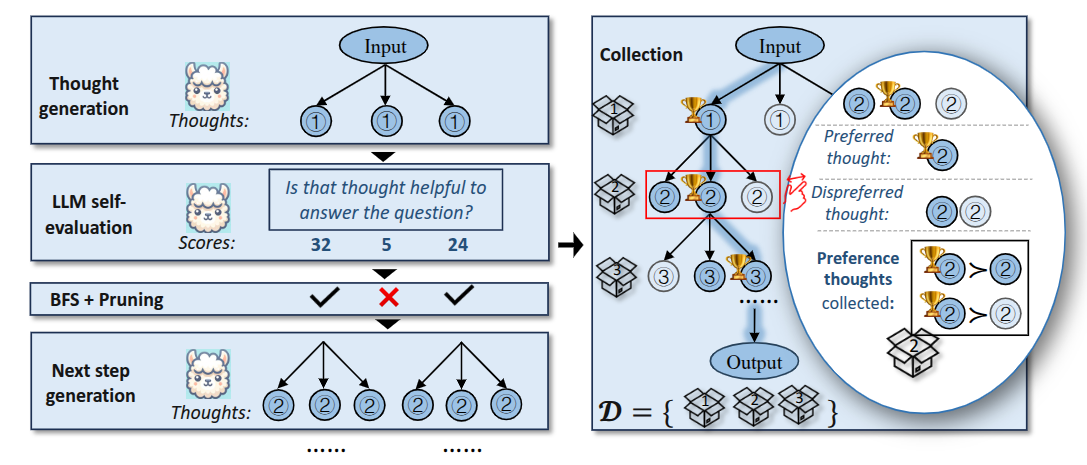
合成和收集思维偏好对的过程紧密遵循 ToT 的推理流程。该流程分为三个部分:思维生成,为每个推理步骤生成多个思维单元;状态评估,对各个思维单元进行评估;搜索与收集,最终确定思维偏好数据
- 思维生成根据当前部分解提出下一步候选。给定状态
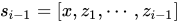 ,该状态由输入
 和截至当前的思维序列
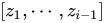 构成,用于表示一个部分解。为下一个推理步骤采样个思维单元
- 状态评估利用语言模型判断候选路径的解题进展。给定不同状态
 ,利用大语言模型对这些状态进行推理,并评估其在解决问题方面取得的进展,无需使用外部奖励模型或人工标注
- 带剪枝的广度优先搜索保留高分路径并逐步扩展。采用带剪枝的广度优先搜索(BFS)来选择推理路径。完成评估后,保留评估分数最高的
 个思维单元,并进入下一步生成。当大语言模型生成的思维单元包含
so the final answer is:时,搜索算法终止并返回选定的路径 - 最终确定推理路径之后,将选定路径中的思维单元标记为优选思维单元。对于第
 步中的每个优选思维单元
 ,构建与之对应的非优选思维单元。首先确定其父状态
 ,该状态包含通向的所有先前思维单元。对于的每个子思维单元,若其未包含在选定路径中,则将其选作相对于的非优选思维单元
 。通过这一过程,为状态构建偏好对

对于第步,给定此前的推理思维状态,生成和的概率分别记为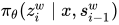 和
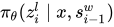 。将该偏好对代入 DPO,得到步骤级损失;再对思维偏好数据集
 取期望,得到总训练目标。式中
 为参考模型,
 控制正则化强度,
 为 sigmoid 函数